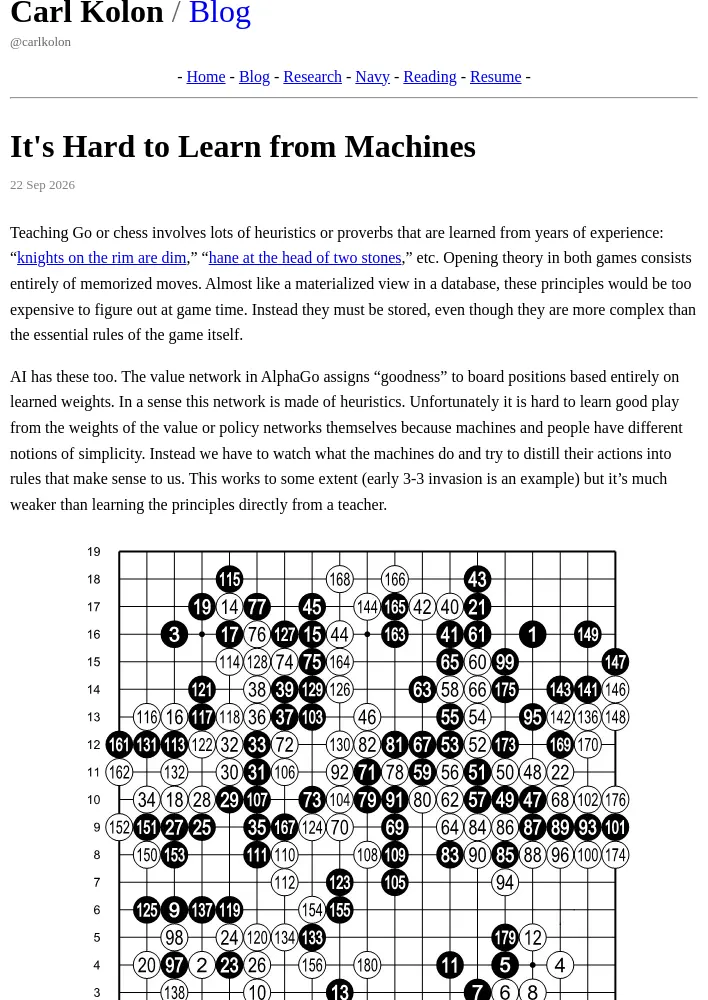
바둑 AI가 둔 수를 보고 인간의 기력이 향상될 수는 있지만, 그 수를 외우는 것과 판단 원리를 이해하는 것은 다르다는 주장이 나왔다. 이 논지는 강화학습으로 학습한 모델에 특정 행동의 이유를 물어도, 그 설명이 실제 판단 과정과 일치한다고 볼 수 있는지 질문한다.
바둑과 체스에는 경험에서 나온 원칙과 외워야 하는 수순이 많다. 글은 이런 원칙이 게임의 기본 규칙보다 복잡하고, 실제 경기 중 새로 계산하기에는 비용이 커서 저장된 지식처럼 기능한다고 설명한다. AlphaGo의 가치망도 학습된 가중치로 바둑판 상태의 가치를 매기므로, 일종의 휴리스틱을 담고 있다.
하지만 기계의 가중치에서 사람이 이해할 만한 원칙을 직접 읽어내기는 어렵다. 사람은 AI의 수를 관찰하고, 그 행동을 자신이 이해할 수 있는 규칙으로 정리해야 한다. 글은 초반 3-3 침입을 그 사례로 들면서도, 이런 방식은 좋은 수를 직접 가르치는 것보다 효과가 약하다고 본다.
글이 인용한 연구 「Human Learning from Artificial Intelligence: Evidence from Human Go Players’ Decisions after AlphaGo」에서 Shin, Kim, Kim은 AlphaGo 이후 인간의 바둑 실력이 향상됐지만 그 변화가 50수 이전에만 나타났다고 보고했다. 글은 이를 AI의 수를 외울 수는 있어도 그 배경 원리까지 내재화하기는 어렵다는 근거로 해석한다.
이 문제는 LLM의 설명에도 이어진다. LLM에 AlphaGo가 특정 수를 둔 이유를 물어도, 해당 모델이 그 판단을 알 근거는 없다는 것이다. LLM 자체가 바둑 강화학습을 거쳤더라도, 생성한 설명이 실제로 수를 선택할 때의 내부 판단을 반영한다고 보장할 수 없다. 글은 모델이 그럴듯한 설명을 만들 수는 있지만, 수를 잘 두도록 추가 학습한 것과 사람에게 검증 가능한 설명을 제공하도록 학습한 것은 다른 과제라고 주장한다.
글의 결론은 바둑에만 한정되지 않는다. 강화학습으로 익힌 다른 작업에서도 모델의 행동을 관찰하는 것과 그 원리를 사람이 이해하는 것은 별개의 문제일 수 있다는 의견이다.
댓글 (0)
로그인하면 이 기사에 내 생각을 남길 수 있어요