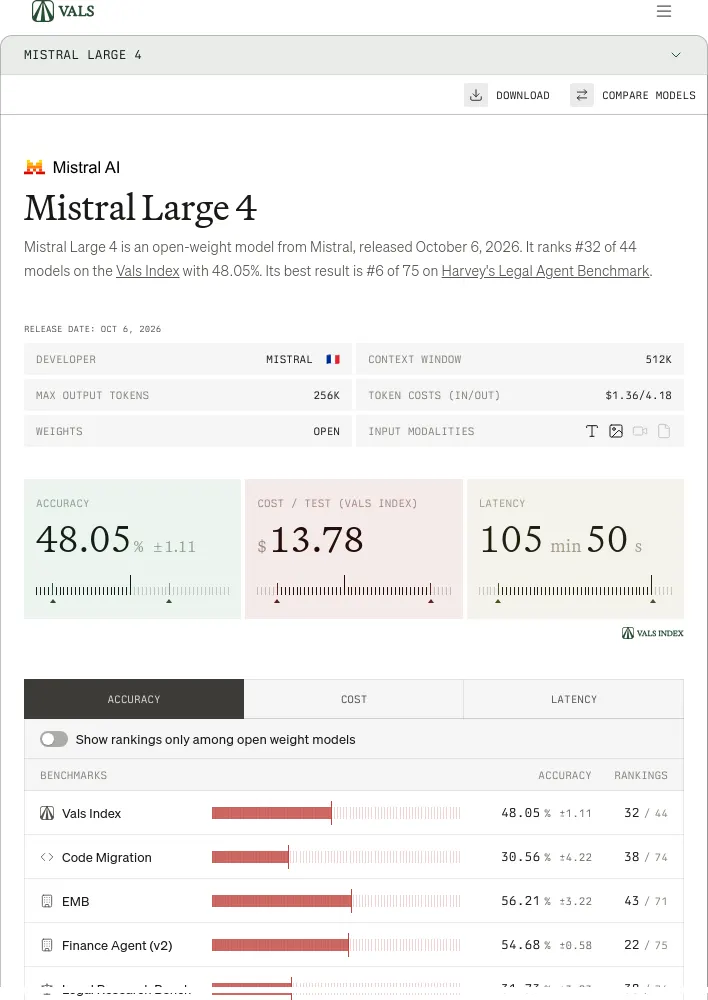
Mistral Large 4는 Vals Index에서 48.05%를 기록해 44개 모델 중 32위에 올랐다. 평가 결과의 오차 범위는 ±1.11이다.
미스트랄이 2026년 10월 6일 공개한 오픈 가중치 모델의 점수와 벤치마크 순위다. 모델 성능 비교를 찾는다면 전체 점수뿐 아니라 과제별 순위와 평가 조건도 함께 볼 수 있다.
Mistral Large 4는 어떤 모델인가?
오픈 가중치는 모델의 학습된 매개변수를 공개해 내려받을 수 있게 한 방식이다. 모델 정보를 비교표에 놓고 보는 일에 빗대면, Mistral Large 4의 점수는 전체 평균에 해당하고 벤치마크별 결과는 과목별 성적에 해당한다.
과제별 점수는 어떻게 나뉘나?
모델은 Harvey's Legal Agent Benchmark에서 75개 중 6위로 가장 높은 순위를 기록했다. 해당 점수는 15.83%다. 그 밖의 결과는 다음과 같다.
| 벤치마크 | 점수 | 순위 |
|---|---|---|
| Code Migration | 30.56% ±4.22 | 38/74 |
| EMB | 56.21% ±3.22 | 43/71 |
| Finance Agent (v2) | 54.68% ±0.58 | 22/75 |
| Legal Research Bench | 31.73% ±3.23 | 38/74 |
| MedCode | 40.69% ±2.17 | 59/105 |
| MedScribe | 80.43% ±2.00 | 55/107 |
| MysteryMechanism | 12.16% ±2.20 | 24/24 |
| ProofBench v1.1 | 10.00% ±3.02 | 42/47 |
| Tax Agent Bench | 63.29% ±3.23 | 25/66 |
| Vibe Code Bench 1-100 | 14.26% ±3.21 | 6/21 |
| Vibe Code Bench v1.1 | 78.40% ±3.55 | 25/109 |
| BioMysteryBench | 67.04% ±2.67 | 17/24 |
| Harvey's Legal Agent Benchmark | 15.83% ±2.96 | 6/75 |
| IOI | 45.28% ±3.78 | 28/41 |
| Terminal-Bench 4.0 | 22.73% ±0.88 | 20/44 |
모델의 문맥 길이는 512k 토큰이고 최대 출력은 256k 토큰이다. 입력·출력 토큰 비용은 각각 $1.36, $4.18이며 테스트당 비용은 $13.78이다. 표시된 지연 시간은 105분 50초다.
점수를 비교할 때 무엇을 확인해야 하나?
기본 제공자는 Mistral AI이며, 기본 설정은 온도 1, Top P 0.95, Top K 기본값, 최대 출력 256,000 토큰, 추론 노력 높음이다. 일부 벤치마크는 제공자나 매개변수가 다를 수 있으므로 해당 벤치마크 페이지의 조건을 확인해야 한다. 원문은 입력 양식과 테스트당 비용·지연 시간의 측정 조건을 구체적으로 밝히지 않는다.
댓글 (0)
로그인하면 이 기사에 내 생각을 남길 수 있어요