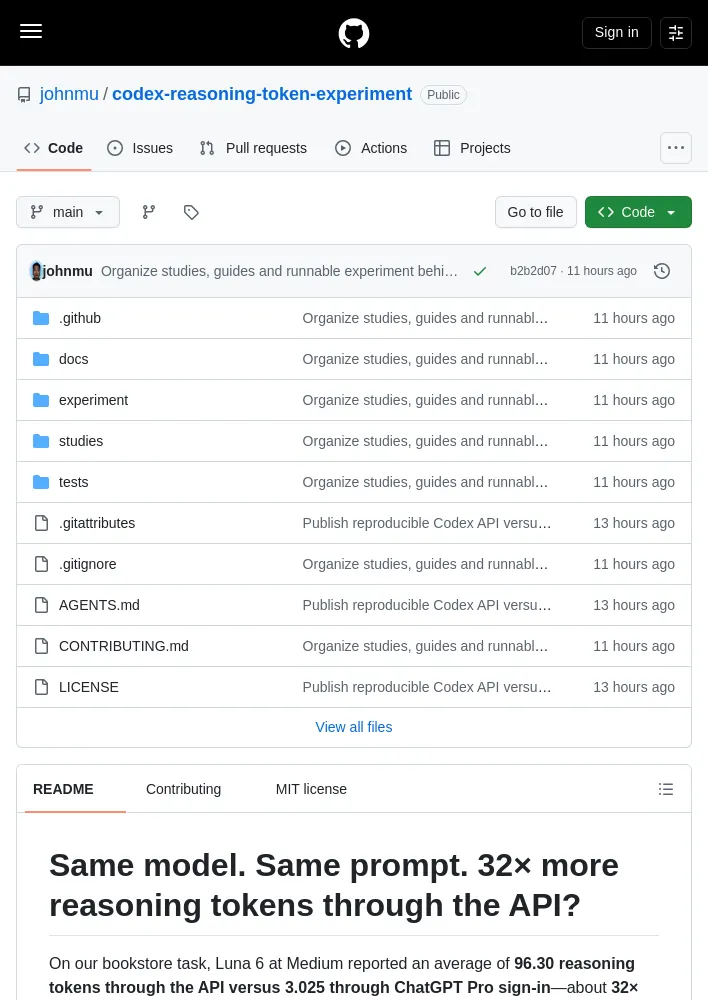
서점 과제에서 Luna 6를 중간 사고 수준으로 설정했을 때 API 응답은 평균 추론 토큰 96.300개, ChatGPT Pro 로그인 응답은 3.025개를 기록했다. 약 32배 차이다. 두 경로 모두 의사결정은 전부 맞혔다.
실험팀은 같은 Codex 클라이언트에서 요청 모델과 사고 수준을 맞춘 뒤, API 키 로그인과 구독 로그인으로 보낸 입력이 바이트 단위까지 같은 조건을 비교했다. 두 경로의 사용량 차이를 재현하고 원인을 찾도록 코드와 답변, 측정치를 공개했다.
무엇을 비교했나?
이 연구는 Codex를 통한 API 접근과 구독 접근의 차이를 살폈다. 각 응답은 새 Codex 세션에서 시작했다. 로컬 프록시(proxy)는 짝을 이룬 요청이 같은 모델 입력을 보내도록 했고, 인증 방식과 서비스 엔드포인트는 두 로그인에서 달랐다.
연구팀은 서버의 답변과 사용량을 기록하고 Codex 자체 기록과 대조했다. 오답도 데이터에서 제외하지 않았다. 프록시는 실제 서버 응답을 바꾸지 않았다.
어떤 차이가 관측됐나?
두 과제는 예산 안에서 프로젝트를 고르는 일과 서점의 중복 이메일을 진단하는 일이었다. Luna 6와 Sol 6.1을 낮음·중간·높음 사고 수준으로 시험했다. 각 과제·모델·수준·로그인 경로 조합마다 응답 40개를 모았다. 처음 수집한 480개에 이어, 별도로 분석하기로 정해 둔 후속 응답 480개를 추가해 총 960개를 분석했다.
서점 과제에서 차이가 두드러진 네 조건은 다음과 같다. 각 수치는 로그인 경로별 완료 응답 40개의 응답당 평균 보고 추론 토큰 수다.
| 모델 | 사고 수준 | API 키 | ChatGPT Pro 로그인 |
|---|---|---|---|
| Luna 6 | 낮음 | 68.550 | 0.000 |
| Luna 6 | 중간 | 96.300 | 3.025 |
| Luna 6 | 높음 | 148.525 | 85.200 |
| Sol 6.1 | 높음 | 216.675 | 138.700 |
이 네 차이는 원래 연구와 후속 연구 모두에서 다중 비교 보정(multiple-comparison correction)을 통과했다. 토큰 수가 많다고 답변이 더 정확한 것은 아니었다. 서점 과제의 의사결정 결과 480세트는 모두 정답이었다.
프로젝트 과제에서는 전체 자료를 합쳤을 때 Luna 6의 낮은 사고 수준 정확도가 API 경로에서 35/40, 구독 로그인에서 18/40이었다. 사전에 정한 보수적 보정을 통과했지만(p = 0.0083), 탐색적 결과로 봐야 한다. 새로 수집한 자료만 보면 각각 19/20과 12/20이었으며, 해당 보정은 통과하지 못했다(p = 0.371).
후속 수집 중 구독 경로에서 용량 부족으로 두 차례 실패했다. 연구팀은 이 두 사례를 보존하고 수동으로 이어서 진행한 과정을 기록했으며, 원래 일정을 완료했다. 통계는 완료된 응답을 대상으로 하며, 중단 상황은 런타임 변경 기록에 설명돼 있다.
결과를 어디까지 믿을 수 있나?
여기서 측정한 것은 서버가 보고한 사용량이지 모델 내부의 추론 예산이 아니다. 비교에는 고정된 프롬프트 두 개와 API 인증 정보 하나, Pro 계정 하나만 쓰였다. 따라서 차이가 얼마나 널리 나타나는지, 원인이 무엇인지는 아직 알 수 없다. 독립적인 반복 실험이 필요하다.
실험팀은 다른 사람의 보고도 관련 자료로 소개했다. Codex 이슈 #49757은 Astra를 Enterprise 로그인과 공개 API로 비교한다. 관련 연구 검토에는 Luna 관련 보고, effort 설정 버그, 서로 다른 결과를 낸 연구가 포함돼 있다. 이 자료들은 조사 단서를 제공하지만 이번 결과의 원인을 확정하지는 않는다.
수치를 다시 계산하려면 Python 3.12 이상이 필요하다. 포함된 데이터만 사용하며 모델을 호출하지 않는다.
python3 -m experiment verify
python3 -m experiment analyze
생성된 보고서는 output/reports/followup/report.md에 저장된다. 연구 색인에서는 공개 보고서, 답변 표, 데이터 안내, 기록된 계획을 찾을 수 있다. 실험을 반복하려는 사람은 설정·실행 안내를, 코드 실행기를 이해하거나 바꾸려는 사람은 코드 안내를 참고할 수 있다. 재현 결과 공유와 코드 개선은 기여 안내에서 다룬다. 가능한 설명을 살펴보려면 조사 계획을, 다른 사람의 결과와 비교하려면 관련 보고서와 상반된 근거를 보면 된다. 저장소는 MIT 라이선스를 적용한다.
원문은 독립 재현 결과나 토큰 차이의 원인을 밝히지 않는다. 계정과 요금제, 측정 시점을 바꾼 반복 실험이 필요하다고 제안한다.
댓글 (0)
로그인하면 이 기사에 내 생각을 남길 수 있어요