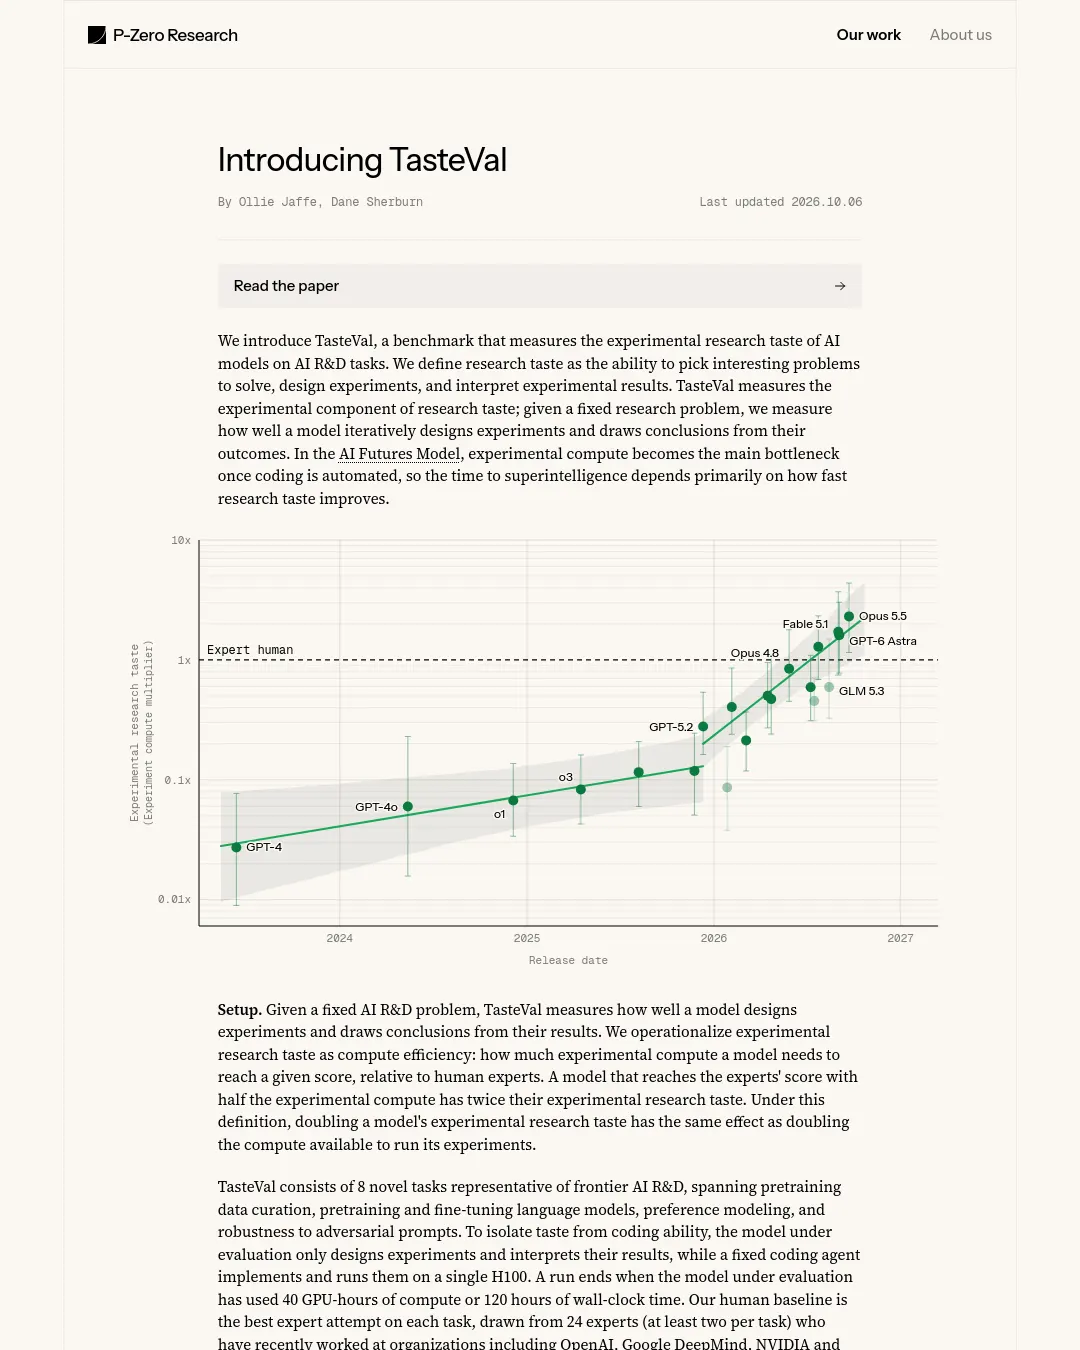
최고 성능 모델 Opus 5.5는 TasteVal에서 전문가 기준 점수에 도달하는 데 전문가보다 적은 실험 연산량을 썼다. 연구진은 이 결과를 계산 효율 기준 2.30배로 측정했다.
올리 재페(Ollie Jaffe)와 데인 셔번(Dane Sherburn)은 AI 연구개발 과제에서 모델의 실험 설계와 결과 해석 능력을 측정하는 벤치마크 TasteVal을 소개했다. AI 모델의 연구 능력을 비교하려는 연구팀이 참고할 수 있지만, 연구진은 이 측정만으로 실제 연구 전반의 역량을 판단할 수 없다고 경고한다.
TasteVal은 무엇을 측정하나?
연구 취향(research taste)은 풀 만한 흥미로운 문제를 고르고, 실험을 설계하고, 결과를 해석하는 능력을 뜻한다. TasteVal은 이 가운데 실험 설계와 결과 해석에 초점을 맞춘다. 실험 과정을 정해진 예산 안에서 목표 점수에 도달하도록 길을 찾는 일에 빗대면 쉽다. 구체적으로는 같은 점수에 도달하는 데 필요한 실험 연산량을 전문가 기준과 비교한다. 전문가 점수에 절반의 연산량으로 도달하면 실험 연구 취향이 두 배라고 정의한다.
벤치마크는 AI 연구개발을 대표하도록 만든 8개 과제로 구성됐다. 사전학습 데이터 선별, 언어 모델의 사전학습과 미세조정, 선호도 모델링, 적대적 프롬프트에 대한 견고성 평가가 포함된다. 모델이 코딩하는 능력과 실험 설계 능력을 분리하기 위해, 평가 대상 모델은 실험을 설계하고 결과를 해석한다. 고정된 코딩 에이전트가 실험을 구현하고 H100 한 대에서 실행한다. 한 번의 평가는 GPU 연산 40시간 또는 실제 시간 120시간이 되면 끝난다.
수치가 보여 주는 것과 한계는?
인간 기준선은 과제마다 최소 두 명씩, 최근 오픈AI·구글 딥마인드·엔비디아·마이크로소프트 리서치 등에서 일한 전문가 24명의 최고 시도 결과다. 연구진은 최전선 모델의 실험 연구 취향이 2025년 12월 이후 3.0개월마다 두 배가 됐다고 추정했다. 95% 신뢰구간은 1.7~5.0개월이다. Opus 5.5의 전문가 대비 연산량 배수는 2.30배이며, 95% 신뢰구간은 1.15~4.37배다. 모델의 시도 한 번에 든 비용은 전문가 기준선 시도의 평균 비용보다 대략 30분의 1이었다.
연구진은 이 추세를 전망이 아닌 단순 외삽으로 AI Futures Project의 AI Futures Model에 적용했다. 연구 취향만으로 특이점에 도달할 확률은 51%에서 88%로, 초지능의 중앙 도달 시점은 2030년 중반에서 2028년 후반으로 바뀌었다. 2030년 전 초지능에 도달할 확률도 46%에서 69%로 높아졌다. 이는 측정된 개선 속도가 유지된다는 가정에 따른 모델 결과이지, 연구진이 제시한 예측은 아니다.
결과는 개선 속도를 실제보다 빠르게 보일 수 있다. 과제는 검증이 빠르고 저렴해 최전선 연구소가 성능을 반복 개선하기 쉬운 유형이며, 인간 기준선에는 세계 최고 수준의 연구자가 포함되지 않아 전문가 역량을 낮게 잡았을 수 있다. 반대로 모델별 평가를 충분히 유도하지 못해 개선 속도를 낮게 측정했을 가능성도 있다. 연구진은 최고 모델에 쓴 시도당 비용이 전문가 평균의 약 30분의 1이었다고 밝혔다. TasteVal은 어떤 연구 문제를 선택해야 가장 유익한지 평가하지 않는다.
모델을 평가할 때는 과제 구성과 연산·시간 한도를 확인해야 한다. 논문은 arXiv에서 확인할 수 있다. 원문은 모델별 평가의 제한적 유도 외에 측정 결과가 다른 연구 과제에서 얼마나 재현되는지 밝히지 않는다.
댓글 (0)
로그인하면 이 기사에 내 생각을 남길 수 있어요