AutoCompact은 SWE-bench Verified에서 통과율을 9.2%포인트, SWE-PolyBench Verified에서 5.0%포인트 높였다. 문맥 창이 넘치지 않는 256K 조건과 강제 압축이 필요한 16K 조건에서 모두 향상이 유지됐다.
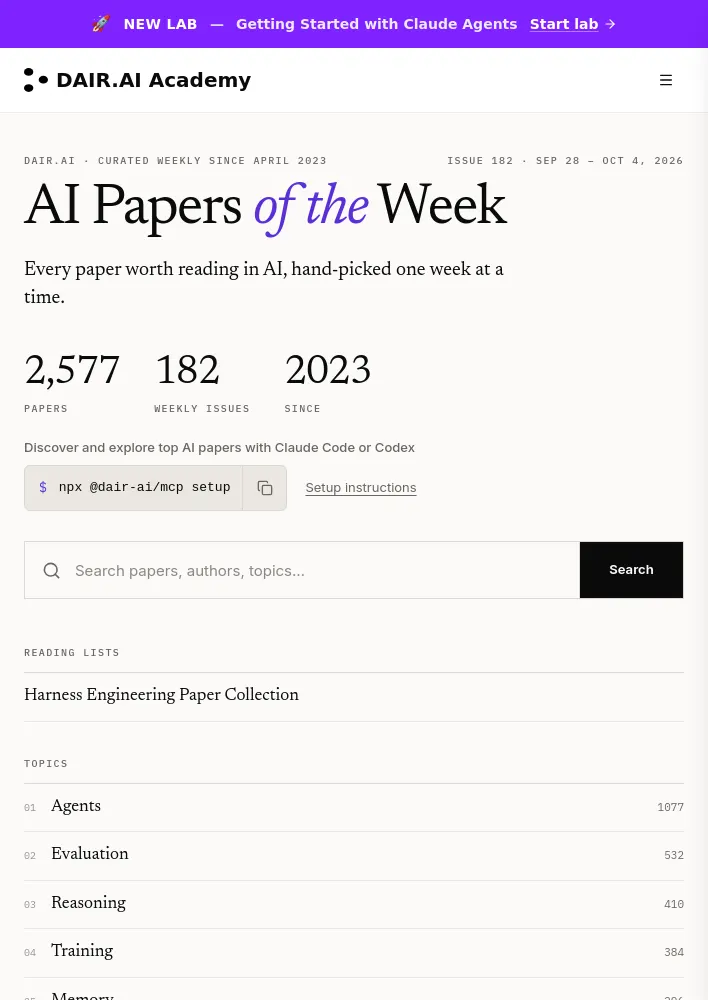
DAIR.AI는 2026년 9월 28일부터 10월 4일까지 나온 AI 논문 10편을 주간호 182호로 묶었다. 2023년 4월부터 매주 논문을 선별해 온 서비스로, Claude Code나 Codex에서 논문을 찾아보는 MCP 도구도 안내한다. AI 에이전트 연구를 살펴보는 독자라면 이번 호의 요약을 통해 관련 논문을 빠르게 비교할 수 있다.
이 도구는 무엇인가?
MCP(모델 컨텍스트 프로토콜)는 AI 도구가 외부 서비스와 연결되도록 하는 규격이다. 책 목록을 검색해 주는 도서관 안내 창구를 떠올리면 쉽다. DAIR.AI는 이 연결을 통해 Claude Code나 Codex에서 AI 논문을 발견하고 탐색할 수 있도록 도구를 제공한다.
이번 호의 대표 논문은 장시간 코딩 작업에서 문맥을 언제 압축하고, 작업 상태 중 무엇을 남기며, 압축 뒤 어떻게 이어갈지 에이전트가 학습하는 방법을 다룬다. 먼저 판정기가 기본 에이전트의 압축 결정을 검토해 잘못된 결정을 실행 전에 바꾼다. 수정된 작업 경로로 지도 미세조정을 한 뒤, 작업 성공률을 높이도록 강화학습을 적용해 코딩과 문맥 압축을 함께 최적화한다. 소개된 성능 향상은 이 연구의 결과로 제시됐다.
나머지 논문도 에이전트 연구에 초점을 맞췄다. Meta 연구진과 협력자들은 모델이 현재 문맥을 파일처럼 직접 수정하고, 남길 정보와 다시 쓸 정보, 지울 정보를 선택하는 Context Language Models를 제안했다. Salesforce AI Research의 Critical-State RL은 여러 차례 도구를 쓰는 과정에서 학습 효과가 있는 호출을 찾아 해당 호출만 학습한다. BFCL v4의 누락 함수 과제에서는 선택한 차례를 학습했을 때 성능이 약 14포인트 올랐고, 다른 차례를 학습하면 정확도는 그대로이거나 떨어졌다.
Amazon AGI 연구진이 소개한 AutoGym은 최소한의 분야 설명이나 이전 모델의 작업 경로를 바탕으로 검증 가능한 에이전트 훈련 환경을 만든다. SkillGym은 사람이 작성한 에이전트 기술을 12개 범주의 검증 가능한 환경 2,756개로 만들고, 성공 작업 경로 8,364개를 수집해 미세조정에 활용했다. Claude Code 환경에서 Qwen3.5-35B-A3B를 미세조정하자 Terminal-Bench 2.1 점수는 19.10포인트, 기술을 활용하는 SkillsBench v1.1 점수는 28.13포인트 올랐으며 후자의 점수는 51.47%였다. 기술을 문맥에 넣지 않은 훈련 모델도 기술을 문맥에 넣은 기본 모델보다 높은 성능을 보였다고 소개됐다.
다른 논문들은 에이전트의 장기 기억과 자기 개선을 에이전트 실행 구조 안에서 다루는 MIT CSAIL의 JAZ, 장기 작업에서 좋은 선택을 내리는 능력을 측정하는 Microsoft 연구진과 협력자의 Taste-Bench를 소개한다. Microsoft 연구진은 에이전트 작업 경로가 이미 있다면 검색 기반 프롬프트 최적화 과정이 필요하지 않을 수 있다고 보였다. Microsoft Research의 Agensh는 중앙 조정자 없이 자체 조직 방식으로 코딩 에이전트 1,024개까지 확장했다. Jev-Mem은 기억의 구성·검색·사용을 결정하는 데 가벼운 제어기를 써서, 매번 생성형 언어 모델을 호출하는 방식의 부담을 줄이려 한다.
논문을 살펴보려면
Claude Code나 Codex에서 도구를 설정할 때는 다음 명령을 안내에 나온 그대로 사용할 수 있다.
npx @dair-ai/mcp setup
이번 호는 10편의 논문을 다루며, 전체 호를 보는 링크도 제공한다. 다만 소개된 내용만으로는 각 논문의 전체 평가 조건과 비교 대상, 독립적인 재현 여부를 확인할 수 없다. 도구의 이용 조건이나 가격도 밝히지 않았다.
댓글 (0)
로그인하면 이 기사에 내 생각을 남길 수 있어요