설치 과정에서 자동 학습을 허용하면 Claude 계정으로 학습 한 차례에 약 0.25달러가 들고, 하루 비용은 최대 1달러다. Singularity는 과거 Claude Code 작업에서 반복되는 절차와 실수를 익혀 다음 작업에 전달한다.
pandacover가 공개한 오픈소스 도구 Singularity는 코딩 에이전트가 저장소별 작업 기억을 활용하도록 돕는다. 비슷한 일을 반복하는 개발자라면 에이전트가 매번 같은 위치와 확인 절차를 다시 찾는 일을 줄이는 데 쓸 수 있다.
Singularity는 무엇을 기억하나?
Singularity는 코딩 작업의 절차를 모으는 공책에 빗대면 이해하기 쉽다. 저장소에서 성공적으로 끝난 작업을 기록하고, 변경 위치와 확인 방법, 작업 도중의 실수와 해결 과정을 정리해 다음 작업 때 에이전트에 건넨다.
기록은 Claude Code 세션에서 변경 사항을 커밋하고 테스트를 통과한 작업을 바탕으로 만든다. 기록이 쌓이면 작업 종류별 흐름과 선택적 단계의 조건, 주의 사항을 학습한다. 기억에는 코드 자체를 저장하지 않고, 작업 당시 수정된 코드 주변을 가리키는 위치 정보를 둔다. 다음 작업 때는 그 위치를 현재 코드에서 다시 찾아 전달한다.
과거 기록에서 뽑은 주장은 해당 커밋의 코드와 작업 로그에 대조한다. 근거가 맞지 않으면 버린다. 기억을 새로 만들 때는 과거 작업을 재생해 필요한 절차만 전달하는지 점검하며, 요청하지 않은 단계가 들어가면 후보 기억을 거부한다.
설치하면 어떤 에이전트에서 작동하나?
macOS, Linux, WSL, Git Bash에서는 설치 스크립트를 실행한다. Windows PowerShell에서는 별도의 명령을 쓴다.
curl -fsSL --connect-timeout 10 https://raw.githubusercontent.com/pandacover/singularity/main/install.sh | sh
irm https://raw.githubusercontent.com/pandacover/singularity/main/install.ps1 | iex
Git이 필요하다. PATH에 Node.js 24 이상이 없으면 설치 프로그램이 자체 사본을 ~/.singularity/node에 내려받는다. 내려받은 파일은 nodejs.org의 체크섬으로 확인하며, 그 밖의 항목은 변경하지 않는다고 안내한다. 기억을 학습하려면 Claude Code도 필요하다. WSL은 Windows와 에이전트 설정을 공유하지 않으므로 Windows에서 실행하는 에이전트에는 Windows PowerShell 명령을 따로 실행해야 한다.
설치 프로그램은 singularity 명령을 PATH에 추가하고 에이전트 설정을 안내한다. Claude Code, Codex, Gemini CLI, Droid에는 작업 시작 시 기억을 전달하고 작업 중 주의 사항을 알리는 훅과 기술(skill)을 설정한다. Codex에서는 /hooks에서 훅을 한 번 신뢰해야 한다. Cursor, OpenCode 등 ~/.agents/skills를 읽는 에이전트에서는 요청할 때 기술을 이용할 수 있다.
설치 과정은 변경하는 설정 파일의 사본을 <file>.before-singularity로 남긴다. 에이전트 설정의 나머지 부분은 건드리지 않는다고 설명한다. 자동 학습 허용 여부도 묻는다. 학습 기능의 비용은 Claude 계정으로 회당 약 0.25달러이며 하루 최대 1달러다.
기억은 어떻게 전달되고 갱신되나?
기억은 ~/.singularity 또는 $SINGULARITY_HOME에 저장된다. 저장소는 루트 커밋과 원격 저장소를 기준으로 식별하므로 같은 저장소의 복제본은 같은 대상으로 취급한다. 설정을 다시 실행하거나 현재 상태를 확인하고, 기억을 조회·학습·삭제할 수 있다.
singularity status # which agents have memory, and what it knows per repo
singularity recall "<task>" # what a task here would be handed (no model call)
singularity learn [--past] # learn now; --past starts from this repo's earlier sessions
singularity setup # again, to update or change your answers
singularity uninstall [--purge] # take memory out of every agent (memory stays unless --purge)
저장소에서 작업이 시작되면 훅이 작업 흐름과 관련된 경고를 첫 프롬프트에 전달한다. 로컬 우선 방식에서는 작업 내용과 기억에 적힌 단서를 대조해 흐름을 고르며, 모델 호출 없이 처리할 수 있다. 모델을 써서 고르는 설정도 있다. 작업 도중에는 정확한 경고 조건이 나타나면 해당 경고를 세션당 한 번 전달한다. 커밋과 테스트를 마친 세션은 새 기록이 된다.
훅이 전달하는 내용은 10,000자 이내다. SINGULARITY_HOOKS=off로 훅을 끌 수 있으며, 평가 도구는 측정 작업에 설치된 훅이 끼어들지 않도록 이 설정을 사용한다. 기억을 삭제하지 않고 에이전트에서 분리하려면 singularity uninstall을 쓰고, --purge를 붙이면 기억도 지운다.
평가와 사용 전에 확인할 점은?
저장소에는 평가 기능도 들어 있다. 평가 도구는 작업마다 기준 커밋, 프롬프트, 성공 여부를 판정하는 검사 명령을 지정한다. 실행은 기준 커밋의 깨끗한 복제본에서 이뤄지며 원본 저장소를 수정하지 않는다. 숨겨진 테스트를 작업 에이전트가 미리 보지 못하게 하는 옵션도 있다. 결과에는 비용, 토큰 수, 경과 시간, 도구 호출, 검사 결과를 기록하고 대화 기록과 변경 사항도 저장한다.
기억 설정은 과거 성공 작업을 프롬프트 유사도로 찾는 방식, 절차 그래프, 절차 그래프의 경고만 더하는 방식, 훅으로 전달하는 방식 등으로 나뉜다. 평가용 설정에는 작업 시작 때 모델이 절차를 고르는 방식과 단서를 이용해 모델 호출 없이 고르는 방식도 있다. 기억을 측정할 때는 --frozen을 추가해 평가 도중 기억이 바뀌지 않게 할 수 있다.
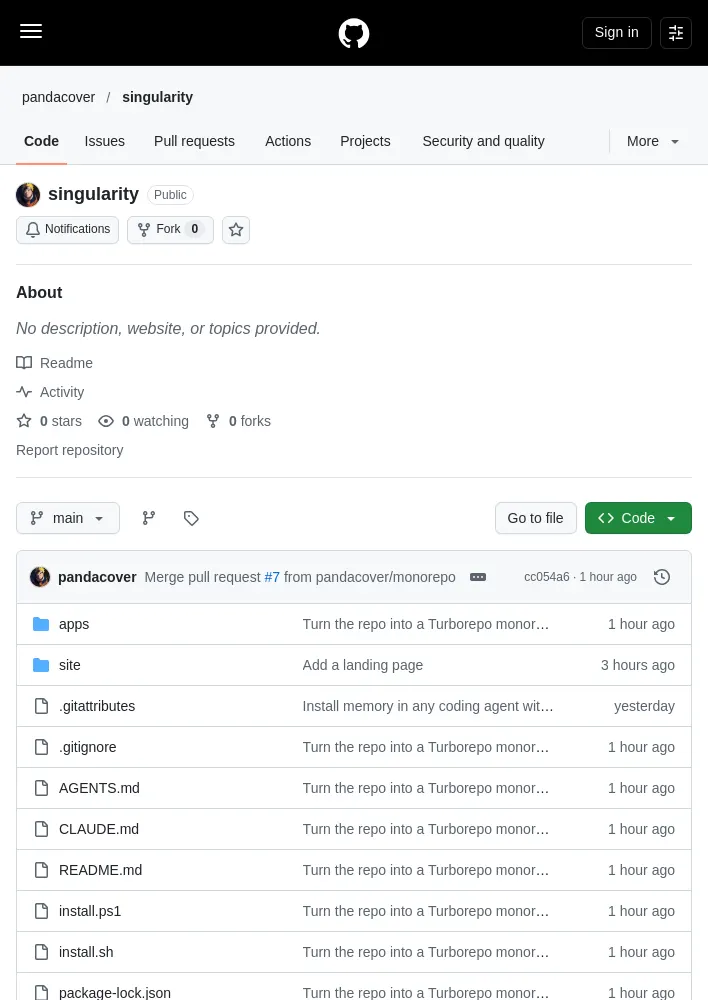
복제한 저장소에서 실행하려면 npm install을 수행한 뒤 node apps/cli/src/cli.ts setup을 실행한다. 평가 명령과 저장소 기억 관리 명령은 프로젝트 README에 나와 있다. 자세한 설치 및 사용법은 Singularity 저장소를 참조하면 된다.
원문은 기억이 실제 개발 작업에서 시간이나 토큰을 얼마나 줄였는지에 대한 비교 수치를 제시하지 않는다. 자동 학습 비용은 안내하지만, 적용 가능한 작업의 범위나 다른 에이전트별 성능 차이도 밝히지 않는다.
부록: 원문 예시
class App › getContextMenuItems › if (this.state.viewModeEnabled) › return [
: the procedural graph. Steps whose descriptions share words with the prompt mark where the task enters the graph; Sonnet then reads the task and the nearby steps with their conditions and decides which apply (about $0.01, counted in the run's cost). The chosen steps are handed over once as a checklist: when each applies, how, what to avoid, and the files and commands involved. Learning asks Sonnet to turn each run into graph edits (see
: the local memory, handed over by its own hooks as in daily use.
), copied into each run's directory, so it never changes. Claude Code gets the hooks through
: the route at the first prompt, a warning when its trigger appears. The route selection's model call runs the same Claude Code as the agent, and counts toward the run. Preview what a task gets with
: memory v1, handed over by its own hooks the same way:
: the local-first memory: the same hooks, with no model call at task start; memory's cues pick the workflows and fill the blanks the task states (
report --compare --baseline saved-scripts
댓글 (0)
로그인하면 이 기사에 내 생각을 남길 수 있어요