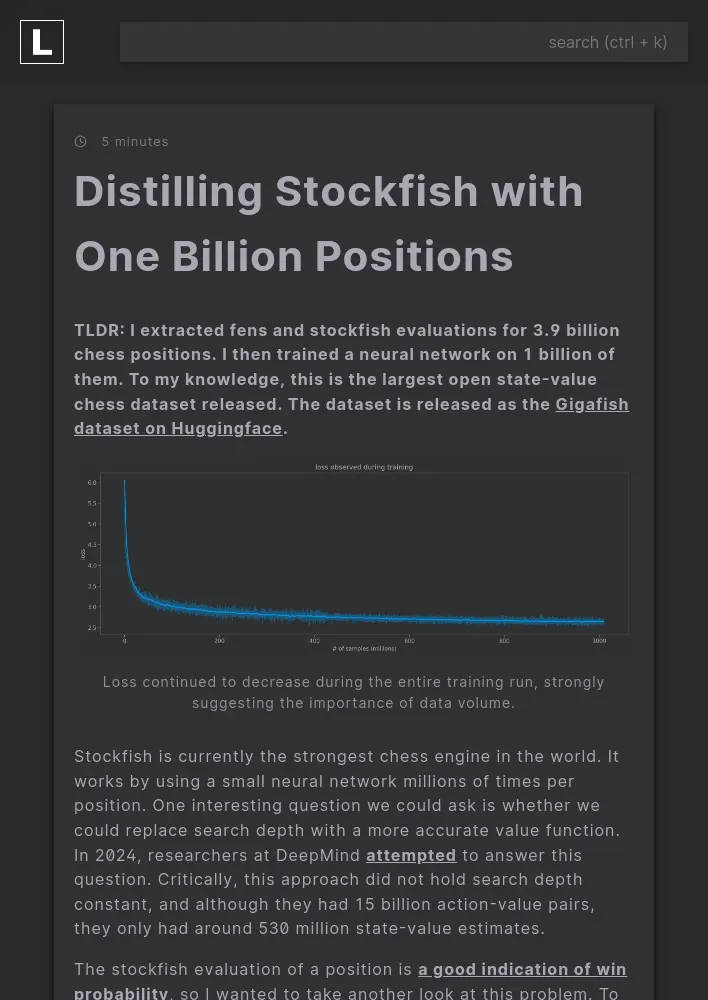
39억 개의 체스 포지션에서 스톡피시 평가값을 추출하고, 그중 10억 개로 신경망을 학습했다. 학습 손실은 약 3일 동안 이어진 학습 내내 감소했다.
이 실험은 고정된 탐색 깊이에서 스톡피시 평가를 모은 데이터셋과 이를 바탕으로 한 모델을 공개한 사례다. 체스 평가 모델을 연구하거나 대규모 공개 학습 데이터를 찾는 사람은 Gigafish 데이터셋을 살펴볼 수 있다.
이 모델은 무엇을 예측하나?
스톡피시는 체스 포지션을 평가할 때 작은 신경망을 한 포지션마다 수백만 번 사용한다. 이 실험은 탐색 깊이를 늘리는 대신 더 정확한 가치 함수를 쓸 수 있는지 살핀다. 체스판의 칸을 바둑판처럼 처리하는 합성곱 신경망과 판 전체의 관계를 살피는 트랜스포머를 결합한 구조를 떠올리면 쉽다. 모델은 둘의 층을 이어 체스 포지션의 승리 가능성을 예측한다.
2024년 딥마인드 연구진은 관련 질문을 다뤘지만, 탐색 깊이를 일정하게 유지하지 않았고 150억 개의 행동-가치 쌍에 비해 포지션만 평가한 상태-가치 추정치는 약 5억 3,000만 개였다. 이번 실험은 고정 탐색 깊이에서 만든 대규모 상태-가치 데이터셋을 사용했다. 스톡피시 평가값은 승리 확률을 가늠하는 지표로 활용했다는 설명이다. 딥마인드 연구와 스톡피시 평가와 승리 확률에 관한 설명이 참고 자료로 제시됐다.
어떤 구조가 나았나?
모델 구조는 순수 비전 트랜스포머, 순수 잔차 신경망(ResNet), 잔차 신경망 블록 뒤에 트랜스포머 블록을 둔 혼합형 세 가지였다. 4,000만 개 매개변수를 둔 첫 예비 학습에서는 혼합형과 잔차 신경망이 순수 비전 트랜스포머보다 나았다. 비전 트랜스포머는 합성곱이 제공하는 구조적 편향 없이 2차원 격자부터 학습해야 했다는 해석이다.
이어 8,000만 개 매개변수 규모의 예비 학습에서 잔차 신경망과 혼합형을 비교했다. 잔차 신경망은 체스판의 공간 패턴을 빠르게 학습했지만, 판 전체의 미묘한 관계를 익히는 데 어려움을 겪고 학습 속도가 느려졌다. 혼합형은 잔차 신경망 블록이 공간 패턴을 학습하고 트랜스포머 블록이 그 정보를 바탕으로 판 전체의 관계를 다루도록 구성됐다.
세 모델의 입력 형식은 같았다. 차례를 둔 쪽 말의 8×8 비트보드 6개, 상대편 말의 8×8 비트보드 6개, 캐슬링 권리와 전체 수 카운터 등을 담은 메타 평면 6개다.
학습 결과는 어디까지인가?
최종 혼합형 모델은 매개변수 7,900만 개로, 잔차 신경망 블록 6개와 트랜스포머 블록 16개를 사용했다. AdamW로 학습률 1e-4를 적용했고, 약 2,000만 샘플의 워밍업과 배치 크기 1,024를 사용했다.
모델은 현재 차례인 쪽의 평가를 예측했다. 출력 로짓은 103개였다. 처음 101개 구간은 승리 확률 0~100%에 대응하고, 나머지 2개는 강제 체크메이트를 처리했다. 손실 함수는 정답 구간 밖의 예측 확률을 벌점으로 삼는 교차 엔트로피(CE)와 정답 구간에서 멀리 벗어난 예측에 추가 벌점을 주는 순서 손실(ORD)을 가중합으로 결합했다.
학습 시작 시 총 손실은 7.0을 넘었다. 종료 시 교차 엔트로피 손실은 2.49, 순서 손실은 0.29였고 총 학습 손실은 약 2.64였다. 약 5만 개 포지션으로 구성한 검증 세트의 손실은 2.648이었다. 어느 쪽이 이기는지를 맞히는 방향 정확도는 92.97%였다. 체크메이트가 강제되지 않은 포지션에서 예측 승리 확률은 평균 약 4~5%포인트 차이가 났다. 이를 스톡피시의 센티폰 단위로 환산한 평균 절대 오차는 거의 패배에서 거의 승리까지 걸친 포지션에서 64cp였다.
스톡피시 깊이 10의 평가를 교사 데이터로 썼으므로, 모델은 대체로 깊이 10 수준에 가까운 성능을 내되 작은 부정확성이 있을 것으로 예상했다. 스톡피시와의 대국 결과를 보면 깊이 약 7까지는 비교적 잘 뒀지만, 깊이 9에서는 대부분 패배하거나 무승부였다. 이는 모델이 깊이 10 스톡피시를 대체한다고 볼 수 없음을 보여준다.
데이터셋은 어떻게 만들었나?
데이터셋은 리체스 공개 데이터베이스의 37개월치 대국에서 만들었다. 먼저 멀티스레드 러스트 스크립트로 대국의 FEN 포지션을 추출했다. FEN은 체스판 상태를 기록하는 표기법이다.
중복 포지션을 제거할 때는 각 FEN을 해시하고, 해시의 앞 12비트에 따라 파일 4,096개에 나눠 저장했다. 각 파일은 메모리에 올려 해시 집합으로 중복을 제거할 수 있을 만큼 작았다. 남은 포지션은 스톡피시 깊이 10으로 평가했다. 이 작업은 병렬화할 수 있었지만, 24개 코어를 사용해도 하루 넘게 계산해야 했다.
계산 자원 제약 때문에 학습은 10억 포지션에서 멈췄고 약 3일이 걸렸다. 학습 손실 곡선은 학습 종료 때까지 내려갔으며, 실험자는 데이터 양을 늘리는 것이 중요하다고 해석했다. 다만 이는 손실 곡선에 근거한 해석이다. 체스벤치 데이터셋은 데이터 포인트 수가 더 많지만, 포지션·수·평가값을 함께 담고 탐색 깊이를 고정해 계산한 데이터는 아니다. 공개된 데이터셋은 Gigafish다. 원문은 모델과 스톡피시의 대국 결과를 깊이별 수치로 제시하지 않으며, 더 많은 데이터를 학습했을 때 성능이 얼마나 나아질지도 밝히지 않는다.
댓글 (0)
로그인하면 이 기사에 내 생각을 남길 수 있어요