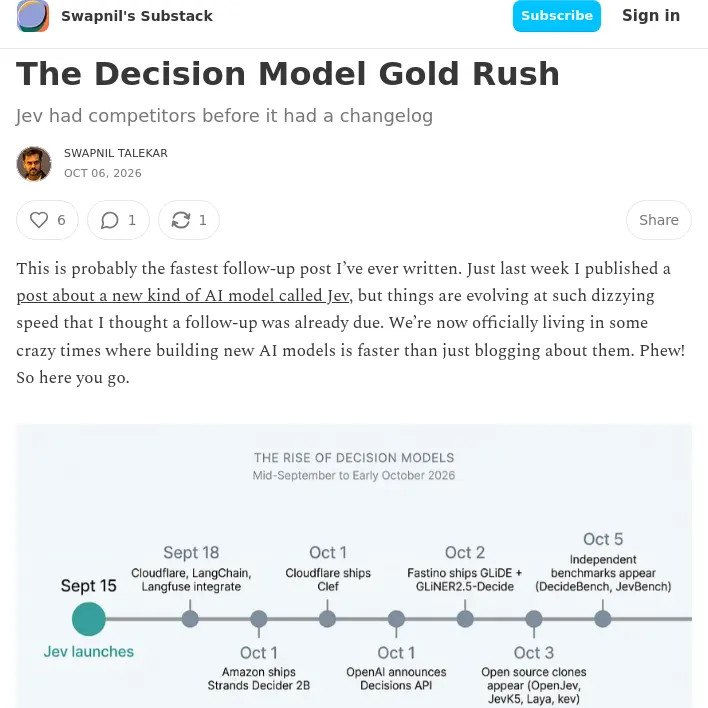
Jev는 대기자 14만 명을 36시간 만에 처리했다. 그런데 경쟁 모델은 출시 약 2주 만에 나타났다. Jev는 답변을 쓰는 대신 선택지나 점수, 신뢰도와 함께 예·아니요를 내놓는 AI 모델이다.
결정형 모델 시장은 Jev 출시 직후 빠르게 경쟁 구도로 바뀌었다. 이 글은 특정 모델을 추천하기보다 실제 운영 환경에서 무엇을 비교해야 하는지 살핀다. 분류나 경로 선택을 자동화하려는 팀이라면 정확도뿐 아니라 속도와 비용, 직접 운영할 수 있는지까지 따져봐야 한다.
결정형 모델은 무엇인가?
결정형 모델은 주어진 입력에 대해 문장으로 답하는 대신 정해진 선택이나 점수를 내놓는다. 여러 갈래 길 가운데 하나를 고르는 안내판을 떠올리면 쉽다. 실제로는 텍스트·이미지 같은 입력을 받아 분류하거나 다음 동작을 고르고, 신뢰도 점수를 함께 제공할 수 있다.
Jev는 9월 15일 출시됐다. 같은 주 개발사 TypeSafe는 2억 달러 기업가치로 4,000만 달러의 시드 투자를 유치했다. 출시 하루 만에 Vercel 유료 AI Gateway 고객의 13%가 이를 작업 흐름에 연결했고, 사흘 안에 Cloudflare·LangChain·Langfuse가 연동 기능을 내놨다.
경쟁 모델도 곧 등장했다. 10월 1일까지 아마존은 Qwen3.5-2B 기반 오픈소스 경쟁 모델 Strands Decider 2B를 공개했다. 오픈AI는 GPT-6 Luna 기반 Decisions API를 발표했다. Jev와 달리 이미지 입력을 받을 수 있다. Cloudflare의 Clef는 Jev API를 대체하도록 만든 공개 가중치 모델이며, 출시 당일 해커뉴스에서 465점을 얻고 Jev가 공개한 여러 벤치마크에서 Jev를 앞섰다.
Fastino는 GLiDE와 GLiNER2.5-Decide를 더했다. GitHub에는 jev-alternative 주제 아래 OpenJev, JevK5, von, Laya 등 오픈소스 복제 모델이 이미 여럿 올라왔다. TypeSafe 최고경영자는 경쟁 모델이 쏟아지는 상황을 두고 “멋진 아키텍처를 구현하려는 머신러닝 사람들”이라고 평가했다. Jev는 위키백과 문서까지 생겼다.
벤치마크 결과는 얼마나 믿을 만한가?
Fastino가 GLiDE와 GLiNER2.5-Decide를 Jev와 비교할 때는 실행할 시험과 비교 대상 모델을 직접 골랐다. TypeSafe도 자사 공개 수치가 최선의 조건에 치우친다고 말한 바 있다. 따라서 독립적으로 구성한 시험 결과를 함께 보는 편이 낫다.
개발자 조인용(Cho Yin Yong)이 만든 DecideBench는 고객 지원 분류, 콘텐츠 조정, 청구 검증, 에이전트 경로 선택 등 8개 작업 분야에서 객관식 결정 400개를 시험한다. 이 시험에서 Jev는 정확도 98%를 기록했고, 작업 100만 건당 비용은 32달러였다. 정확도 95%를 넘긴 모델 가운데 가장 저렴했다. 정확도에서 Jev를 앞선 범용 대규모 언어 모델은 실행 비용이 6~14배였다.
반면 Laya를 비롯한 소형 인코더 기반 모델은 시험에서 정확도 35~59%에 그쳤다. 속도와 비용은 낮았지만 정확도는 낮았다. Imajev-4B는 이미지 입력을 받는 오픈소스 자체 운영 모델로, 정확도 95%를 기록해 시험에서 가장 우수한 오픈 결정형 모델로 꼽혔다. 비슷한 시기에 두 번째 독립 벤치마크인 JevBench도 나왔다.
실제로 고를 때 무엇을 따져야 하나?
먼저 모델을 어디서 실행할지 정해야 한다. Jev와 오픈AI Decisions API는 호스팅 방식이다. Clef, Decider 2B, GLiNER2.5-Decide, Imajev-4B와 여러 오픈소스 복제 모델은 직접 운영하거나 엣지 환경에서 실행할 수 있다. 민감한 데이터를 주요 AI 업체에 보내기 어렵다면 자체 운영이 선택지가 된다.
입력 데이터의 종류도 중요하다. Jev는 텍스트, 문자열, JSON, 문자열 배열을 받는다. Decisions API와 Imajev-4B는 이미지도 처리한다. 화면 캡처, 스캔한 양식, 파손된 제품 사진처럼 시각 자료를 분류해야 한다면 이미지 입력을 지원하는 모델을 살펴봐야 한다.
속도는 작업에 따라 의미가 달라진다. Jev는 70~500밀리초를 내세운다. GLiNER2.5-Decide는 GPU에서 38밀리초, Laya는 질문당 약 33밀리초라고 밝힌다. 고객 지원 티켓을 분류할 때 70밀리초와 500밀리초의 차이는 크지 않을 수 있다. 실시간 게임이나 거래 시스템에서는 수백 밀리초가 중요해질 수 있다.
신뢰도 점수가 실제 데이터에서도 맞는지 확인해야 한다. 과거 결정 사례를 최소 수백 건 뽑아 모델의 신뢰도에 따라 10%포인트 간격으로 나눈 뒤, 각 구간에서 실제로 맞은 비율과 비교하는 방법이 제시된다. 모델이 신뢰도 90%를 냈는데 해당 구간의 실제 정답률이 65%라면 다른 모델을 고려할 만하다.
실제 처리량에 따른 비용도 계산해야 한다. Jev는 입력 토큰 100만 개당 0.042달러이며 출력은 무료다. 결정 요청이 많아지면 총비용이 커질 수 있다. 공개 가중치 모델을 자체 운영하면 사용료 대신 연산 자원과 유지보수 비용이 든다. 어느 쪽이든 자동으로 더 저렴해지는 것은 아니다.
나중에 교체하기 쉬운지도 확인할 필요가 있다. Cloudflare는 고객이 Jev와 Clef를 쉽게 바꾸고 비교할 수 있도록 Clef를 Jev API의 대체 모델로 만들었다. 다른 모델은 API가 서로 맞지 않는 경우가 많아 교체에 추가 작업이 필요하다.
작업에 따라 선택은 어떻게 달라지나?
하루 수천 건의 고객 지원 티켓을 결제, 기술 문제, 이탈 위험으로 나누는 상황을 보자. 잘못 분류해도 사람이 다른 담당자에게 넘기는 데 1~2분이 드는 정도라면, 정확도를 마지막 몇 퍼센트포인트 끌어올리는 것보다 작업당 비용과 속도가 더 중요할 수 있다. DecideBench 기준 작업 100만 건당 32달러에 정확도 98%를 기록한 Jev가 기본 선택지가 될 수 있다. 이미 AWS를 깊이 쓰고 있고 자체 운영 비용을 낮추려 한다면 Strands Decider 2B도 살펴볼 수 있다. 잘못된 분류의 부담이 낮으므로 신뢰도 보정의 중요성도 상대적으로 작다.
반대로 실시간 게임이나 거래 시스템에서 에이전트가 다음에 실행할 도구를 고르는 상황에서는 지연 시간이 큰 영향을 준다. GLiNER2.5-Decide의 GPU 기준 38밀리초나 Laya의 약 33밀리초는 속도 면에서 눈에 띈다. 다만 인코더 모델의 DecideBench 정확도가 35~59%였다는 점도 고려해야 한다. 결정이 3분의 1가량 틀린다면 빠르기만 해서는 쓸모가 제한된다. 지연 시간 제한이 매우 엄격하다면 Jev의 70밀리초 주장이 실제 환경에서 충분한지 시험하고, 그렇지 않을 때 정확도가 낮은 모델을 택할지 판단해야 한다.
10월 첫째 주 당시의 모델 비교는 한 달 뒤면 낡을 수 있다는 전제로 제시됐다. 결정형 모델 시장은 도구 생태계를 먼저 갖춘 모델을 중심으로 통합되거나, 대량 분류에는 저렴한 공개 가중치 모델을 쓰고 설명이 필요한 작업에는 호스팅 API를 쓰는 식으로 용도별로 나뉠 수 있다. 실제 선택 전에는 자신의 입력 데이터와 처리량, 허용 지연 시간으로 정확도·신뢰도 보정·비용을 확인해야 한다. 이 글은 모델별 결과를 소개하지만, 각 수치가 모든 운영 환경에서 그대로 재현되는지는 보여주지 않는다.
댓글 (0)
로그인하면 이 기사에 내 생각을 남길 수 있어요