Amazon ESCI 데이터셋에서 ‘질문 묶음’ 재정렬 방식은 평균 NDCG(검색 결과 순위 품질 지표) 0.360을 기록했다. BM25(검색어와 문서의 일치도를 계산하는 검색 방식)는 0.289였다.
더그 턴불(Doug Turnbull)은 검색어마다 관련성을 판단할 질문을 만들고, 각 질문에 대한 ‘예’ 확률을 더해 검색 결과를 다시 정렬하는 실험을 소개했다. 상품 검색을 개선하려는 팀이 참고할 만한 초기 결과다.
검색어를 질문 묶음으로 바꾸는 방식은?
검색어를 단어 묶음으로 보는 대신, 그 검색어에 맞는 판단 질문 묶음으로 보는 방식이다. 검색 결과를 걸러내는 기준표를 검색어마다 새로 만드는 것에 빗대면 쉽다. 실제로는 언어 모델이 질문을 만들고 Jev가 문서별로 각 질문에 ‘예’라고 답할 확률을 계산한다.
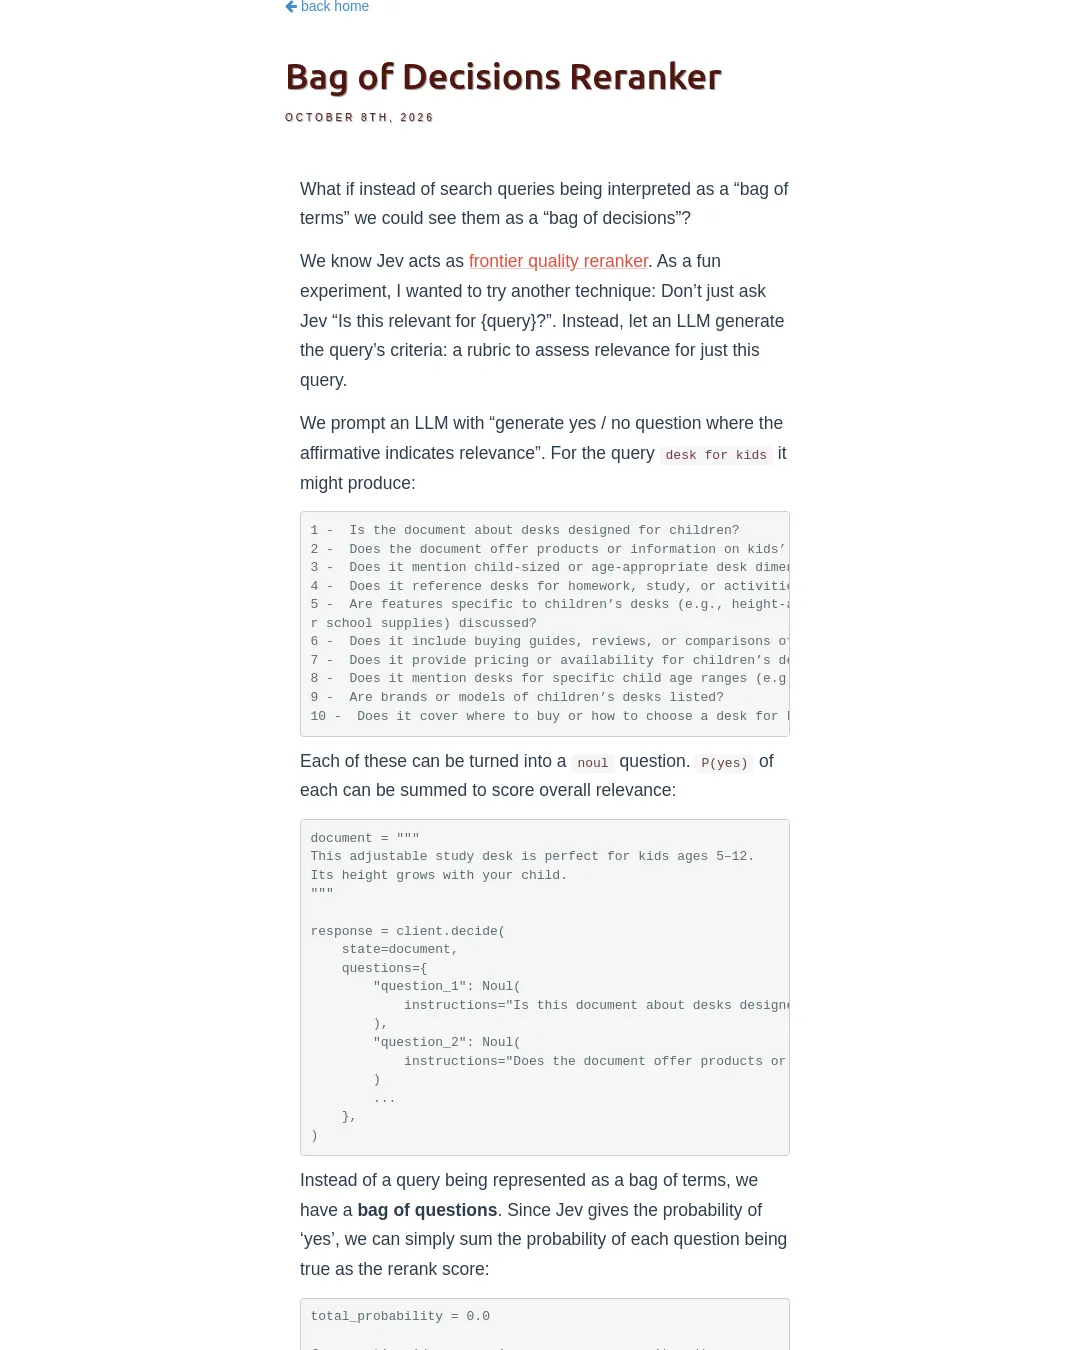
예를 들어 desk for kids라는 검색어에 대해 언어 모델은 어린이용 책상인지, 어린이 책상 제품이나 정보를 제공하는지, 어린이에게 맞는 크기나 인체공학적 특징을 다루는지 등을 묻는 질문을 만들 수 있다.
1 - Is the document about desks designed for children? 2 - Does the document offer products or information on kids’ desks? 3 - Does it mention child-sized or age-appropriate desk dimensions or ergonomics? 4 - Does it reference desks for homework, study, or activities for kids? 5 - Are features specific to children’s desks (e.g., height-adjustable for kids, safety/rounded edges, storage fo r school supplies) discussed? 6 - Does it include buying guides, reviews, or comparisons of kids’ desks? 7 - Does it provide pricing or availability for children’s desks? 8 - Does it mention desks for specific child age ranges (e.g., toddlers, elementary, teens) as kids’ desks? 9 - Are brands or models of children’s desks listed? 10 - Does it cover where to buy or how to choose a desk for kids?
질문마다 noul 질문을 만들고, 문서에 대한 답을 계산한다. 예시 문서는 5~12세 어린이에게 맞고 키에 따라 높이를 조절할 수 있는 학습용 책상이다.
document = """ This adjustable study desk is perfect for kids ages 5–12. Its height grows with your child. """
response = client.decide(     state=document,     questions={         "question_1": Noul(             instructions="Is this document about desks designed for children?"         ),         "question_2": Noul(             instructions="Does the document offer products or information on kids’ desks?"         )         ...     }, )
각 질문의 ‘예’ 확률을 합산해 최종 재정렬 점수로 쓴다. 이 점수를 BM25 점수에 더하거나, 합산한 값만 사용할 수 있다.
total_probability = 0.0 for question_id, answer in response.answers.items(): probability = answer.noul print(f"{question_id}: {probability:.2f}") total_probability += probability
두 데이터셋에서 어떤 결과가 나왔나?
턴불의 실험은 BM25, Jev에 “이 문서는 이 검색어와 관련이 있는가?”라고 묻는 재정렬 방식, 그리고 여러 질문의 확률을 합산하는 bag_of_decisions 방식을 비교했다. 평가에는 전자상거래 데이터셋인 Wayfair WANDS와 Amazon ESCI를 사용했다.
| 데이터셋 | 전략 | 평균 NDCG | 중앙값 NDCG |
|---|---|---|---|
| WANDS | bm25 | 0.5407 | 0.475 |
| WANDS | jev_reranker | 0.574 | 0.561 |
| WANDS | bag_of_decisions | 0.610 | 0.561 |
| ESCI | bm25 | 0.289 | 0.171 |
| ESCI | jev_reranker | 0.314 | 0.205 |
| ESCI | bag_of_decisions | 0.360 | 0.341 |
두 데이터셋 모두에서 bag_of_decisions의 평균 NDCG가 가장 높았다. WANDS에서는 중앙값이 Jev 재정렬 방식과 같았고, ESCI에서는 세 방식 가운데 가장 높았다.
결과를 어디까지 믿을 수 있나?
턴불은 검색어마다 중요한 특징을 언어 모델로 만들고 Jev로 그 기준을 충족하는지 측정하는 접근이라고 설명한다. 다만 이번 결과는 두 전자상거래 데이터셋을 사용한 초기 실험이다. 턴불은 질문 일부가 반복적이라고 지적했으며, 질문을 더 날카롭고 다양하게 만드는 방법은 추가로 살펴볼 문제로 남겼다. 더 깊은 연구가 필요한 유망한 접근이라는 평가도 턴불의 판단이다.
실험의 세부 내용은 연구 자료에서 확인할 수 있다. 원문은 실험의 구체적인 측정 조건이나 비용을 밝히지 않는다.
댓글 (0)
로그인하면 이 기사에 내 생각을 남길 수 있어요