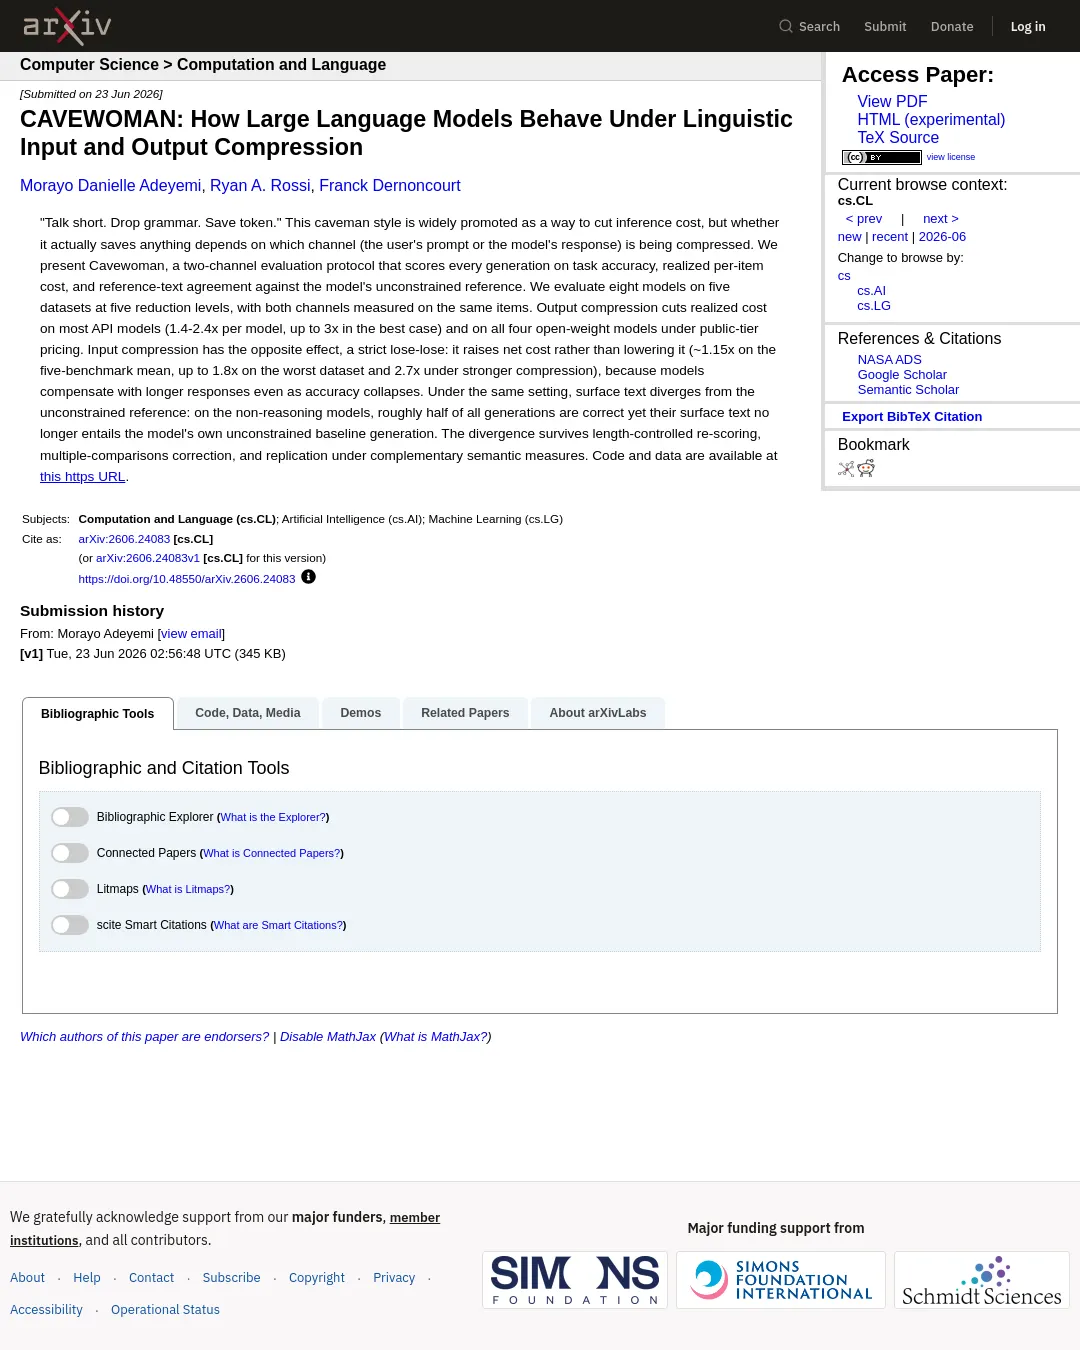
입력 문장을 압축하면 평균 비용이 약 1.15배로 늘었다. 다섯 벤치마크 평균에서 나타난 결과다. 정확도도 떨어졌고, 모델은 더 긴 답변을 내놨다.
모라요 대니얼 아데예미(Morayo Danielle Adeyemi)와 공동 저자들은 입력과 출력의 문장을 각각 줄였을 때 언어 모델의 정확도와 비용이 어떻게 달라지는지 평가하는 CAVEWOMAN 연구를 공개했다. 입력을 짧게 만들어 비용을 아끼려는 이용자와 모델 운영자가 살펴볼 만한 결과다.
CAVEWOMAN은 무엇을 비교했나?
CAVEWOMAN은 입력 압축과 출력 압축을 나눠 평가하는 방식이다. 같은 문제에서 각 답변의 과제 정확도, 항목별 실제 비용, 그리고 압축하지 않았을 때 모델이 낸 기준 답변과의 일치 여부를 측정한다. 여러 조건을 같은 저울에 올려 비교하는 시험을 떠올리면 쉽다. 연구진은 8개 모델과 5개 데이터셋을 대상으로 압축 수준 5가지를 시험했고, 입력과 출력 모두 같은 항목에서 측정했다.
입력과 출력을 줄이면 무엇이 달라졌나?
출력 압축은 대부분의 API 모델에서 실제 비용을 모델별로 1.4~2.4배 낮췄고, 가장 큰 절감 폭은 3배였다. 공개 요금 기준으로는 오픈 웨이트(open-weight) 모델 4개 모두에서 비용이 낮아졌다.
반면 입력 압축은 비용을 줄이지 못했다. 평균 비용은 약 1.15배로 늘었고, 가장 비용이 증가한 데이터셋에서는 약 1.8배였다. 더 강하게 압축한 조건에서는 최대 2.7배까지 증가했다. 모델이 답변을 더 길게 생성하는 동안 정확도는 크게 떨어져, 비용과 정확도 모두에서 손해가 났다.
비추론(non-reasoning) 모델에서는 표면 텍스트가 기준 답변과 달라지는 현상도 관찰됐다. 생성 결과의 대략 절반은 정답이었지만, 문장 자체가 해당 모델의 압축하지 않은 기준 답변을 함의하지 않았다. 길이를 통제한 재평가, 다중 비교 보정(multiple-comparisons correction), 서로 보완적인 의미 측정 방식으로 반복해도 이런 차이가 남았다.
결과를 어디까지 볼 수 있나?
이 결과는 연구진이 시험한 8개 모델과 5개 데이터셋, 5개 압축 수준에 관한 것이다. 비용 비교에는 공개 요금 기준이 쓰였으며, 출력 압축의 절감 폭은 모델에 따라 달랐다. 연구진은 기준 답변과의 불일치가 여러 재평가 조건에서도 유지됐다고 보고했지만, 초록만으로는 각 모델과 데이터셋의 이름이나 세부 측정값을 확인할 수 없다.
논문은 arXiv에서 확인할 수 있다. 코드와 데이터는 CAVEWOMAN 저장소에 공개됐다. 원문은 초록에서 모델·데이터셋별 상세 수치와 구체적인 요금표를 밝히지 않는다.
댓글 (0)
로그인하면 이 기사에 내 생각을 남길 수 있어요