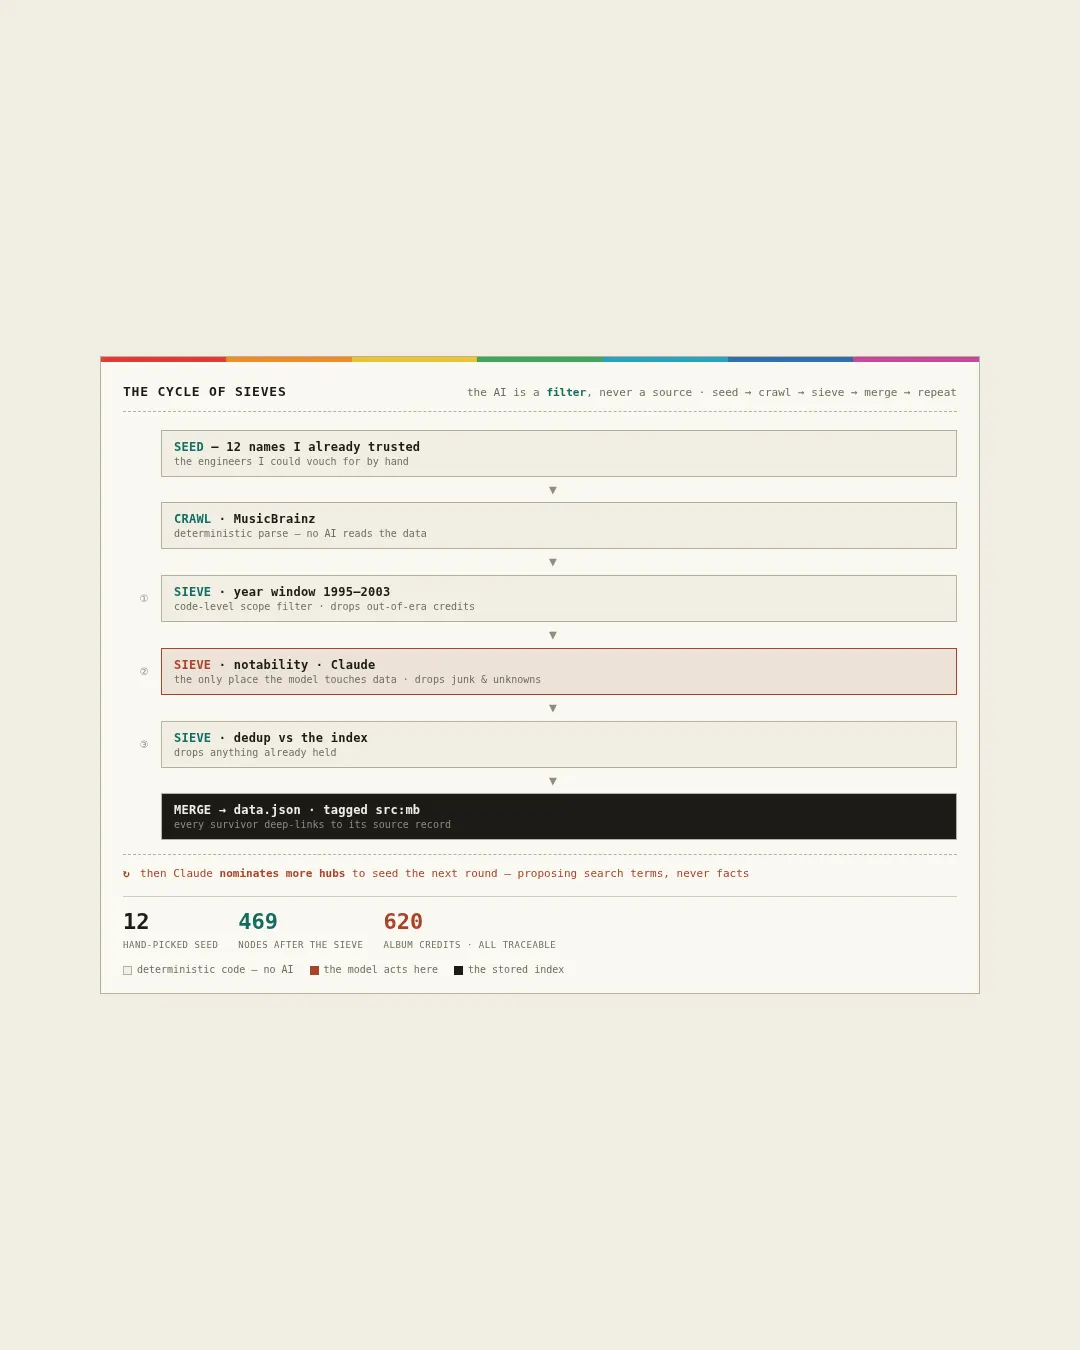
인디·포스트록 음반을 만든 엔지니어와 프로듀서, 스튜디오를 추적하는 프로젝트 2inch.fm은 직접 고른 12명에서 출발해 469개 노드와 620개 앨범 크레딧을 모았다. 대규모 언어 모델(LLM)은 크레딧을 생성하지 않고, 데이터에서 잡음을 걸러내거나 다음에 검색할 이름을 제안하는 데만 쓰였다.
프로젝트 운영자는 신뢰할 수 있는 데이터베이스와 모델의 역할을 분리했다. 크레딧은 MusicBrainz의 구조화된 API에서 가져와 코드로 파싱하고, 모델은 사실을 쓰지 않도록 제한했다. 덕분에 모델이 그럴듯하지만 사실이 아닌 크레딧을 만들어 넣는 일을 막는다는 설명이다.
확장은 여러 차례의 필터링으로 진행된다. 먼저 코드가 1995~2003년 발매분만 남긴다. 이 시기 범위는 운영자가 밝힌 개인적 편향이다. 다음으로 모델이 새로 발견된 밴드마다 실제로 주목할 만한 활동인지, 잡음인지 예·아니요로 판단한다. ‘Various Artists’ 항목이나 잘못 파싱된 데이터, DJ 믹스 음반은 제외하지만, 취향이나 장르를 평가하지 않으며 확신이 없으면 남긴다. 마지막으로 기존 색인에 있는 항목을 빼고 나머지를 병합한다.
추가된 항목에는 src:"mb" 태그와 MusicBrainz 발매 ID를 기록해 각 크레딧이 출처 음반으로 연결되도록 했다. 직접 고른 초기 명단에는 태그를 붙이지 않아, 운영자가 확인한 정보와 자동 확장된 정보를 구분할 수 있다.
병합 뒤에는 모델이 아직 색인에 없는 엔지니어 이름을 다음 검색 대상으로 제안한다. 이 이름들은 새로운 사실이 아니라 검색어로만 쓰이며, 이후 MusicBrainz에서 크레딧을 가져와 같은 필터를 거친다. 제안되는 이름이 이미 색인에 있는 이름과 겹치기 시작하면 해당 장면의 탐색이 포화된 것으로 판단한다.
운영자는 확장 결과의 신뢰성이 출발점으로 고른 이름과 각 정보에 연결한 출처에 달려 있다고 설명한다. 프롬프트 전문을 포함한 방법은 2inch.fm/about에서 확인할 수 있으며, 프로젝트는 2inch.fm에서 볼 수 있다.
댓글 (0)
로그인하면 이 기사에 내 생각을 남길 수 있어요