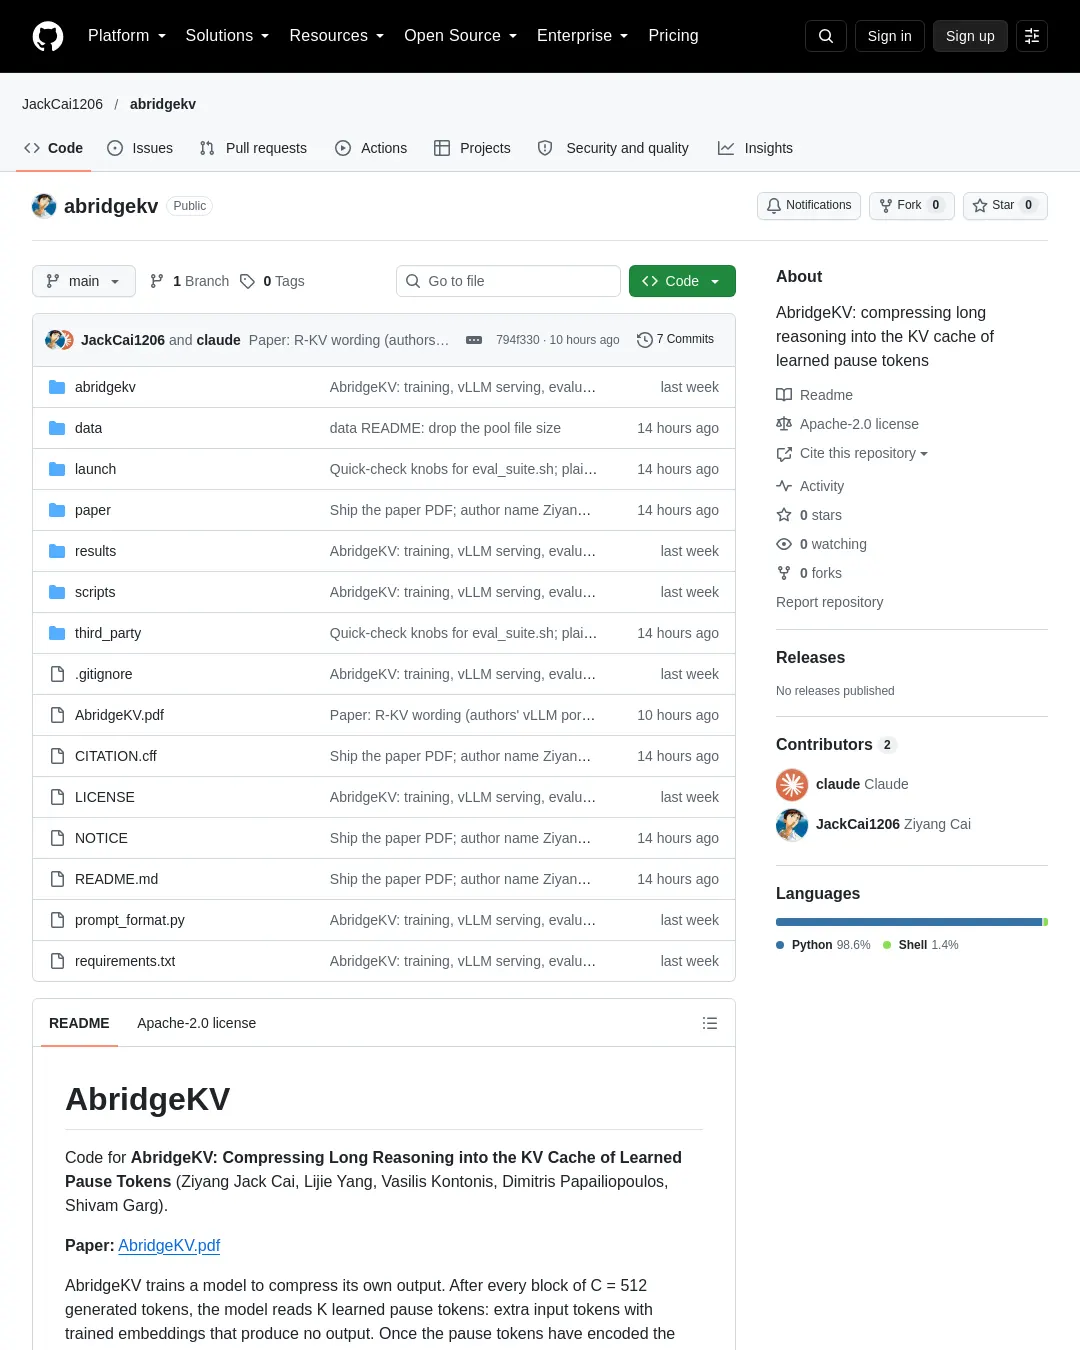
AbridgeKV는 모델이 학습된 일시정지 토큰으로 앞서 생성한 추론을 압축해, 이후 토큰이 전체 생성 기록 대신 압축 정보를 참고하도록 하는 방법이다. 공개 저장소에는 학습·평가 코드와 재현 절차가 포함돼 있으며, Qwen3-4B-Base 실험에서 레이어별 캐시 할당 방식은 전체 KV 캐시 방식과 비슷한 평균 점수를 기록했다.
프로젝트 저장소와 논문을 공개했다. AbridgeKV는 512개 토큰을 생성할 때마다 학습된 일시정지 토큰 K개를 입력한다. 이 토큰은 출력물을 만들지 않으며, 해당 블록의 정보를 인코딩한 뒤 블록의 KV 항목을 해제한다. 이후 토큰은 해제된 항목 대신 일시정지 토큰의 KV 항목을 참고한다.
설계는 세 가지 특징을 둔다. 일시정지 토큰의 위치는 대체하는 블록 안에 배정해 압축으로 위치 수가 늘어나지 않게 한다. 레이어별 항목의 측정된 가치를 바탕으로 캐시 예산을 나누며, 36개 레이어에 각각 256행, 128행, 64행을 할당해 평균 128행을 유지한다. 이는 생성된 캐시의 4분의 1이다. 또 512토큰 단위의 큰 블록을 압축한다.
평가 결과
실험은 nvidia/OpenMathReasoning의 응답 토큰 2B개로 미세 조정한 Qwen3-4B-Base를 사용했다. 모든 실험군은 같은 데이터와 학습 절차를 적용했다. 평가는 AIME, HMMT, AMC, BRUMO, CMIMC, SMT에서 뽑은 446개 문제를 대상으로 문제당 8회 샘플링했으며, 토큰 한도는 32K였다. 아래 점수는 avg@8이며, 95% 신뢰구간을 함께 표시했다.
| 실험군 | 512토큰당 KV 행 | 평균 점수 [95% 신뢰구간] | 전체 KV 대비 차이(짝지은 비교) | 토큰 한도 도달 샘플 |
|---|---|---|---|---|
| 전체 KV 미세 조정 | 512 | 43.8 [39.8, 47.6] | — | 3.4% |
| AbridgeKV(레이어별) | 128 | 43.0 [39.1, 46.9] | −0.8 [−2.3, +0.8] | 3.2% |
| 균일 할당 | 128 | 41.5 [37.6, 45.3] | −2.3 [−3.8, −0.9] | 3.4% |
| 위치를 뒤에 추가 | 128 | 35.3 [31.6, 39.0] | −8.5 [−10.3, −6.8] | 3.6% |
| LightThinker | 97 | 33.3 [29.6, 37.0] | −10.5 [−12.5, −8.7] | 5.4% |
| R-KV, 예산 4096 | 144 | 42.6 [38.5, 46.6] | −1.2 [−2.7, +0.3] | 31.7% |
| R-KV, 예산 2048 | 74 | 35.6 [31.7, 39.5] | −8.2 [−10.2, −6.3] | 55.8% |
저장소 설명에 따르면 vLLM으로 서빙할 때 레이어별 방식은 시퀀스당 캐시가 전체 KV 방식보다 3.5배 작았고, 포화 상태의 H100은 문제 하나를 3.2배 빠르게 처리했다. 이는 저장소가 보고한 결과다.
설치와 재현
학습 환경에는 최신 transformers가 필요하고, 서빙 환경에는 구버전을 고정하는 vLLM 0.13.0이 필요해 두 환경을 분리한다.
# training, probes, export
pip install -r requirements.txt
# serving and evaluation (separate environment)
pip install vllm==0.13.0 math-verify==0.9.0 datasets
bash third_party/vllm_overlay/install_overlay.sh
출력은 기본적으로 ./outputs에 저장한다. 논문 실험은 학습마다 H100-80GB 8개를 갖춘 노드 한 대를 사용해 약 15시간씩 진행했고, 평가 작업 단위마다 H100 또는 A100-80GB 한 개를 사용했다.
저장소는 학습 데이터와 평가 세트를 준비한 뒤 실험군별 학습, 모델 내보내기, 평가를 진행하는 명령을 제공한다. 재현에 필요한 전체 절차는 저장소 안내에 있다. 레이어별 할당에 쓰는 측정 일정 파일은 저장소에 포함돼 있어 균일 할당 실험을 먼저 실행하지 않아도 된다. 재실행하면 launch/train.sh는 가장 최근의 완전한 체크포인트부터 이어서 학습하며, 데이터 순서는 GPU 개수와 무관하게 고정된다.
R-KV 비교 실험은 R-KV 저장소를 별도 환경에 설치해야 한다. 저장소는 예산이 작을 때 해당 포트가 전체 캐시를 조용히 유지하는 경우가 있으므로, 점수 버퍼 크기를 예산에 맞게 설정해야 한다고 안내한다. 라이선스는 Apache-2.0이며, vLLM 오버레이에는 Apache-2.0 라이선스의 vLLM과 MIT 라이선스의 microsoft/memento 오버레이가 포함된다.
댓글 (0)
로그인하면 이 기사에 내 생각을 남길 수 있어요