이 프로젝트는 엔비디아 GPU에서 단정밀도 행렬 곱셈(SGEMM)을 구현하고 최적화하는 방법을 설명한다. 목표는 모든 GPU와 행렬 크기에서 cuBLAS를 앞서는 것이 아니라, CUDA 학습자가 cuBLAS와 CUTLASS 같은 라이브러리의 구현에 가까운 커널을 이해하도록 돕는 것이다. 코드는 sgemm.cu에서 확인할 수 있다.
SGEMM은 C := alpha*A*B + beta*C를 계산한다. 글은 CUDA 장치의 벤치마크 방법과 알고리즘 설계를 다루며, 인라인 PTX, 비동기 메모리 복사, 더블 버퍼링, 공유 메모리 뱅크 충돌 회피, 공유 메모리를 이용한 병합 저장을 설명한다. 고수준 알고리즘 설계는 엔비디아 엔지니어들이 개발하고 cuBLAS와 CUTLASS 관련 선행 작업에서 연구해 온 것이다. 프로젝트의 기여는 이를 효율적인 CUDA/PTX 코드로 옮긴 데 있다고 설명한다.
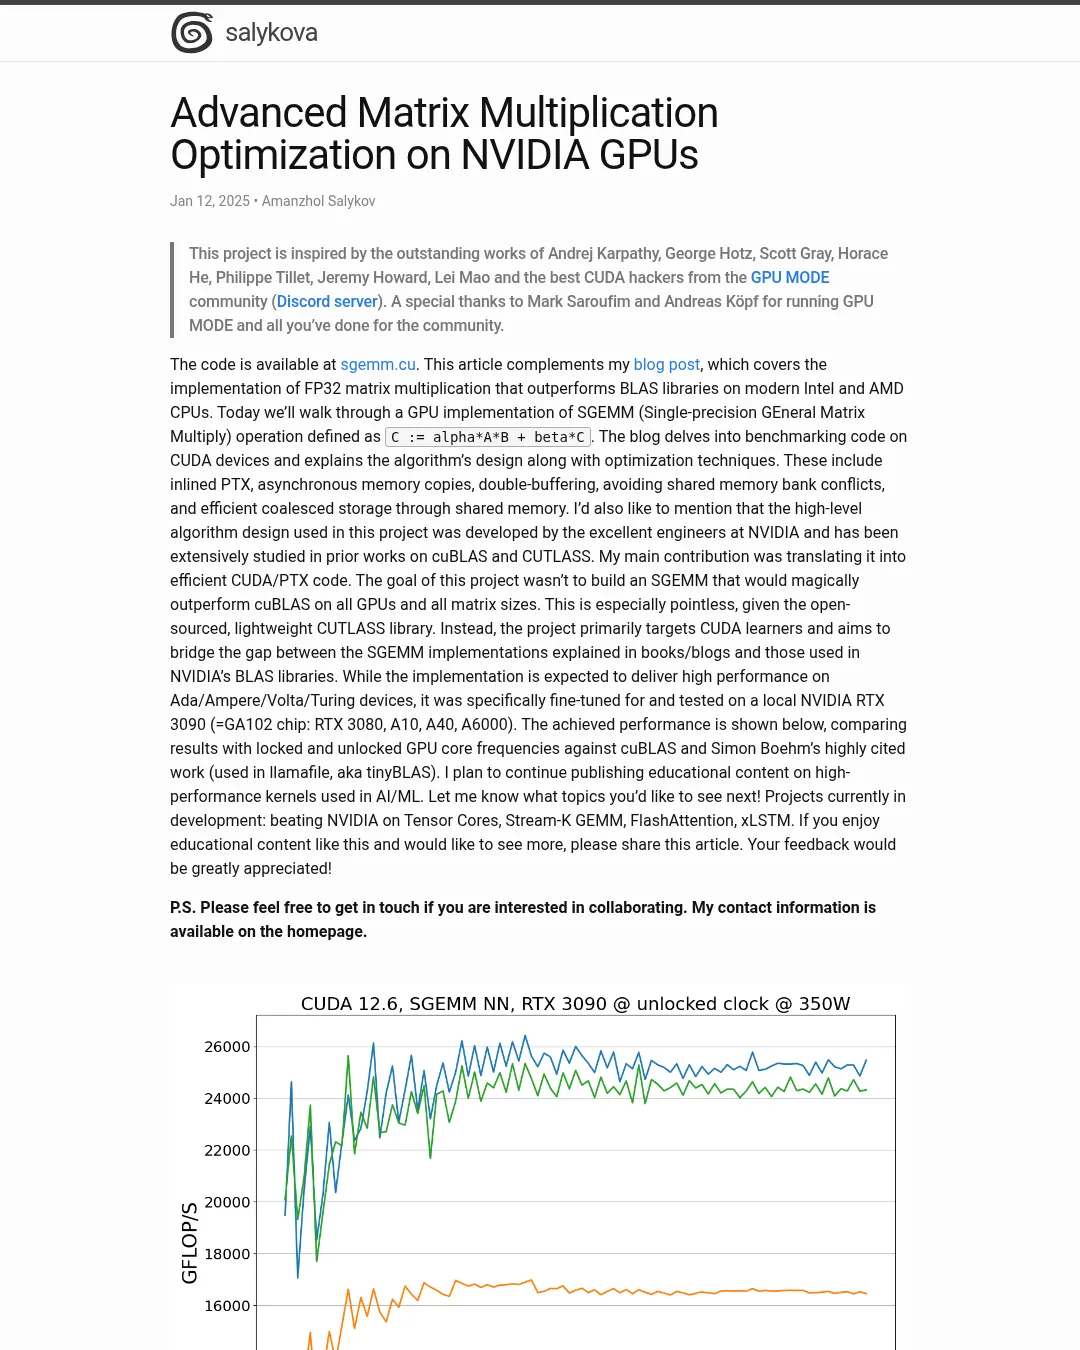
구현은 Ada, Ampere, Volta, Turing GPU에서 높은 성능을 낼 것으로 기대되지만, 실제로는 NVIDIA RTX 3090(GA102 칩, RTX 3080·A10·A40·A6000)에 맞춰 조정하고 테스트했다. 성능 비교에는 GPU 코어 클록을 고정한 경우와 고정하지 않은 경우가 모두 포함되며, cuBLAS와 Simon Boehm의 구현( llamafile, 즉 tinyBLAS에서 사용)을 비교 대상으로 삼았다.
벤치마크 조건과 재현 방법
커널 실행 시간을 가장 신뢰성 있게 측정하는 방법으로 NVIDIA Nsight Compute 프로파일링을 제시한다. Nsight Compute는 결정적이고 재현 가능한 결과를 위해 GPU 클록을 기본값으로 고정하고, 재생 패스마다 GPU 캐시를 비우며, 지속성 모드를 적용한다. 프로파일러에 의존하지 않고 직접 측정하려면 설정을 수동으로 적용할 수 있다.
Ubuntu에서 기본 코어 클록은 nvidia-smi base-clocks로 확인한다. RTX 3090의 예시는 1395 MHz다. 메모리 클록은 nvidia-smi -q -d supported_clocks로 확인하고, 기본 코어 클록과 함께 사용할 수 있는 가장 빠른 메모리 클록을 선택한다. 글은 메모리 클록이 대체로 코어 클록보다 안정적이라고 설명한다. 다음 명령으로 클록을 고정하고 지속성 모드를 켠다.
sudo nvidia-smi --persistence-mode=1 # NVIDIA RTX 3090
sudo nvidia-smi --lock-gpu-clocks=1395
sudo nvidia-smi --lock-memory-clocks=9501
측정이 끝나면 다음 명령으로 클록과 지속성 모드를 초기화한다.
sudo nvidia-smi --reset-gpu-clocks
sudo nvidia-smi --reset-memory-clocks
sudo nvidia-smi --persistence-mode=0
GPU 온도나 전력 한계, 하드웨어 결함은 클록 하락과 스로틀링으로 이어질 수 있으므로 시험 실행 중 GPU 상태를 확인하라고 안내한다. 전력 사용량, 코어·메모리 클록, 스로틀링 사유를 실시간으로 보려면 다음 명령을 쓴다.
watch -n 0.1 nvidia-smi --query-gpu=power.draw,clocks.sm,clocks.mem,clocks_throttle_reasons.active --format=csv
예시 출력은 308.50 W, 1395 MHz, 9501 MHz, 0x0000000000000000이다. 비트 마스크 0x0000000000000000은 스로틀링이 없고 클록이 최대 속도로 동작함을 나타낸다. 0x0000000000000001은 유휴 상태이며, 그 밖의 값은 스로틀링이 발생하고 있음을 시사한다. 전체 비트 마스크 설명은 NvmlClocksThrottleReasons 문서에 있다.
클록을 고정한 뒤에는 CUDA 이벤트로 커널 시간을 잴 수 있다.
cudaEvent_t start, stop;
cudaEventCreate(&start);
cudaEventCreate(&stop);
float elapsed_time_ms = 0.0;
cudaEventRecord(start);
kernel<<<...>>>(...);
cudaEventRecord(stop);
cudaEventSynchronize(stop);
cudaEventElapsedTime(&elapsed_time_ms, start, stop);
여러 번 재생해 측정할 때는 각 커널 재생 전에 GPU 캐시를 비우는 것이 좋다. nvbench의 L2 캐시 비우기 코드는 cudaMemsetAsync를 이용한다. 원문 예시는 장치 ID와 L2 캐시 크기를 조회한 다음 캐시 크기만큼 버퍼를 할당하고 0으로 채운 뒤 해제한다.
// Flush L2 cache
int dev_id{};
int m_l2_size{};
void* buffer;
checkCudaErrors(cudaGetDevice(&dev_id));
checkCudaErrors(cudaDeviceGetAttribute(&m_l2_size, cudaDevAttrL2CacheSize, dev_id));
if (m_l2_size > 0) {
    checkCudaErrors(cudaMalloc(&buffer, static_cast<std::size_t>(m_l2_size)));
    int* m_l2_buffer = reinterpret_cast<int*>(buffer);
    checkCudaErrors(cudaMemsetAsync(m_l2_buffer, 0, static_cast<std::size_t>(m_l2_size)));
    checkCudaErrors(cudaFree(m_l2_buffer));
}
기본 클록을 고정하면 커널 속도를 안정적으로 비교할 수 있지만, 실제 환경에서는 알고리즘이 보통 고정 클록으로 실행되지 않는다. 속도와 전력 효율을 함께 봐야 하는 이유다. 글은 GPU 클록을 고정하지 않은 조건에서도 측정해 두 상황을 비교한다. 행렬 크기는 1024부터 12,800까지 128씩 증가시키고, 크기마다 1000*exp((-matsize+1024)/3100.0))회 재생한 뒤 후반 절반 실행 시간의 평균을 계산한다. 예를 들어 m=n=k=4096이면 371회 실행하고 마지막 185회의 평균을 잰다. 이 방식은 클록을 고정하지 않아도 클록이 안정된 뒤의 일관된 결과를 얻기 위한 것이다. 성능 측정에는 WSL 대신 네이티브 Linux 환경을 사용하라고 권한다.
메모리 배치와 PTX
구현은 행렬을 행 우선(row-major)으로 저장한다고 가정한다. 크기가 M x N인 A는 길이 M*N인 연속 배열이며, A[row][col]은 ptr[row*N + col]로 접근한다. 행렬 곱에서 A, B, C의 크기는 각각 M x K, K x N, M x N이다. 열 우선 저장에 적용하려면 피연산자 A와 B를 바꾸면 된다. cuBLAS의 간략화한 호출은 다음과 같다.
cublasSgemm(m, n, k, A, lda, B, ldb, C, ldc); // simplified form
m, n, k는 행렬 크기이고 lda, ldb, ldc는 선행 차원이다. 행 우선 행렬에서는 보통 열 수가 선행 차원이므로 lda=k, ldb=n, ldc=n이지만, 큰 행렬의 일부를 계산할 때는 선행 차원이 열 수보다 클 수 있다. 벡터화 메모리 접근이나 텐서 코어를 위해 행렬에 0을 채워 패딩할 수도 있다. 64비트 로드는 선행 차원이 2의 배수, 128비트 로드는 4의 배수여야 한다. 정렬 조건을 만족하지 않으면 한 행을 읽을 때 다음 행의 데이터까지 건드릴 수 있다. 실행 중 선행 차원을 확인해 조건이 맞을 때만 벡터화 로드를 쓰고, 그렇지 않으면 스칼라 로드를 쓰는 방법도 설명한다. 과거에는 텐서 코어 연산을 위해 패딩이 흔히 필요했으며, 예를 들어 cuBLAS 11 이전 버전의 FP16 텐서 코어 연산은 m, n, k가 8의 배수여야 했다.
CUDA의 .cu 파일은 먼저 PTX(병렬 스레드 실행)로 컴파일된 뒤 실제 GPU 아키텍처의 명령으로 변환된다. PTX는 가상 GPU 아키텍처를 위한 중간 표현이며 실제 GPU에서 직접 실행되지 않는다. CUDA 코드 안에 PTX를 삽입하면 CUDA와 PTX를 섞어 쓸 수 있다. 직접 PTX를 작성하면 생성 명령 수를 줄이거나 필요한 명령과 한정자를 지정하고, 컴파일러에 없거나 C++ 확장으로 제한되는 최적화를 적용할 수 있다. 다만 인라인 PTX가 자동으로 CUDA 코드보다 빠른 것은 아니며, 직접 작성한 PTX가 컴파일러 생성 코드보다 나을 때만 빨라진다. 참고 자료는 인라인 PTX 조립 개요와 PTX 명령어 집합이다.
전역 메모리에서 부동소수점 값을 읽을 때는 ld.global.f32, 저장할 때는 st.global.f32를 사용한다. f32는 32비트 부동소수점을 뜻한다. PTX의 입력·출력 제약에서 "=f"의 f는 부동소수점 형식이고 =는 레지스터에 값을 쓴다는 뜻이며, "l"은 부호 없는 64비트 정수를 나타낸다. volatile은 PTX 생성 중 명령이 삭제되거나 이동되지 않도록 한다.
CUDA에서 전역 메모리 값을 공유 메모리에 복사하면 먼저 레지스터로 읽은 다음 레지스터에서 공유 메모리로 옮긴다. 이 과정에서 데이터는 캐시 계층에도 저장된다. 따라서 PTX에서 전역 메모리에서 공유 메모리로 옮기는 작업은 ld.global과 st.shared 두 명령으로 이뤄진다. Ampere 이전에는 레지스터 저장을 거치지 않고 전역 메모리에서 공유 메모리로 직접 옮길 수 없었지만, Ampere부터는 이를 지원하는 비동기 복사 명령이 추가됐다. PTX의 v4 표기는 네 요소를 묶은 벡터를 뜻하며, ld.shared.v4.f32와 st.shared.v4.f32로 공유 메모리의 네 부동소수점 값을 한 명령으로 읽거나 쓸 수 있다. 조건부 실행은 가드 술어(predicate)를 이용한다. 구현에서는 이 방식으로 범위를 벗어난 전역 메모리 접근을 막는다.
SGEMM의 타일 처리와 메모리 이동
CUTLASS의 SGEMM 설계를 시각화한 자료에 따르면 알고리즘은 전역 메모리에서 공유 메모리로 데이터 이동, 공유 메모리에서 데이터를 읽어 연산, 결과를 전역 메모리에 저장하는 세 단계로 볼 수 있다.
GPU 병렬화를 위해 C를 m_S x n_S 크기의 타일로 나누고, 각 스레드 블록이 타일 하나를 독립적으로 계산한다. K 차원을 따라 반복하면서 A의 m_s x k_s 타일과 B의 k_s x n_s 타일을 전역 메모리에서 공유 메모리로 읽고, C타일 += A타일*B타일로 누산한다. 공유 메모리 용량이 제한되므로 K 전체를 한 번에 올리지 않고 작은 k_s 타일로 나눈다.
전역 메모리에서 공유 메모리로 옮기는 시간은 연산보다 오래 걸려 스레드가 기다릴 수 있다. 데이터 이동과 연산을 겹치기 위해 더블 버퍼링을 쓰면 A와 B의 공유 메모리 사용량이 두 배가 되지만, 다음 타일을 미리 읽는 동안 현재 타일을 계산할 수 있다. 현대 GPU의 공유 메모리는 이 방식을 지원하기에 충분하다고 설명한다.
타일 크기와 스레드 수는 행렬 모양과 GPU 아키텍처에 따라 달라진다. cuBLAS는 여러 행렬 모양과 GPU에 맞춘 SGEMM 커널을 두고 실행 시 휴리스틱으로 선택한다. 타일 크기는 메모리 접근뿐 아니라 공유 메모리 읽기, 연산, 전역 메모리 저장의 스레드 배치와 레지스터·공유 메모리 사용량에도 영향을 준다. 큰 정사각 행렬(M=N=K > 1024)에서는 128 x 256, 128 x 128, 256 x 128 타일 조합이 좋은 성능을 낼 수 있다. RTX 3090에서 1024 <= M=N=K <= 2500일 때는 m_s x n_s x k_s = 128 x 128 x 8, 스레드 블록당 256개 스레드가 가장 높은 TFLOP/s를 기록했다고 보고한다. 이에 따라 128x128x8 커널부터 구현한다.
이 구성에서 A의 128x8 타일은 256개 스레드가 나눠 읽으며 스레드마다 부동소수점 값 네 개를 가져온다. 전역 메모리 접근은 연속되거나 병합(coalesced)되도록 배치하는 것이 바람직하다. A 타일은 행마다 연속 원소가 8개뿐이지만, 한 워프의 연속 스레드가 연속 메모리를 읽도록 배치한다. 공유 메모리에 저장할 때 A 타일을 전치해 다음 연산 단계의 접근을 개선하며, 스레드마다 연속된 네 원소를 저장해 st.shared.v4.f32를 쓴다.
이 단순 배치는 공유 메모리 뱅크 충돌을 일으킬 수 있다. 공유 메모리는 32개 뱅크로 나뉘고 연속된 32비트 단어가 연속된 뱅크에 매핑된다. 한 메모리 요청의 주소들이 서로 다른 뱅크에 있으면 동시에 처리되지만, 같은 뱅크에 걸리면 요청이 직렬화된다. 충돌은 요청 전체가 아니라 메모리 트랜잭션(현대 CUDA 용어로는 웨이브) 단위로 판단한다. 같은 뱅크의 같은 32비트 위치를 두 번 요청하는 것은 뱅크 충돌이 아니다. 관련 설명은 CUDA 프로그래밍 가이드에 있다.
한 워프의 스레드마다 4바이트, 즉 부동소수점 값 하나를 읽거나 쓰면 128바이트 트랜잭션 하나가 발생한다. 벡터 명령으로 스레드마다 16바이트(네 값)를 쓰면 워프 전체 요청은 512바이트이며, GPU가 이를 128바이트씩 네 트랜잭션으로 나눈다. 패딩 없이 저장하면 각 트랜잭션의 스레드들이 같은 네 뱅크에 접근할 수 있다. 선행 차원에 부동소수점 값 네 개를 추가하면 충돌을 피할 수 있어 구현은 다음 값을 사용한다.
const int smem_a_ld = 132; // 128 + 4
A 타일 두 개를 저장하려면 이론상 2*132*8*4바이트가 필요하지만, 주소 전환을 빠르게 하려고 2*256*8*4바이트로 늘린다. blocks_a를 2*256*8*sizeof(float) 경계에 정렬하면 타일 크기 8192바이트 사이를 ^= 8192 한 번으로 전환할 수 있다. 이 방식은 공유 메모리 일부를 쓰지 않지만, 현대 GPU의 스레드 블록당 공유 메모리 한도를 고려하면 감수할 수 있다고 설명한다. B 타일은 전치하지 않고 32개 연속 스레드가 32개 연속 원소를 읽으며 각 스레드는 간격 32로 네 값을 가져온다. 32개 뱅크를 각각 사용하므로 패딩이 필요 없고, 타일 크기가 2의 거듭제곱이라 ^=4096으로 버퍼를 바꿀 수 있다.
스레드 블록은 256개 스레드, 즉 8개 워프로 구성된다. 각 워프는 128 x 128 출력 타일 중 32 x 64 영역을 맡는다. K 차원을 따라 반복하면서 A의 열 형태 조각과 B의 행 형태 조각을 레지스터로 읽고 곱해 해당 출력 영역을 갱신한다. k_S=8이므로 타일마다 이 과정은 8회 반복된다. 각 스레드는 출력 영역에서 네 개의 4x4 누산기, 합치면 8x8 누산기를 계산한다. A를 앞 단계에서 전치했기 때문에 조각의 원소가 메모리에 연속해 벡터화 로드가 가능하다. 스레드 배치는 뱅크 충돌과 공유 메모리 브로드캐스트 제약을 피하도록 구성한다. 이 제약은 16바이트 벡터 명령으로 읽은 네 부동소수점 값을 워프 안의 네 개보다 많은 연속 스레드에 브로드캐스트할 때 발생한다.
각 스레드는 float accumulator[8][8]을 레지스터에 둔다. 256개 스레드가 전체 128 x 128 출력 타일을 구성한다. 공유 메모리에서 레지스터로 조각을 옮길 때도 메모리 지연을 줄이기 위해 조각을 더블 버퍼링한다. 계산이 끝난 누산기를 현재 스레드 배치 그대로 전역 메모리에 쓰면 접근이 흩어져 성능이 나빠질 수 있다. 따라서 계산 후 더 이상 필요하지 않은 공유 메모리를 임시 버퍼로 사용해 누산기 값을 재배열하고, 행 단위의 병합된 전역 메모리 쓰기를 수행한다. 레지스터에서 공유 메모리로 옮기는 추가 비용은 병합 저장으로 얻는 이득에 비해 작다고 설명한다.
C := alpha AB + beta C를 계산할 때는 누산기를 공유 메모리에 옮긴 뒤 beta != 0.0인지 확인한다. 참이면 전역 메모리의 해당 C 값을 병합 로드해 beta를 곱하고 누산기에 더한 다음, 갱신된 결과를 병합 저장한다.
성능 결과와 커널 선택
128x128x8 구현은 커널 코드에서 볼 수 있다. 고정 클록 벤치마크에서는 cuBLAS보다 빠른 결과를 보였지만, 클록을 고정하지 않은 조건에서는 전력 소비도 고려해야 했다. 이 커널은 평균적으로 cuBLAS보다 3~4% 빨랐지만 전력은 12% 더 소비했다. m=n=k>4000인 행렬에서는 전력 한도에 가까워져 GPU 클록이 낮아지고 전체 성능이 떨어졌다. 따라서 실행 시간과 전력 소비를 함께 최적화해야 한다고 설명한다.
전역 텍스처 벡터화 로드를 이용한 변형은 128x128x8_texld 커널에서 확인할 수 있다. 벡터화 로드는 정렬 조건이 있으므로 lda, ldb가 4의 배수이고 A와 B의 주소가 16바이트 경계에 맞는지 확인한다.
bool is_aligned = (((unsigned)lda & 3u) == 0) && (((unsigned)ldb & 3u) == 0)
                    && (((unsigned long)A & 15u) == 0) && (((unsigned long)B & 15u) == 0);
정렬된 입력에는 네 개의 32비트 채널을 갖는 부동소수점 텍스처 객체를 만들어 A와 B에 연결하고 커널에 전달한다. 커널에서는 tex1Dfetch<float4>로 읽는다. 텍스처 로드는 범위를 벗어난 읽기에 0을 반환하므로 일반 벡터화 전역 로드(ld.global.v4.f32)와 달리 조건부 실행이 필요하지 않다는 것이 선택 이유다.
또 다른 128x256x8 커널은 더 큰 n_S=256 타일과 Ampere부터 지원하는 비동기 복사 명령 cp.async.ca.shared.global을 사용한다. 이 명령은 연산과 메모리 이동을 겹치고 파이프라인 정체를 피하며, 레지스터를 거치지 않고 전역 메모리에서 공유 메모리로 복사할 수 있다. 128x128x8 커널에서 일반 전역 로드만 cp.async로 바꾸면 성능이 낮아졌는데, 원문은 비동기 명령의 지연이 높거나 컴파일러 최적화가 적절하지 않았을 가능성을 제시한다. 반면 타일 크기를 키우고 cp.async를 함께 적용하면 속도와 전력 효율이 모두 더 나은 결과를 냈다. 최종 구현은 두 커널을 결합해 m=n < 2500이면 128x128x8, 그보다 큰 경우 128x256x8을 사용한다.
이 글은 CUDA 학습자를 위한 고성능 커널 교육 자료를 목표로 한다. 이어서 개발 중인 주제로 텐서 코어에서 NVIDIA를 앞서는 방법, Stream-K GEMM, FlashAttention, xLSTM을 언급한다. CPU 행렬 곱셈 구현을 다룬 이전 글은 블로그 게시물에서 볼 수 있다.
부록: 원문 예시
// Pseudocode __shared__ float block_a[2][block_a_size] __shared__ float block_b[2][block_b_size] float fragment_a[2][8] float fragment_b[2][8] float accumulator[8][8] block_a[0] = load first block of matrix A block_b[0] = load first block of matrix B fragment_a[0] = load first fragment from block_a[0] fragment_b[0] = load first fragment from block_b[0] for (block_k=0; block_k<(K/ks-1); block_k++) { block_idx = block_k % 2 block_prefetch_idx = (block_k+1) % 2 // prefetch next blocks (Shared Memory Double buffering) block_a[block_prefetch_idx] = load next block of matrix A block_a[block_prefetch_idx] = load next block of matrix B for (int warp_k=0; warp_k<8; warp_k++) { frag_idx = warp_k % 2 frag_prefetch_idx = (warp_k + 1) % 2 // prefetch next fragments (Register Double buffering) fragment_a[frag_prefetch_idx] = load next fragment from block_a[block_idx] fragment_b[frag_prefetch_idx] = load next fragment from block_b[block_idx] // use fragments loaded in previous iteration to calculate matrix product for (int i = 0; i < 8; i++) { for (int j = 0; j < 8; j++) { accumulator[i][j] += fragment_a[frag_idx][i] * fragment_b[frag_idx][j]; } } } fragment_a[0] = load first fragment from block_a[block_prefetch_idx] fragment_b[0] = load first fragment from block_b[block_prefetch_idx] } // final update of the accumulator using last blocks for (int warp_k=0; warp_k<8; warp_k++) { frag_idx = warp_k % 2 frag_prefetch_idx = (warp_k + 1) % 2 // prefetch next fragments (Register Double buffering) fragment_a[frag_prefetch_idx] = load next fragment from block_a[block_prefetch_idx] fragment_b[frag_prefetch_idx] = load next fragment from block_b[block_prefetch_idx] // use fragments loaded in previous iteration to calculate matrix product for (int i = 0; i < 8; i++) { for (int j = 0; j < 8; j++) { accumulator[i][j] += fragment_a[frag_idx][i] * fragment_b[frag_idx][j]; } } } // After completing the matrix multiplication C=A*B, we perform one final update to the accumulator // to compute C=alpha*A*B before storing the result back to global memory: for (int i=0; i<8; i++) { for (int j=0; j<8; j++) { accumulator[i][j] *= alpha; } } store_to_global_memory(accumulator)
댓글 (0)
로그인하면 이 기사에 내 생각을 남길 수 있어요