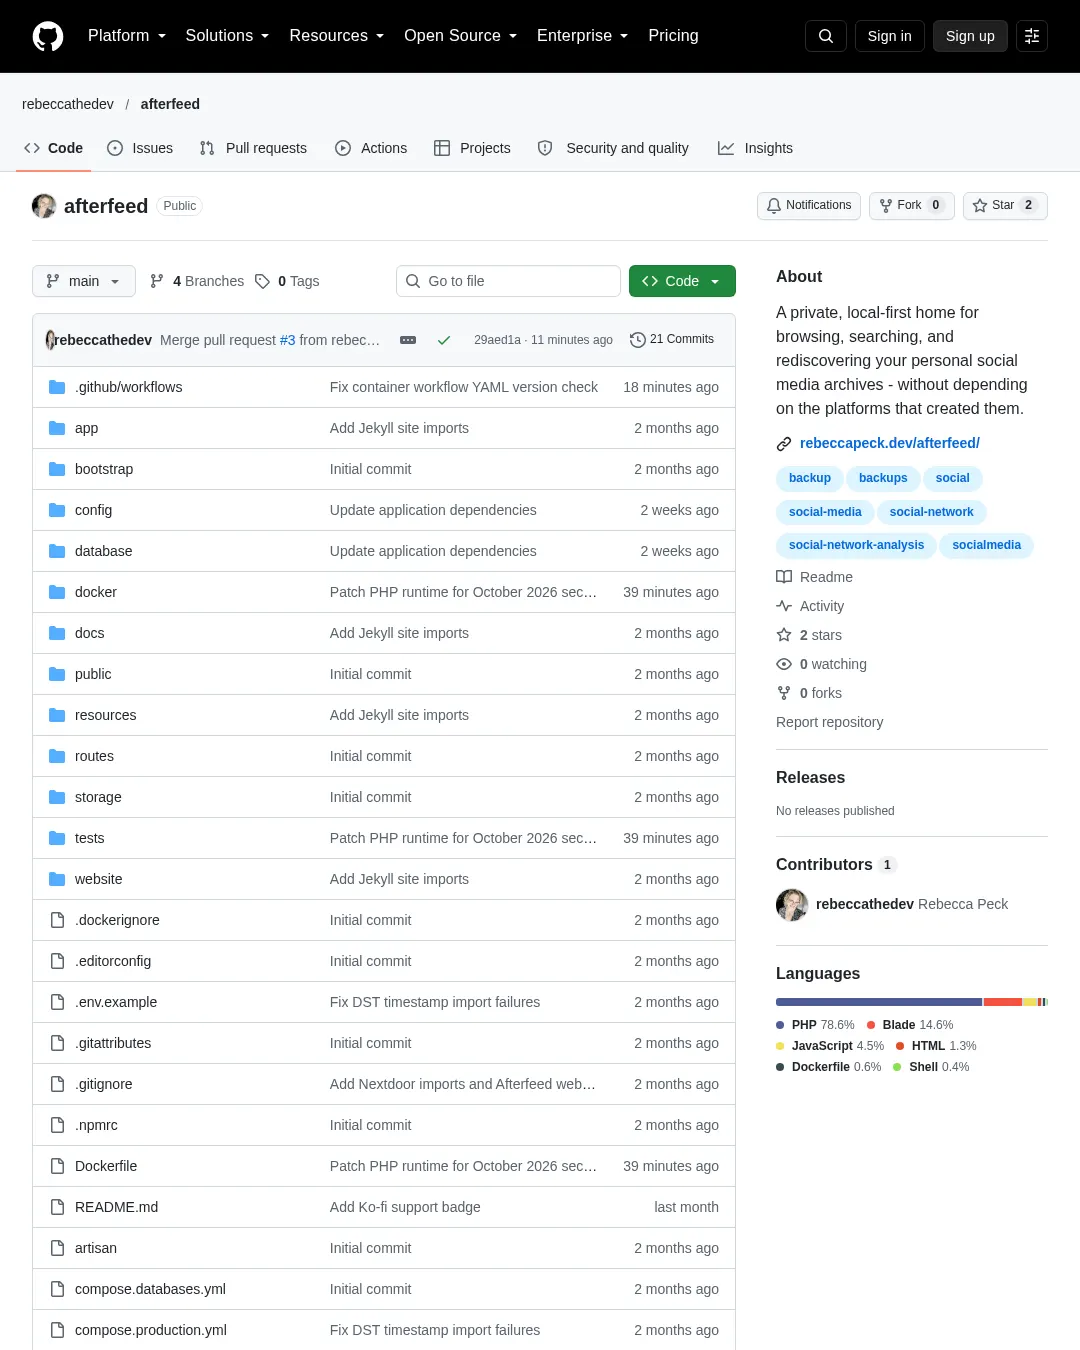
Afterfeed는 여러 소셜미디어에서 내려받은 백업을 한곳에 모아 탐색하고 검색하는 오픈소스 도구다. 자료와 미디어는 사용자가 관리하는 설치 환경에 저장되며, 원본 메타데이터를 보존하고 개인 메모를 가져온 기록과 분리한다.
트위터/X, Mastodon, Facebook, Reddit, Instagram, Google+, Nextdoor, LiveJournal, Jekyll 백업을 지원한다. 게시물과 댓글, 메시지, 미디어 등을 통합 타임라인에서 살펴보고 전체 텍스트 검색, 대화 맥락 복원, 연도별 활동 히트맵, 통계, 지도, 날짜별 기록 검색을 이용할 수 있다. 게시물을 비공개로 즐겨찾기·태그·메모·분류하거나 숨길 수도 있다.
가져온 자료는 사용자의 설치 환경에 남고, 여러 계정이 있는 설치에서는 인증과 사용자별 소유권으로 보관함을 분리한다. IP 기록, 기기 토큰, 전화번호, 암호화 키, 결제 기록, 생년월일, 광고 설정 같은 민감한 보안·계정 데이터는 지원 백업에 포함돼 있어도 의도적으로 제외한다.
설치에는 PHP 8.4.1 이상, Composer, Node.js와 npm이 필요하다. 기본 데이터베이스는 SQLite이며 MySQL/MariaDB와 PostgreSQL도 사용할 수 있다. 저장소의 안내에 따라 설치한 뒤 첫 계정을 만들고, 지원되는 백업 파일을 브라우저에서 올리거나 명령줄로 가져오면 된다. 가져오기는 반복해도 안전하며, 콘텐츠 지문으로 중복 가져오기를 방지하고 기존 백업을 다시 가져오면 최신 가져오기 도구가 지원하는 메타데이터를 반영한다.
자료를 HTML 앨범, PDF, JSON 또는 선택한 미디어를 담은 ZIP으로 내보낼 수 있다. 내보낼 항목별로 텍스트, 미디어, 신원, 날짜, 비공개 메모, 원본 링크, 정확한 위치를 선택한다. 기본 설정은 이미지 EXIF와 원본 플랫폼 메타데이터를 제외하며, FFmpeg로 동영상을 무손실 재처리해 메타데이터를 제거한다. HTML·PDF에 포함하는 미디어는 60MB, PDF는 250개 게시물로 제한되며 더 큰 묶음에는 ZIP을 사용한다.
사용자별 보관함만 읽을 수 있는 JSON API와 MCP 서버도 제공한다. API 요청에는 설정에서 만든 사용자별 베어러 토큰이 필요하고, 페이지당 최대 100개 기록을 반환하며 숨긴 게시물은 제외한다. 토큰은 폐기할 수 있다. 자세한 설치와 가져오기 방법은 Afterfeed 저장소, 가져오기 안내, 컨테이너 배포 문서에서 확인할 수 있다.
댓글 (0)
로그인하면 이 기사에 내 생각을 남길 수 있어요