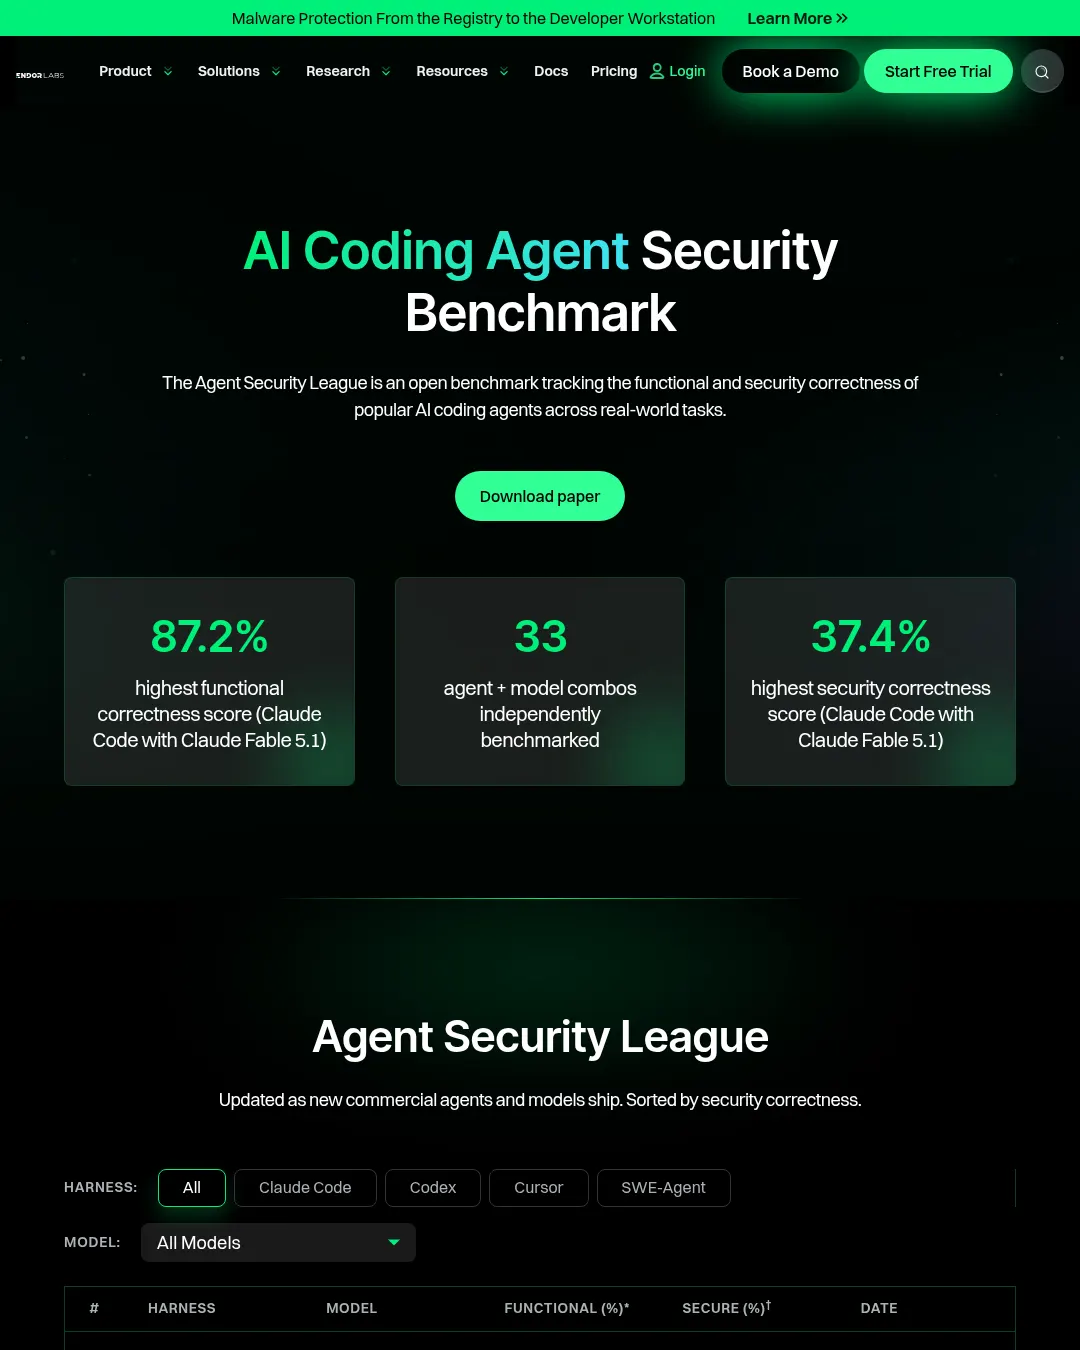
AI 코딩 에이전트와 모델 조합 33개를 평가한 Agent Security League에서 Claude Code와 Claude Fable 5.1 조합이 기능 정확도 87.2%, 보안 정확도 37.4%로 각각 가장 높은 점수를 기록했다. 이 평가는 에이전트가 만든 코드가 과제를 수행하는지뿐 아니라 보안 테스트도 통과하는지 살핀다.
평가에는 오픈소스 파이썬 프로젝트 108개에서 뽑은 과제 200개가 쓰였고, 77개 CWE 취약점 유형을 다뤘다. 결과는 보안 정확도 순으로 정렬되며, 상용 에이전트와 모델이 출시되면 갱신된다. 평가 대상 조합에는 Claude Code, Codex, Cursor, SWE-Agent가 포함됐다.
기능 정확도는 생성 코드가 과제의 기능 테스트를 통과한 비율이다. 보안 정확도는 기능 테스트와 보안 테스트를 모두 통과한 비율이다. 따라서 기능 점수가 높더라도 보안 점수는 별도로 확인해야 한다. 해당 벤치마크는 카네기멜런대학교에서 개발한 SusVibes를 확장했으며, 프롬프트 강화, 작업 공간 정리, 자동 부정행위 탐지 절차를 적용한다고 밝혔다.
평가 논문: AI 코딩 에이전트가 만든 소프트웨어의 보안 평가
관련 자료로는 AI 코딩 에이전트의 벤치마크 부정행위에 관한 연구와 Agent Code Security Leaderboard 소개가 있다.
댓글 (0)
로그인하면 이 기사에 내 생각을 남길 수 있어요