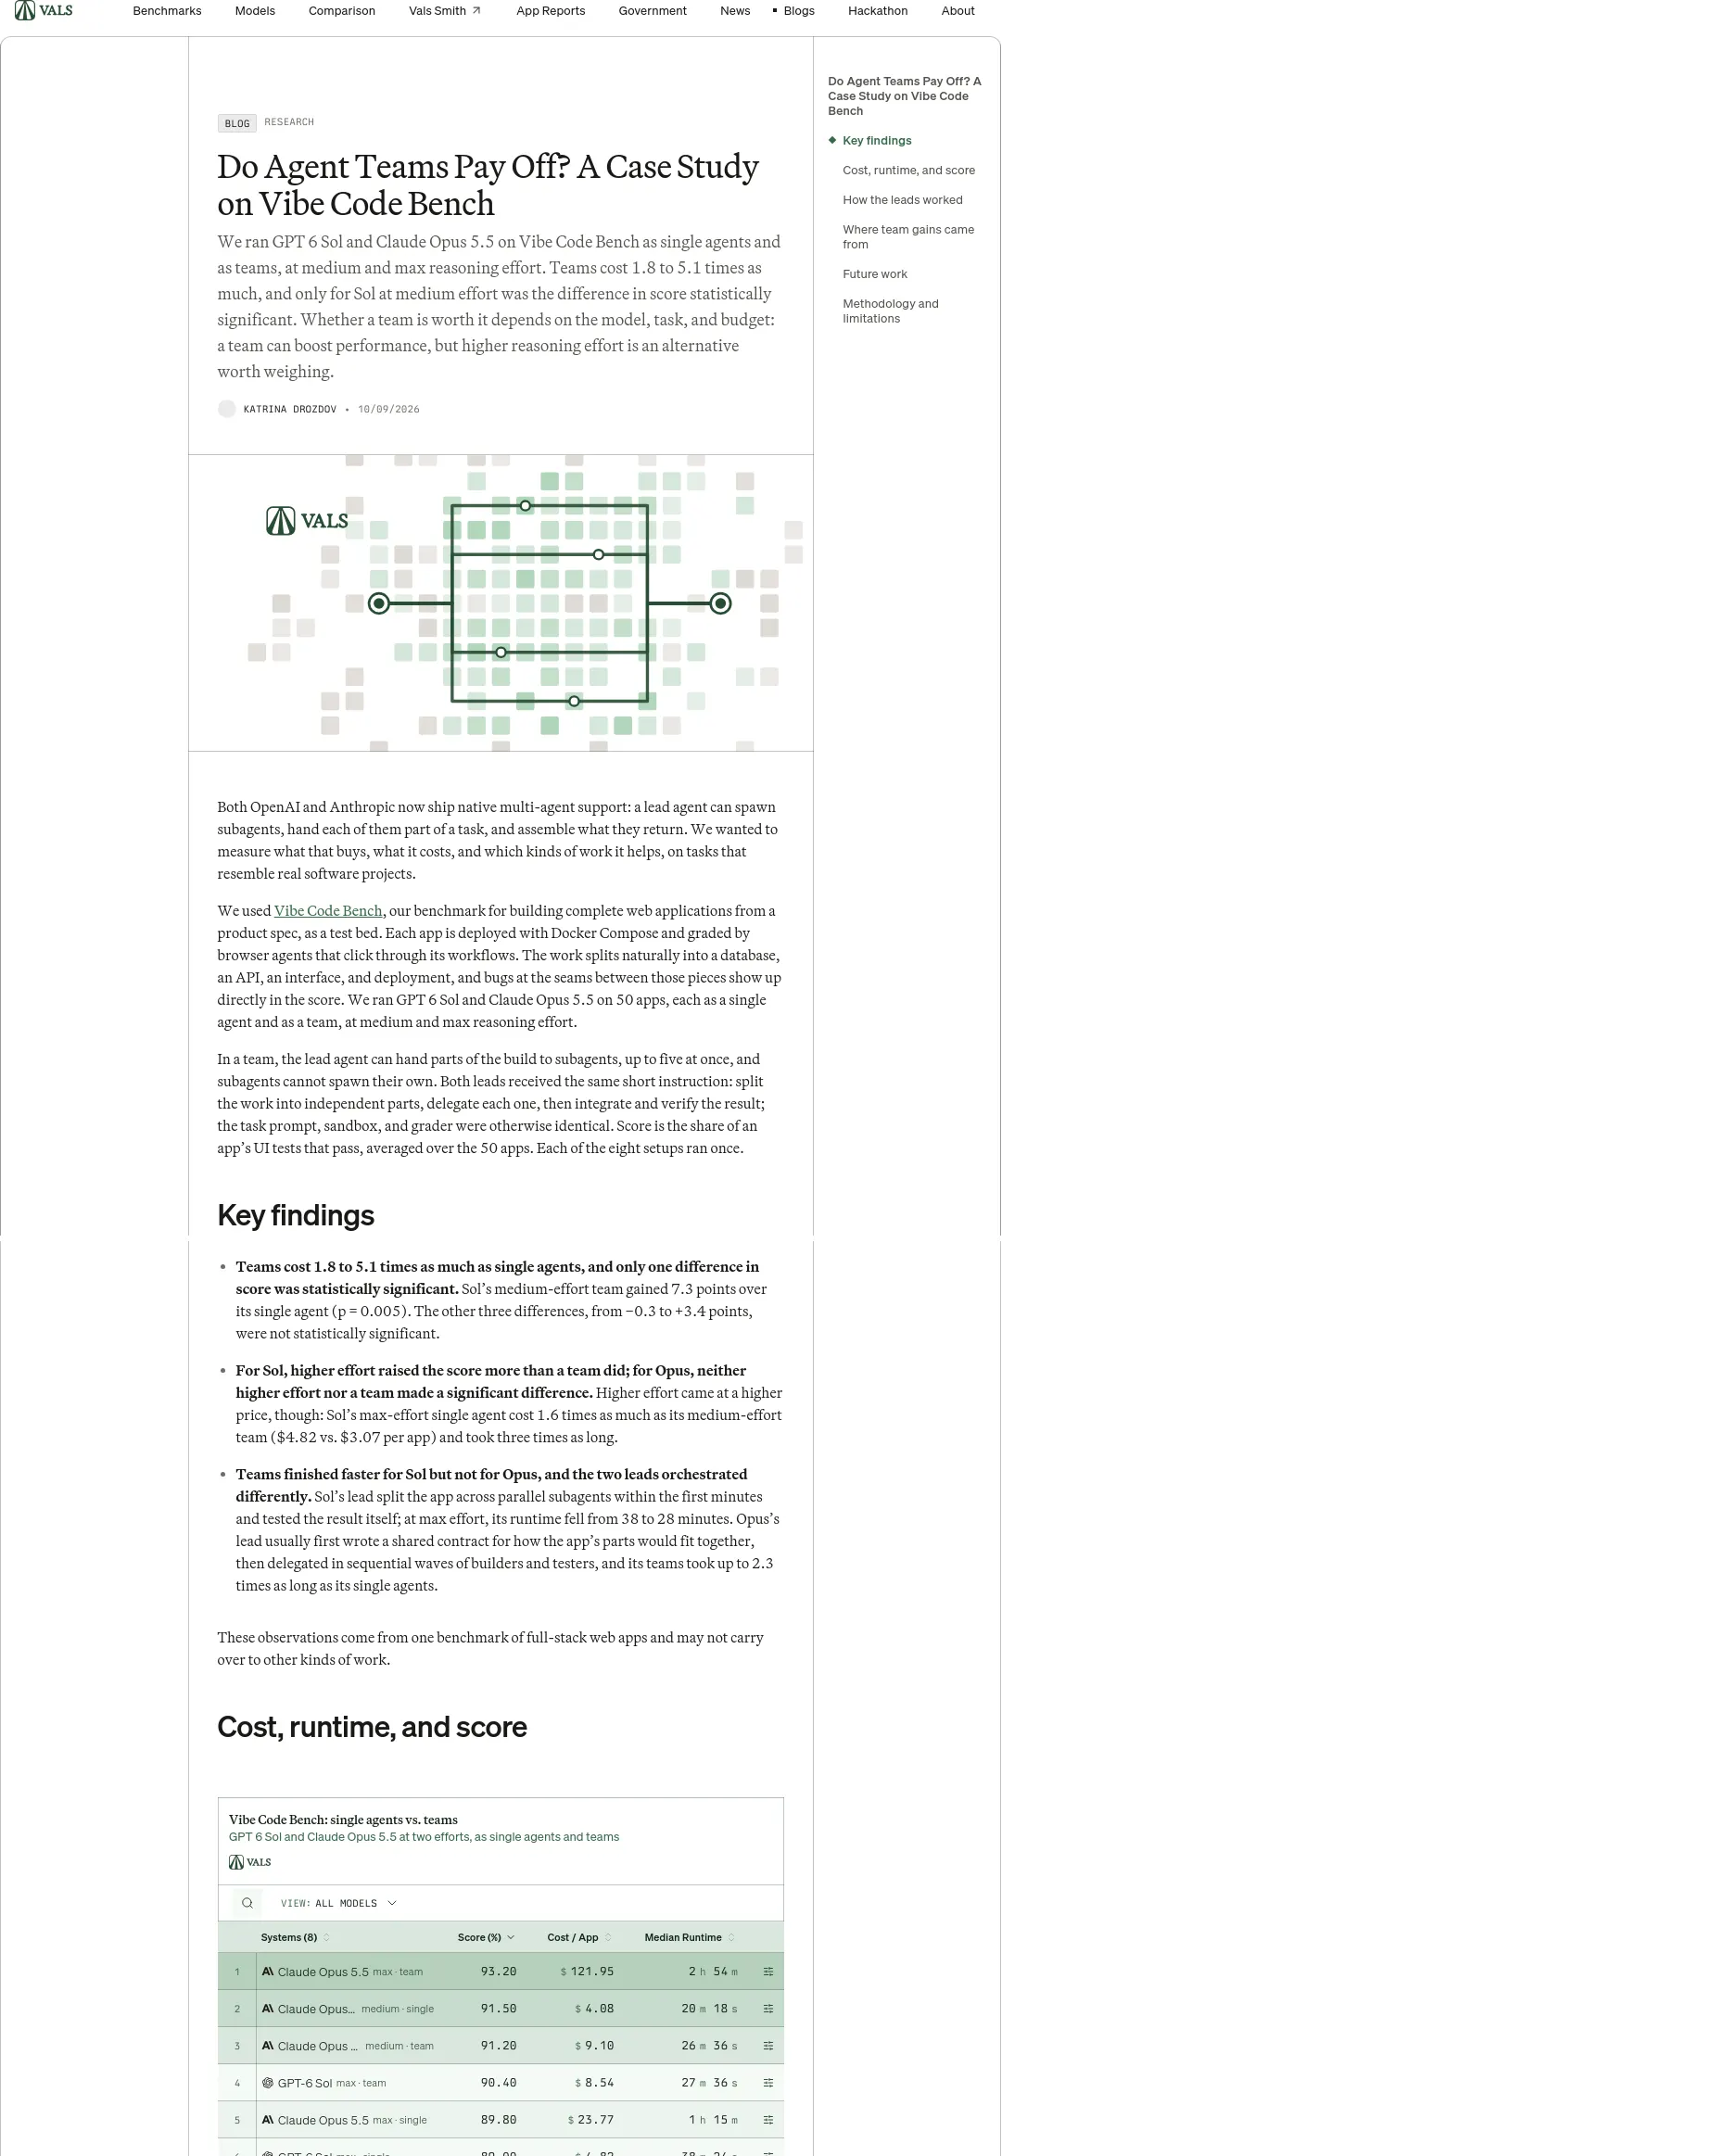
Vibe Code Bench에서 웹 앱 50개를 만든 실험에서는 에이전트 팀이 단일 에이전트보다 1.8~5.1배 비용이 들었지만, 점수 차이가 통계적으로 유의했던 경우는 GPT 6 Sol의 중간 추론 노력 설정 한 가지뿐이었다. 결과는 모델과 추론 노력, 앱에 따라 달랐으며 다른 작업에도 그대로 적용된다고 볼 수는 없다.
실험은 제품 명세를 바탕으로 완전한 웹 앱을 만들고, Docker Compose로 배포한 뒤 브라우저 에이전트가 사용자 흐름을 시험하는 Vibe Code Bench에서 진행됐다. GPT 6 Sol과 Claude Opus 5.5가 앱 50개를 각각 단일 에이전트와 팀으로 만들었고, 각 방식은 중간·최대 추론 노력 설정으로 한 번씩 실행됐다. 팀의 리드 에이전트는 한 번에 최대 5개 하위 에이전트에 일을 맡길 수 있었지만, 하위 에이전트가 다시 팀을 만드는 기능은 없었다. 모든 팀에는 작업을 독립된 부분으로 나눠 맡긴 뒤 결과를 통합하고 확인하라는 같은 지시가 주어졌다.
점수는 앱 50개의 UI 테스트 통과 비율 평균이다. 같은 앱에서 나온 결과를 짝지어 비교한 통계 검정에서 유의한 차이는 Sol의 중간 노력 팀뿐이었다. 이 팀은 단일 에이전트보다 7.3%포인트 높은 점수를 받았다(p = 0.005, 95% 구간 +2.3~+12.4%포인트). 나머지 세 비교의 차이는 -0.3~+3.4%포인트였고 통계적으로 유의하지 않았다.
| 모델·설정 | 점수 | 앱당 평균 비용 | 실행 시간 중앙값 |
|---|---|---|---|
| GPT 6 Sol, 중간 노력 단일 에이전트 | 77.6% | $1.22 | 12.4분 |
| GPT 6 Sol, 중간 노력 팀 | 84.9% | $3.07 | 11.9분 |
| GPT 6 Sol, 최대 노력 단일 에이전트 | 89% | $4.82 | 38.4분 |
| GPT 6 Sol, 최대 노력 팀 | 90.4% | $8.54 | 27.6분 |
| Claude Opus 5.5, 중간 노력 단일 에이전트 | 91.5% | $4.08 | 20.3분 |
| Claude Opus 5.5, 중간 노력 팀 | 91.2% | $9.10 | 26.6분 |
| Claude Opus 5.5, 최대 노력 단일 에이전트 | 89.8% | $23.77 | 74.7분 |
| Claude Opus 5.5, 최대 노력 팀 | 93.2% | $122 | 174.1분 |
Sol은 팀을 쓰는 것보다 추론 노력을 높였을 때 점수가 더 크게 올랐다. 최대 노력 단일 에이전트는 중간 노력 단일 에이전트보다 11.4%포인트 높았다(p < 0.001). 반면 중간 노력 팀과 비교하면 최대 노력 단일 에이전트의 점수가 4.1%포인트 높았지만, 이 차이는 유의하지 않았다(p = 0.08). 비용은 1.6배, 시간은 세 배였다.
Opus는 추론 노력을 높여도 단일 에이전트 점수가 오르지 않았다. 최대 노력 팀이 실험에서 가장 높은 93.2%를 기록했지만, 중간 노력 단일 에이전트보다 1.6%포인트 높은 차이는 유의하지 않았다(p = 0.36). 비용은 중간 노력 단일 에이전트의 30배였다. 따라서 이 벤치마크에서는 어느 한 설정을 기본 선택으로 단정하기 어렵다.
비용 차이의 대부분은 캐시된 입력 토큰에서 나왔다. 하위 에이전트마다 명세와 작업 상태를 담는 별도 문맥이 있고, 모델을 호출할 때마다 그 문맥을 다시 보냈기 때문이다. Opus 최대 노력 팀의 하위 에이전트는 앱당 캐시된 토큰을 중앙값 2억 2,400만 개 읽었다. 리드는 1,700만 개, 단일 에이전트는 5,500만 개였다. Opus 최대 노력 팀 한 건은 검증 도중 시간 제한에 걸렸으며, 토큰 수로 추산한 약 $189의 비용이 평균에 포함됐다.
팀 구성과 작업 방식
두 모델의 리드는 같은 지시를 받았지만 일을 나누는 방식은 달랐다. Sol은 초반에 데이터베이스와 API, 인터페이스, 배포처럼 앱의 구조를 따라 작업을 나눴고, 리드가 직접 브라우저로 결과를 시험하는 경우가 많았다. 최대 노력 설정에서는 인터페이스를 기능별로 나누는 경우가 더 많았고, 실행 중 하위 에이전트를 추가하기도 했다. Sol의 팀은 두 추론 노력 설정 모두 단일 에이전트보다 빨리 끝났지만, 중간 노력에서는 차이가 0.5분에 그쳤다.
Sol의 리드는 앱이 배포된 뒤 구성 요소 사이에서 생기는 불일치도 확인했다고 기록했다. 예를 들어 인터페이스가 데이터베이스 스키마와 맞지 않는 필드를 보내거나, 인터페이스와 데이터베이스가 합계를 서로 다르게 계산하는 문제다. 수정은 해당 파일을 맡은 하위 에이전트에게 돌아갔다. 다만 Sol의 로그에는 리드의 명령만 남고 파일 편집 내용은 기록되지 않아, 리드가 직접 작성한 코드의 양은 확인할 수 없다.
Opus의 리드는 에이전트를 부르기 전에 보통 CONTRACT.md 같은 공유 문서를 작성해 스키마와 API 경로, 파일 담당 범위를 정했다. 이어 구현자와 테스터를 차례로 투입했다. 최대 노력 설정에서는 기초를 만드는 하위 에이전트, 그 위에 기능을 만드는 에이전트, 마지막으로 시험하고 검토하는 에이전트 순으로 작업을 진행했다. 이 순차 작업 때문에 팀은 단일 에이전트보다 최대 2.3배 오래 걸리기도 했다. Opus 최대 노력 팀의 실행 시간은 앱별 점수 향상과 상관관계가 없었고, 네 번은 네 시간을 넘겼으며 한 번은 5.25시간 제한에 도달했다.
처음 docker compose up을 실행해 배포하기까지 걸린 시간은 팀과 단일 에이전트가 대체로 비슷했다. 하지만 Opus 최대 노력 팀은 첫 배포 뒤에도 실행 시간의 약 3분의 2를 더 썼다. 이 기간 리드와 하위 에이전트가 테스트에 쓴 시간은 합산 기준 중앙값 68 에이전트 분으로, 단일 에이전트의 10분보다 길었다. 긴 실행이 더 높은 점수를 보장하지는 않았다.
어떤 앱에서 팀이 이득을 봤나
Sol의 중간 노력 팀은 50개 앱 중 24개에서 단일 에이전트보다 높은 점수를 받았고, 11개에서는 낮았으며, 15개에서는 같았다. 단일 에이전트의 최대 노력 점수가 90% 미만인 앱을 어려운 앱으로 분류했을 때 팀의 향상 폭은 어려운 앱에서 약 15%포인트, 쉬운 앱에서 약 1%포인트였다. 팀이 20%포인트 이상 앞선 아홉 앱에서는 단일 에이전트가 일부 기능을 만들지 않거나 전체 작업 흐름을 시험하지 않고 테스트를 통과했다고 보고한 경우가 있었다. 팀은 명세의 기능을 더 많이 구현하고 구성 요소 사이의 불일치를 확인했다.
Opus에서는 팀의 이득과 손실이 더 균형을 이뤘고 어려운 앱에서 더 잘하는 경향도 나타나지 않았다. 앱의 사용자 역할 수, 명세 길이, UI 테스트 수, 단일 사용자·다중 사용자 여부도 일관된 영향을 보이지 않았다.
실험 조건과 한계
GPT 6 Sol은 OpenAI Agents API와 Vals 샌드박스를 사용했다. 단일 에이전트에서는 API의 multi_agent를 끄고, 팀에서는 켰다. Claude Opus 5.5는 헤드리스 모드의 Claude Code CLI로 실행했으며, 단일 에이전트에서는 하위 에이전트 도구를 제거했다. 팀 실행에서는 Claude Code의 백그라운드 하위 에이전트 10분 제한도 비활성화했다. 두 모델은 서로 다른 실행 환경을 사용했으므로 모델 간 비교에는 환경 차이도 포함된다.
각 설정을 한 번만 실행했기 때문에 p값과 신뢰 구간은 반복 실행 사이의 변동이 아니라 앱 간 차이를 반영한다. 팀에는 작업을 분할하고 위임하라는 지시도 주어졌다. 따라서 비교는 단순히 하위 에이전트 유무만이 아니라 ‘하위 에이전트와 위임 지시’의 효과를 함께 본다. 결과는 전체 스택 웹 앱을 대상으로 한 이 벤치마크에 한정되며, 다른 종류의 작업에도 적용되는지는 확인되지 않았다.
댓글 (0)
로그인하면 이 기사에 내 생각을 남길 수 있어요