TL;DR
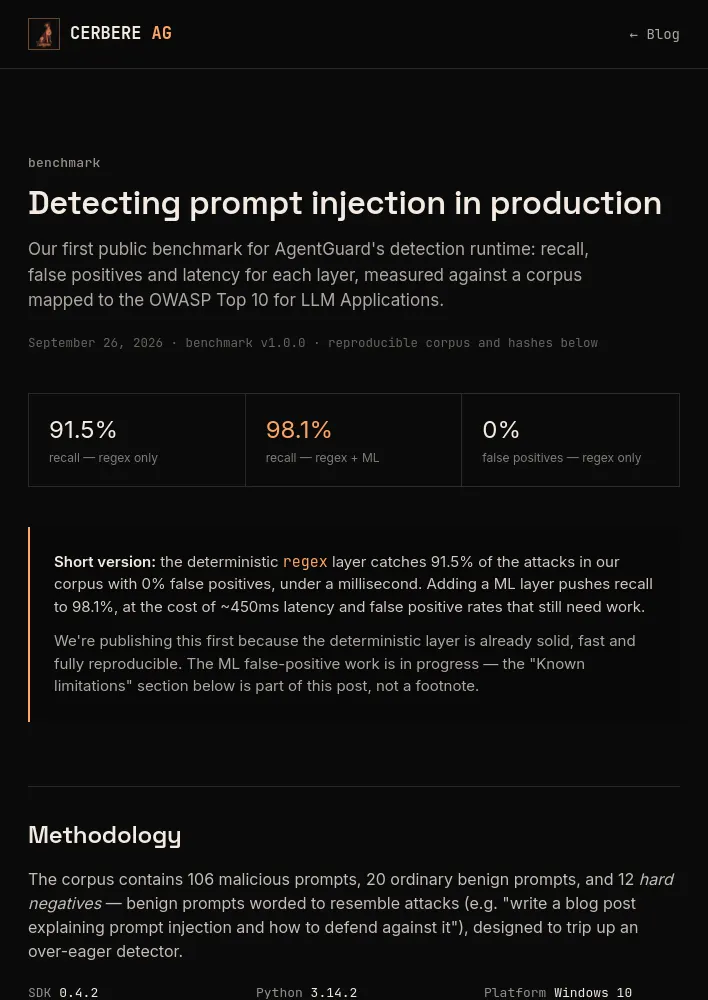
- OWASP LLM 애플리케이션 톱 10에 매핑한 프롬프트 138개 코퍼스에서 AgentGuard의 정규식 탐지기는 재현 가능한 벤치마크 기준 재현율 91.5%, 오탐 0%, 밀리초 미만 지연 시간을 기록함.
- 정규식에 기계학습(ML) 계층을 더하면 재현율이 98.1%로 높아지지만, p95 지연 시간은 약 450ms로 늘고 어려운 음성 사례의 33.3%를 오탐함.
- 코퍼스는 악성 프롬프트 106개, 일반 정상 프롬프트 20개, 공격처럼 보이도록 작성한 어려운 음성 사례 12개로 구성됨.
- 정규식만으로는 난독화 공격이 가장 어려운 범주이며, ML 계층을 더하면 이 범주의 탐지 결과가 7/10에서 8/10으로 높아짐.
- ML 계층의 오탐과 지연 시간, 외부 API에 의존하는 LLM 계층의 환경별 결과 변동이 현재 한계로 공개됨.
벤치마크 개요
- AgentGuard 탐지 런타임의 첫 공개 벤치마크로, OWASP LLM 애플리케이션 톱 10에 매핑한 코퍼스에서 각 계층의 재현율, 오탐, 지연 시간을 측정함.
- 게시일은 2026년 9월 26일이며, 벤치마크 버전은 v1.0.0임.
- 결정론적 정규식 계층은 코퍼스 공격의 91.5%를 오탐 없이 밀리초 미만으로 탐지함. ML 계층을 추가하면 재현율은 98.1%로 높아지지만 지연 시간이 약 450ms로 늘고, 오탐률은 추가 개선이 필요한 수준임.
- 정규식 계층의 결과는 이미 안정적이고 빠르며 완전히 재현 가능해 먼저 공개함. ML 오탐 개선은 진행 중이며, 알려진 한계도 이번 공개 내용에 포함됨.
방법론
- 코퍼스는 악성 프롬프트 106개, 일반 정상 프롬프트 20개, 공격처럼 보이도록 표현한 어려운 음성 사례 12개로 구성됨.
- 어려운 음성 사례는 지나치게 민감한 탐지기가 오탐하도록 설계한 정상 프롬프트임. 예를 들어 프롬프트 인젝션과 방어 방법을 설명하는 블로그 글을 요청하는 문장이 포함됨.
- 실행 환경은 SDK 0.4.2, Python 3.14.2, Windows 10임.
- 재현용 코퍼스 해시:
- attacks:
7775a3e8326df3c71fdd478587e126bc5d733ce5327181305d1d61ec8213c5aa - benign:
f967bf6d22d18c4fa764f864286cc0f2e960265066c51ba1039beff0e2a4bf60 - hard_negatives:
54e96f408e696b8bfda7aaa8cf8dee305af6c678dfdf1a06c924fab3f83dae99
실제 실행 결과
- 결과는 선별한 사례가 아닌 실제 CLI 출력임.
- 실행 스크립트는
benchmarks/run_public_benchmark.py임.
구성별 결과
- 정규식 계층: 재현율 91.5%, 정상 프롬프트 오탐 0.0%, 어려운 음성 사례 오탐 0.0%, p50 0.29ms, p95 1.48ms임.
- 정규식 + ML: 재현율 98.1%, 정상 프롬프트 오탐 5.0%, 어려운 음성 사례 오탐 33.3%, p50 0.20ms, p95 448ms임.
- 정규식 + ML + LLM: 재현율 98.1%, 정상 프롬프트 오탐 5.0%, 어려운 음성 사례 오탐 33.3%, p50 0.22ms, p95 442ms임.
정규식만 사용한 범주별 재현율
- 위험 명령(dangerous_commands): 12/12임.
- 데이터 유출(exfiltration): 15/15임.
- 간접 인젝션(indirect_injection): 10/10임.
- 시스템 프롬프트 추출(system_extraction): 13/14임.
- 직접 인젝션(direct_injection): 24/27임.
- 탈옥(jailbreak): 16/18임.
- 인코딩·난독화(encoded_obfuscated): 7/10임.
- 문자 사이에 공백을 넣은 텍스트, 보이지 않는 문자, HTML 주석 트릭을 포함하는 난독화는 정규식만으로 탐지하기 가장 어려운 범주임. ML 계층은 이 범주의 결과를 7/10에서 8/10으로 높이지만, 아래에 명시한 오탐이 발생함.
OWASP LLM 애플리케이션 톱 10(2025) 매핑
- LLM01 프롬프트 인젝션(Prompt Injection):
direct_injection,indirect_injection,jailbreak,encoded_obfuscated임. - LLM02 민감 정보 공개(Sensitive Information Disclosure):
exfiltration임. - LLM06 과도한 에이전시(Excessive Agency):
dangerous_commands임. - LLM07 시스템 프롬프트 유출(System Prompt Leakage):
system_extraction임.
알려진 한계
- ML 오탐: 공격처럼 보이게 작성한 정상 프롬프트 12개 중 4개(33.3%)를 ML 계층이 잘못 차단함. 보안이나 API 키를 언급하지만 실제로 노출하지 않는 요청이 대표적이며, 현재 최우선 개선 과제임.
- ML 지연 시간: p95가 정규식만 사용할 때의 2ms 미만과 비교해 약 450ms임. 사용 사례에 따라 재현율 향상과 맞바꿀 실제 비용임.
- LLM 계층: 외부 API에 의존하므로 환경에 따라 결과가 달라짐. 이번 코퍼스에서는 정규식 + ML 구성보다 측정 가능한 재현율 향상을 더하지 않음.
- 난독화: ML을 사용해도 재현율이 80%로 가장 어려운 범주임. 문자 간격을 둔 텍스트, 보이지 않는 문자, HTML 주석 트릭이 다음 개선 대상임.
- 코드와 벤치마크는 GitHub에서 재현 가능함. 피드백과 실패 사례를 환영하며 프로젝트는 활발히 반복 개선 중임.
댓글 (0)
로그인하면 이 기사에 내 생각을 남길 수 있어요