TL;DR
- 장기·복잡한 문제를 푸는 에이전트에서 추론 시점 메타 추론(agentic meta-reasoning)은 제어 선택을 구조화해 직접 제어보다 여러 벤치마크에서 더 높은 성능을 보임.
- 작업자(worker)는 과업 계산을 수행하고 컨트롤러(controller)는 진행 상황을 통합해 다음 행동의 가치를 남은 예산에 비춰 평가함.
- 컨트롤러는 전체 실행 이력 대신 압축된 실행 요약을 유지하고, 지속 메모리의 맥락을 활용해 선택한 작업을 배정함.
- ProgramBench에서 GPT-5.5는 71.5%, Opus 4.8은 67.2%를 기록했으며, 각각 Codex와 Claude Code를 앞섬.
- 여러 벤치마크에서 직접 제어 대비 평균 3.6~4.2점 향상됐지만, 작은 예산에서는 오버헤드가 성능을 낮출 수 있음.
연구 개요
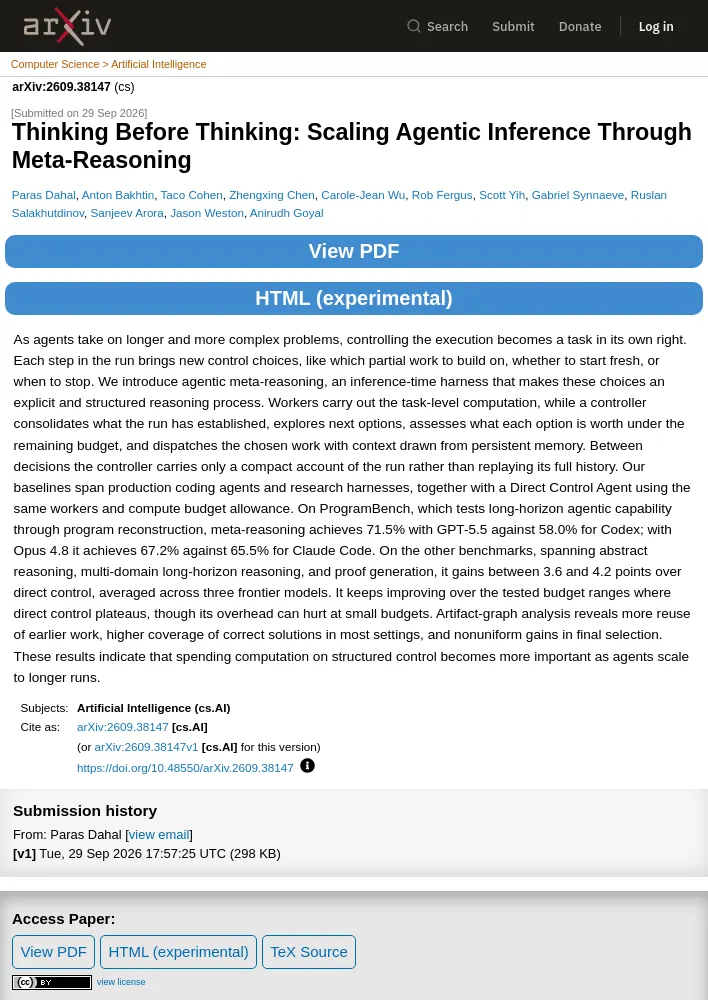
- 논문 제목은 “Thinking Before Thinking: Scaling Agentic Inference Through Meta-Reasoning”이며, Paras Dahal, Anton Bakhtin, Taco Cohen, Zhengxing Chen, Carole-Jean Wu, Rob Fergus, Scott Yih, Gabriel Synnaeve, Ruslan Salakhutdinov, Sanjeev Arora, Jason Weston, Anirudh Goyal이 작성함.
- arXiv:2609.38147, 컴퓨터 과학·인공지능(cs.AI) 분야 논문이며, 제출일은 2026년 9월 29일임.
- DOI: https://doi.org/10.48550/arXiv.2609.38147
메타 추론 방식
- 에이전트가 장기 과제를 수행할 때는 어떤 부분 작업을 이어갈지, 새로 시작할지, 언제 멈출지 등 각 단계의 실행 제어 자체가 별도의 과제가 됨.
- 제안한 메타 추론은 이러한 선택을 명시적이고 구조화된 추론 절차로 처리하는 추론 시점 하네스(inference-time harness)임.
- 작업자는 과업 수준의 계산을 수행하고, 컨트롤러는 실행 중 확인된 내용을 통합하고 다음 선택지를 탐색하며 남은 계산 예산을 고려해 각 선택의 가치를 평가한 뒤 작업을 배정함.
- 컨트롤러는 지속 메모리에서 가져온 맥락과 함께 선택한 작업을 전달하며, 의사결정 사이에는 전체 이력을 다시 재생하지 않고 실행에 대한 압축된 요약만 유지함.
- 비교 기준에는 실제 배포용 코딩 에이전트와 연구용 하네스가 포함되며, 동일한 작업자와 계산 예산 한도를 사용하는 직접 제어 에이전트(Direct Control Agent)도 포함됨.
벤치마크 결과
- 장기 에이전트 역량을 프로그램 재구성으로 평가하는 ProgramBench에서 GPT-5.5 기반 메타 추론은 71.5%를 기록해 Codex의 58.0%를 앞섬.
- Opus 4.8 기반 메타 추론은 67.2%를 기록해 Claude Code의 65.5%를 앞섬.
- 추상 추론, 여러 영역의 장기 추론, 증명 생성 벤치마크에서는 프런티어 모델 3종 평균으로 직접 제어보다 3.6~4.2점 높은 성능을 보임.
- 시험한 예산 범위에서 메타 추론 성능은 계속 개선된 반면 직접 제어는 정체됐으나, 작은 예산에서는 메타 추론의 오버헤드가 성능에 불리하게 작용할 수 있음.
- 아티팩트 그래프 분석에서는 이전 작업의 재사용 증가, 대부분의 설정에서 정답 후보 포괄 범위 확대, 최종 선택 단계에서 설정별로 균일하지 않은 성능 향상이 관찰됨.
- 결과는 에이전트 실행이 길어질수록 구조화된 제어에 계산을 투입하는 일이 더 중요해짐을 시사함.
댓글 (0)
로그인하면 이 기사에 내 생각을 남길 수 있어요