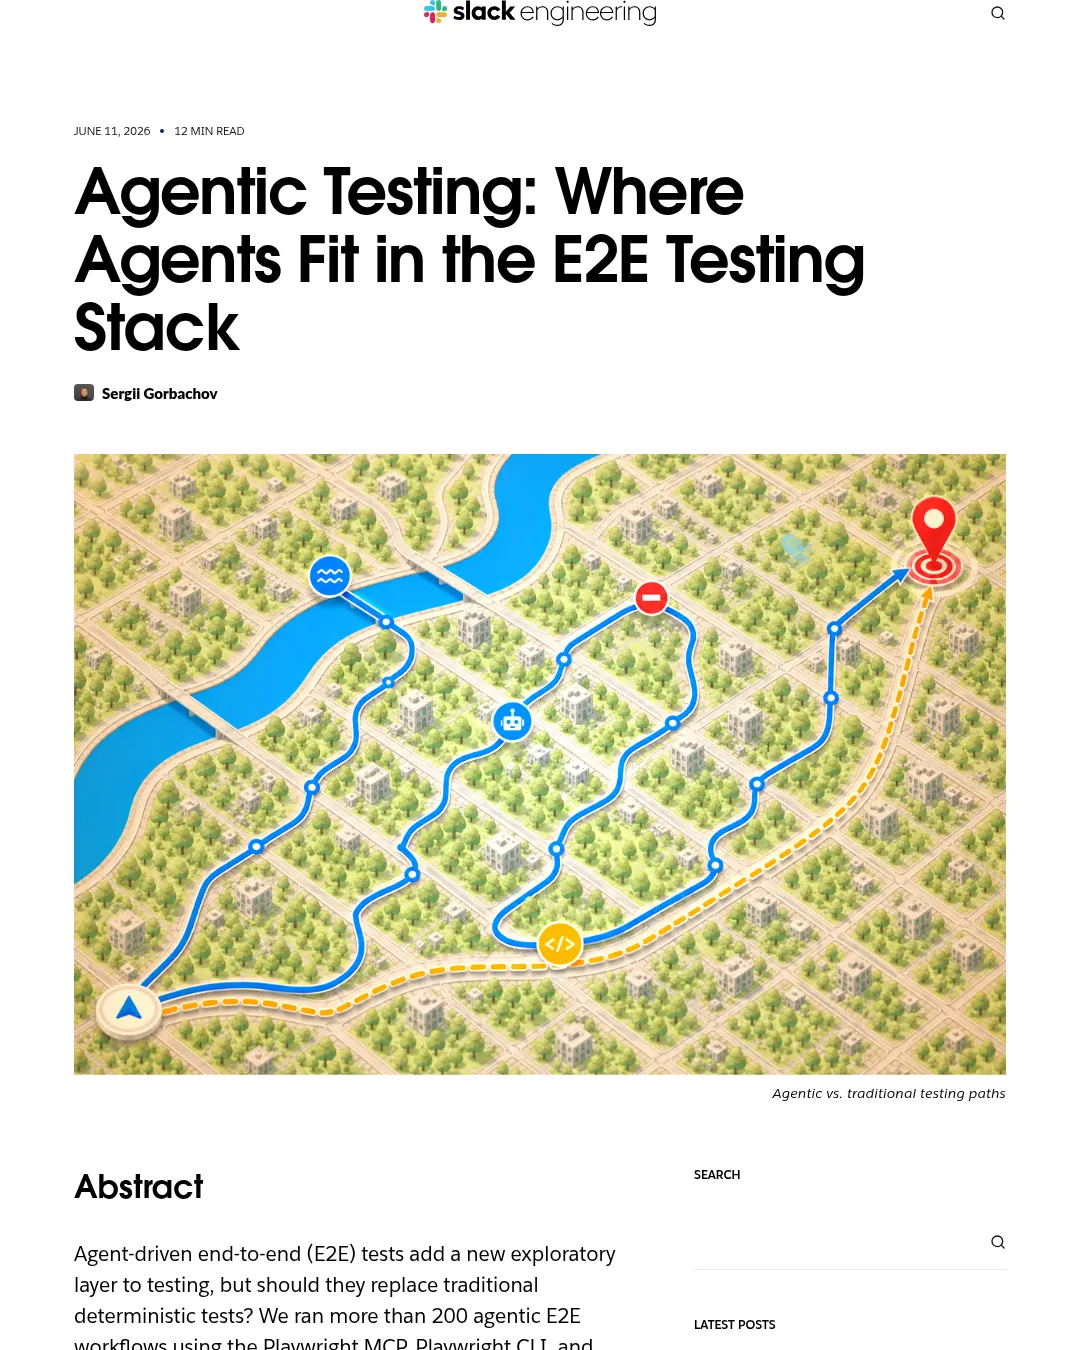
슬랙은 Playwright를 활용한 에이전트 기반 종단 간(E2E) 테스트를 200회 넘게 실행한 결과, 이 방식은 기존의 결정적 테스트를 대체하기보다 복잡한 UI 탐색과 디버깅에 보탤 수 있다고 밝혔다. 실험에서는 실행 방식에 따라 실패율과 속도, 비용이 달랐으며 에이전트 테스트는 실행당 15~30달러가 들어 고빈도 CI보다는 특정 문제를 조사하는 데 적합할 수 있다고 설명했다.
슬랙의 스태프 소프트웨어 엔지니어 세르기 고르바초프(Sergii Gorbachov)가 2026년 6월 11일 공개한 글은 Playwright MCP, Playwright CLI, 에이전트가 생성한 Playwright 테스트를 비교한다. 실험은 비프로덕션 데이터를 사용하는 테스트 워크스페이스에서 진행했다.
기존 E2E 테스트는 클릭 → 클릭 → 입력 → 검증처럼 UI를 통과하는 특정 경로를 확인한다. 에이전트 기반 테스트는 ‘스레드에 메시지를 보내라’ 같은 목표를 주고, 에이전트가 UI 상태에 맞춰 방법을 정해 목표 달성 여부를 검증한다. 실험에서도 전체 흐름은 로그인, 검색, 결과 확인, 검색어 지우기 등으로 유지됐지만, 검색 제안을 클릭하거나 Enter를 누르는 등 실제 조작 순서는 달라졌다. 검색을 다시 열거나 기존 상태를 재사용하고, 중간 단계를 더하거나 건너뛰기도 했다. 필요하다면 중간 단계도 검증할 수 있지만, 이런 유연성에는 신뢰성·비용·실행 시간의 절충이 따른다.
고르바초프는 에이전트 테스트가 한 번 실행하는 데 15~30달러, 10분 이상이 걸릴 수 있다는 점을 문제로 제시했다. 다만 200회가 넘는 실행에서 기존 테스트와 근본적으로 다른 방식으로 작동하며, 테스트 체계 안에 별도 역할이 있다고 봤다. 최근 대규모 언어 모델이 코드 작성과 실패 디버깅, UI 직접 조작을 지원하면서 새로운 테스트 실행 방식이 가능해졌지만, 기존 E2E 작업 흐름에서 어디에 둘지는 분명하지 않다는 설명이다.
실험 구성
실험은 여러 설정에서 자동 실행을 200회 넘게 수행해 신뢰성, 실행 속도, 비용을 비교했다. 평가한 방식은 세 가지다.
- 에이전트와 Playwright MCP: 미리 정의된 브라우저 동작으로 요소 클릭, 입력, DOM 상태 읽기 등을 수행한다. DOM 스냅샷과 로그를 포함한 맥락을 유지한다.
- 에이전트와 Playwright CLI: 셸에서 Playwright CLI 명령을 한 단계씩 실행한다. UI 상태가 바뀔 때마다 다음 동작을 결정한다.
- 생성된 Playwright 테스트: 에이전트가 자연어 설명에서 결정적 테스트 코드를 만들고 표준 E2E 테스트로 실행한 뒤, 통과할 때까지 반복해서 수정한다.
MCP와 CLI 에이전트에는 Claude Sonnet 4.5를 사용했고, 생성 테스트에는 Claude Opus 4.6을 사용했다. 비대화형 Claude Code(claude -p)로 실행했으며 브라우저 도구로 Playwright MCP와 Playwright CLI를 사용했다. 환경에는 Slack Dev API MCP를 포함했다. 모든 실험은 비프로덕션 데이터를 쓰는 테스트 워크스페이스에서 수행했다.
테스트 흐름은 복잡도가 다른 두 가지다. 간단한 ‘스레드 답글’은 채널을 만들고 메시지를 보내 스레드에서 답한 뒤 상태를 확인하는 약 15~20단계의 작업이다. 중간 복잡도의 ‘검색 탐색’은 검색어 입력, 결과 탐색, 검색·채널·스레드 화면 이동, 기대한 결과 확인으로 이뤄진 약 25~30단계의 작업이다. 직접 비교할 수 있도록 모든 실험에서 같은 흐름을 유지했다.
에이전트 기반 방식에는 자연어와 구조화된 YAML 두 입력 형식을 적용했다. 자연어 지시는 사람이 읽을 수 있는 상세한 설명으로 작업과 기대 결과를 제시하며, 단계별 목록으로 작성하는 경우도 있다. YAML은 같은 작업을 단계, 동작, 대상, 기대 결과로 명시한다. 차이는 상세함의 정도가 아니라 표현 방식이다. 자연어에서는 에이전트가 지시를 해석해 동작에 대응시키지만, YAML에서는 그 대응을 더 명시적으로 정한다.
각 설정은 20회씩 실행했다. 아래 표의 실험 5개 설정은 각각 두 테스트 흐름을 20회씩 수행한 구성이다.
| 실험 | 실행 방식 | 입력 형식 | 도구 | 스레드 답글 | 검색 탐색 |
|---|---|---|---|---|---|
| 1 | 에이전트(Playwright MCP) | 자연어 | MCP | 20 | 20 |
| 2 | 에이전트(Playwright MCP) | YAML | MCP | 20 | 20 |
| 3 | 에이전트(Playwright CLI) | 자연어 | CLI | 20 | 20 |
| 4 | 에이전트(Playwright CLI) | YAML | CLI | 20 | 20 |
| 5 | 에이전트(생성 테스트) | 자연어 | 코드 | 20 | 20 |
관찰 결과
자연어와 YAML 실행을 종합한 실패율과 평균 실행 시간은 다음과 같다.
| 방식 | 실패율(스레드 답글) | 실패율(검색 탐색) | 평균 실행 시간 |
|---|---|---|---|
| 에이전트(Playwright MCP) | 0% | 약 12% | 약 5~8분 |
| 에이전트(Playwright CLI) | 약 12% | 약 20% | 약 9~11분 |
| 생성된 Playwright 테스트 | 약 8% | 약 48% | 약 3분 |
신뢰성은 작업이 복잡해질수록 차이가 커졌다. 에이전트 기반 Playwright 흐름에서는 MCP가 더 안정적이었다. 간단한 시나리오에서는 실패율이 거의 0%였고, 복잡한 흐름에서도 0~12% 수준을 유지했다. CLI의 실패율은 대략 12~20%로 더 높았다. 실패 상당수는 모델의 추론보다는 인증 처리, 탐색 시점, 세션 불안정 같은 실행 문제에서 비롯됐다.
생성된 Playwright 테스트는 간단한 흐름에서 실패율이 약 8%로 무난했지만, 복잡한 작업에서는 약 48%로 나빠졌다. 테스트가 처음부터 잘못된 것은 아니었다. 대체로 흐름의 70~80%까지 진행한 뒤 마지막 조작이나 단언에서 실패했다. UI 상태의 변동과 추상화 불일치가 주된 원인이었다. 이 테스트들은 구체성이 낮은 자연어 흐름으로 생성됐고 기존 페이지 객체 추상화를 재사용했다. 복잡한 상황에서는 이 추상화가 정확한 요소 선택을 방해하기도 했다.
복잡도가 높아질수록 신뢰성 격차가 커졌으며, 실험에서는 MCP 같은 에이전트 중심 실행 방식이 어려운 흐름에서도 더 안정적인 동작을 보였다. 한 가지 가능한 이유는 상태 처리 방식이다. MCP는 앱의 현재 상태를 지속적으로 유지하는 반면 CLI는 각 단계에서 스냅샷으로 상태를 다시 구성한다. 흐름이 길어지면 UI 해석이나 타이밍의 작은 불일치가 쌓여 실패로 이어질 수 있다. 세션 안의 맥락도 영향을 줬을 가능성이 있다. MCP 실행에서는 에이전트가 같은 흐름의 앞 단계에서 성공한 조작을 재사용하는 듯했지만, CLI는 단계마다 처음부터 시작하는 것처럼 보일 수 있었다. 이 요인은 명시적으로 측정하지 않았으므로 가능성으로 제시됐다.
속도 면에서는 생성 테스트가 가장 빨랐다.
| 방식 | 평균 소요 시간 |
|---|---|
| 생성된 Playwright 테스트 | 약 3분 |
| 에이전트(Playwright MCP) | 약 5~8분 |
| 에이전트(Playwright CLI) | 약 9~11분 |
생성 테스트의 시간에는 테스트 생성과 실행이 모두 포함됐다. 각 테스트는 한 번 생성한 뒤 다섯 번 실행했고, 표의 수치는 실행 1회당 평균이다. 실제 테스트 실행만 보면 스레드 답글은 약 32초, 검색 탐색은 약 45초였다. CI처럼 테스트를 반복 실행하는 환경에서는 한 번 발생하는 생성 비용의 비중이 작아져 결정적 테스트를 더 효율적으로 확장할 수 있다. 반면 에이전트 기반 흐름은 실행할 때마다 비용이 든다. 각 단계에서 UI 상태를 관찰하고, 다음 동작을 추론한 뒤, 동작을 수행하고 결과를 확인해야 하기 때문이다.
에이전트가 UI를 탐색하는 방식도 일정하지 않았다. 실행의 약 20%만 동작 순서가 완전히 같았고, 대부분은 같은 목표에 도달하면서도 유효한 UI 경로를 다르게 찾았다. 메뉴를 여는 순서를 바꾸거나, 조금 다른 UI 요소를 선택하거나, 다른 탐색 흐름을 이용하는 식이다.
이를 측정하기 위해 실행 간 동작 시그니처를 비교했다. 동작 시그니처는 에이전트가 수행한 도구 호출과 UI 동작을 순서대로 나열한 것으로, API 호출·브라우저 클릭·양식 조작 등을 포함한다. 비교 전에는 매개변수, 대기·스냅샷 동작, fill과 type 같은 동등한 도구 변형을 묶어 의미 있는 순서 차이만 세었다. 최종 결과가 옳더라도 실행 대부분에서 동작 순서는 달랐다. 기존 E2E 테스트가 UI를 통과하는 하나의 결정적 경로를 강제한다면, 에이전트는 인터페이스를 탐색하면서 목표 상태에 도달하는지를 확인한다는 차이를 보여준다.
비용과 실행 환경
에이전트 기반 실행의 비용은 대체로 1회당 15~30달러였다. 이는 기존 테스트 실행보다 훨씬 비싸다. 비용이 어디서 발생하는지 파악하기 위해 같은 검색 탐색 흐름에서 실행 방식별 토큰 사용량을 분석했다.
| 방식 | 토큰 사용량 |
|---|---|
| MCP(Opus 4.6) | 약 380만 |
| MCP(Sonnet 4.5) | 약 350만 |
| MCP(Haiku 4.5) | 약 570만 |
| CLI(Opus 4.6) | 약 600만 |
| 코드 생성(Opus 4.6) | 약 700만 |
실험에서는 어떤 모델을 썼는지보다 에이전트를 어떻게 실행했는지가 토큰 사용량에 더 큰 영향을 줬다. Haiku는 Sonnet이나 Opus보다 토큰을 더 썼지만, 같은 흐름에서 MCP를 쓴 방식은 모두 CLI와 코드 생성 방식보다 토큰 사용량이 적었다.
고르바초프는 Claude Code가 에이전트 세션을 실행하는 방식도 살펴봤다. 기반 API는 상태를 유지하지 않으며, 매 차례 전체 시스템 프롬프트와 대화 기록을 다시 보낸다. 따라서 비용은 거의 무시할 만한 모델 출력보다 맥락이 얼마나 빨리 쌓이고 작업을 마치는 데 몇 차례가 필요한지에 좌우된다.
| 방식 | 대화 차례 수 |
|---|---|
| MCP(Opus 4.6) | 약 40 |
| MCP(Sonnet 4.5) | 약 40 |
| MCP(Haiku 4.5) | 약 60 |
| CLI(Opus 4.6) | 약 85 |
| 코드 생성(Opus 4.6) | 약 70 |
CLI는 평균 약 85차례를 사용했다. MCP의 약 40~60차례보다 많았다. CLI에서는 동작, 대기, 스냅샷, 읽기, 요소 찾기 등 하나의 브라우저 상호작용이 여러 명령으로 나뉘기 때문이다. MCP는 상호작용과 상태 반환을 한 번의 왕복으로 묶었다. 차례가 하나 늘 때마다 전체 시스템 프롬프트와 앞선 대화 맥락을 다시 보내야 한다.
MCP와 CLI에서는 브라우저 스냅샷이 맥락의 주요 부분을 차지했다. Playwright MCP는 브라우저 상호작용 결과에 접근성 트리 스냅샷을 포함하며, 그 내용이 이후 차례의 대화 맥락에 계속 쌓인다. 코드 생성 방식에서는 테스트 실행기가 재시도마다 출력하는 전체 오류 추적, 단언 실패, DOM 상태가 맥락을 누적시킨다.
분석 결과 비용의 대부분은 이미 본 내용을 다시 전송하는 데서 나왔다. 각 차례에서 새로 추가되는 정보는 토큰의 일부에 불과했다. 비용을 크게 좌우하는 요소는 모델의 추론이나 출력 생성보다 차례 수와 맥락의 증가 속도였다. 이 실험은 신뢰성과 동작에 초점을 맞췄기 때문에 토큰 사용량을 최적화하지 않았다. 프롬프트 캐싱, 맥락 압축, 스냅샷 빈도 줄이기 등을 비용 절감 기회로 제시했다.
비용을 고려하면 현재 에이전트 기반 테스트는 빈번한 CI 실행보다는 특정 문제를 디버깅하거나 탐색하는 테스트에 더 적합할 수 있다. 다만 향후 모델과 도구가 개선되면 비용이 낮아질 가능성도 있다고 덧붙였다.
실행 환경은 모델만큼 신뢰성에 영향을 줬다. MCP의 실패율은 0~12%, CLI는 12~20%였다. CLI 실행에서 많은 실패는 로그인 오류, 시간 초과, 세션 불안정 등 인증과 탐색 문제에서 나왔다. 따라서 상당수 실패는 에이전트의 추론보다 실행 계층에서 발생했음을 시사한다.
Playwright MCP는 구조화된 브라우저 기본 기능을 제공하고 에이전트의 도구 호출 흐름과 더 긴밀하게 통합된다. CLI 방식은 에이전트와 브라우저 사이에 추가 계층을 둔다. 병렬 실행도 달랐다. 이 설정에서는 MCP 실행을 쉽게 병렬화할 수 있었지만 CLI는 병렬화하기 어려워 대부분 순차적으로 실행했다. 결과적으로 신뢰성·속도·비용은 모델뿐 아니라 실행 환경의 안정성과 설계에도 달려 있다는 것이 실험의 결론이다.
실험은 단일 세션의 UI 작업을 대상으로 했다. 여러 워크스페이스를 가로지르거나 브라우저 창을 여러 개 여는 더 복잡한 시나리오는 다루지 않았다. MCP와 CLI 모두 이런 작업을 지원할 수 있지만 절충점은 다르다. 긴 흐름에서 관찰 반복이 늘어나면 MCP는 비용 문제가 생길 수 있고, CLI는 실험에서 확인한 높은 토큰 사용량에 더해 여러 브라우저 세션을 조정하는 복잡성이 생길 수 있다. 고르바초프는 이런 시나리오를 조사하지 않았지만, 에이전트 테스트를 검토하는 팀이 고려할 사항이라고 설명했다.
테스트 체계에서의 역할
고르바초프는 에이전트 기반 테스트가 기존 방식을 대체하는 것이 아니라 테스트 체계에 새로운 기능을 더한다고 봤다. 사람이 작성했든 AI가 생성했든 결정적 E2E 테스트는 빠르고 반복 가능하며 CI에 적합하고 운영 비용이 낮다. 대신 UI를 통과하는 특정 경로를 강제한다.
에이전트 테스트는 미리 정한 스크립트를 그대로 실행하지 않는다. UI를 관찰하고 현재 상태를 추론해 원하는 결과에 이르는 방법을 정한다. 따라서 복잡한 UI 동작 탐색, 불안정한 작업 흐름의 디버깅, 프로덕션 버그 재현에 활용할 수 있다.
시스템 관점에서 에이전트 테스트도 실제 UI를 통한 사용자 작업을 검증하므로 E2E 테스트와 같은 수준에서 동작한다. 차이는 작업을 실행하는 방식이다. 글은 CI의 안정적인 기반으로 결정적 테스트를 두고, 탐색·디버깅·복잡한 동작 검증을 위한 별도 상위 계층으로 에이전트 테스트를 더하는 조합을 제안한다.
고르바초프는 실험을 가능하게 한 도구와 지표 인프라를 만든 DevXP AI 팀, 실험을 지원한 매니저 데이브 해링턴(Dave Harrington)과 바니 아난타(Vani Anantha), 초기 아이디어부터 검증과 피드백까지 도운 Frontend Test Frameworks 팀에 감사를 전했다. 마지막 팀의 기여자로는 루시 청(Lucy Cheng), 나탈리 스토머언(Natalie Stormann), 루파 타나이스라지(Roopa Thanisraj), 일라리아 바리아레(Ilaria Varriale), 크레스센시오 줄(Crescencio Zul)을 언급했다.
댓글 (0)
로그인하면 이 기사에 내 생각을 남길 수 있어요