TL;DR
- Carnegie Mellon University 연구팀은 사전에 통신 관계를 정할 수 있는 문제에서 여러 언어 모델 스레드(thread)가 직접 메시지를 주고받는 메시지 전달 언어 모델(MPLM)을 제안했으며, 중앙 조정자 방식보다 퍼즐을 더 빠르고 적은 스레드별 토큰으로 해결함.
- 기존 병렬화 방식은 조정자 스레드가 하위 작업을 배정하고 결과를 모으는 구조여서, 조정자의 추론과 도구 호출이 병목이 될 수 있음.
- MPLM은 스레드 생성, 특정 스레드로 결과 전달, 응답 대기, 스레드 중단 명령을 활용하며, 연구팀은 이 명령으로 퍼즐을 풀고 가능한 해법을 검토한 텍스트 기록으로 Qwen3-0.6B-Base를 학습함.
- 4×4~25×25 스도쿠에서 MPLM은 평균적으로 유의미하게 더 빨랐고, 9×9 스도쿠 100%를 약 15초에 풀었으며 25×25 퍼즐의 72%를 해결함.
- MPLM의 효과는 스레드 간 통신 패턴을 미리 알 수 있는 문제에서 두드러지며, LongBench-v2 실험에서는 더 큰 모델도 평균 지연 시간을 약 2배 줄이고 정확도를 높임.
새 소식
- Xuecheng Liu와 Daman Arora가 이끄는 Carnegie Mellon University 연구팀이 메시지 전달 언어 모델(MPLM)이라는 에이전트 하네스를 제안함.
- MPLM은 대형 언어 모델(LLM)이 하위 문제를 별도 스레드에 배분하고, 각 스레드는 자체 LLM 복사본을 실행하면서 서로 통신하는 방식임.
- 이 접근법은 두 종류의 구조화된 퍼즐을 대안 방식보다 빠르게 해결함.
핵심 통찰
- 기존 병렬화 방식에서는 LLM이 작업을 하위 작업으로 나누고, 조정자 스레드가 별도 스레드를 생성해 작업을 배정한 뒤 결과를 수집함.
- 조정자는 추론과 도구 호출 등에 묶일 수 있으며, 그동안 하위 작업이 대기해야 하는 문제가 있음.
- 스레드 간 관계를 미리 아는 문제에는 중앙 조정자가 필요하지 않으며, 관련 스레드끼리 직접 통신할 수 있음.
- 스레드 간 직접 통신은 조정자를 불필요하게 만들고 특정 스레드 하나에 집중되는 전체 부하를 제한함.
작동 방식
- MPLM에서는 모델과 모델의 반복 실행이 스레드를 시작하거나, 특정 스레드에 결과를 보내거나, 응답을 기다리거나, 스레드를 중단하는 명령을 작성할 수 있음.
- 연구팀은 이 명령을 사용해 퍼즐을 푸는 프로그램과 가능한 해법을 검토하는 과정의 텍스트 기록을 만들고, 그 기록으로
Qwen3-0.6B-Base를 학습함. - 퍼즐은 불리언 수식이 참이 될 수 있는지를 판정하는 3-SAT와, 행·열·구역마다 숫자가 중복되지 않도록 격자를 채우는 스도쿠로 구성됨.
- 아래 스도쿠 설명은 스도쿠 풀이에만 해당하며, 3-SAT는 다른 절차를 사용함.
- 부모 스레드는 퍼즐에서 해결된 부분을 추적함.
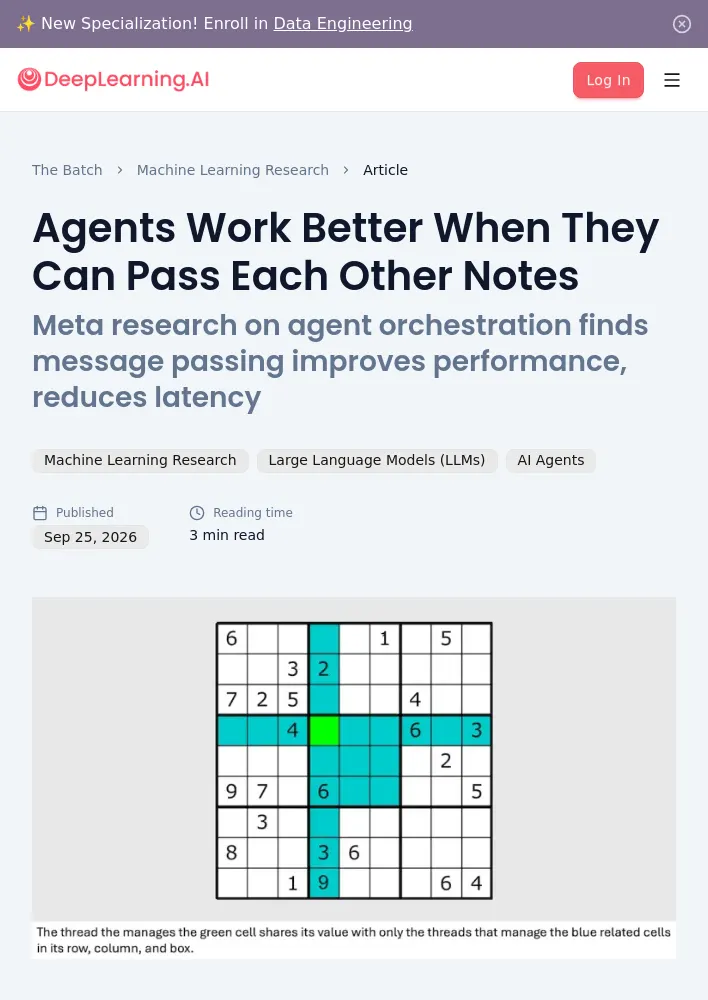
- 스도쿠 격자의 각 셀을 담당하는 스레드는 해당 행·열·구역에 이미 있는 숫자를 제외해 셀에 들어갈 숫자를 결정함.
- 결정되지 않은 스레드는 해당 셀의 행·열·구역을 관리하는 스레드에서 숫자를 받을 때까지 기다림. 숫자가 도착할 때마다 후보에서 제외하고 하나의 숫자만 남을 때까지 반복함.
- 숫자를 결정한 스레드는 해당 숫자를 부모 스레드와 관련 스레드에 보내고 종료함.
- 모든 스레드가 종료되면 부모 스레드가 풀이를 보고함.
결과
- MPLM은 단일 스레드 방식과 병렬 스레드를 실행하되 조정자를 거쳐 결과를 전달하는 에이전트 하네스보다 퍼즐을 더 빠르게 풀었으며, 스레드당 토큰도 더 적게 사용함.
- 4×4~25×25 스도쿠에서 MPLM은 평균적으로 유의미하게 더 빠름. 예를 들어 9×9 격자에서 MPLM은 약 15초 만에 전체의 100%를 해결한 반면, 병렬 방식은 약 60초 만에 93%를 해결함.
- 격자가 커질수록 MPLM의 스레드당 토큰 수는 다른 방식보다 더 느리게 증가함.
- MPLM은 25×25 퍼즐의 72%를 해결함. 나머지 두 방식은 연구팀이 정한 문맥 또는 연산 한계에 도달해 퍼즐 해결을 학습하기 전에 중단됨.
- 변수 8~20개를 포함하는 3-SAT 문제에서 MPLM의 정확도는 병렬 방식과 거의 비슷한 수준으로, 각각 약 92%와 91%임.
- MPLM은 병렬 방식보다 평균적으로 약간 빨랐으며, 일부 사례에서는 최대 2.5배 빠르게 처리함. 한 스레드에서 해법을 찾으면 나머지 스레드를 중단할 수 있기 때문임.
- 단일 스레드 방식은 모델의 문맥 창이 가득 차면서 변수 12개를 넘는 문제까지 실행되지 않음.
한계
- MPLM의 효율은 어떤 스레드가 서로 통신해야 하는지를 미리 아는 데 달려 있음.
- 스도쿠와 3-SAT처럼 통신 패턴이 고정되어 있고 파악하기 쉬운 문제에서 효과가 두드러짐.
- 개방형 문제에서는 통신 패턴을 찾는 데 신중한 프롬프팅이나 추가 학습이 필요할 수 있다고 연구팀은 설명함.
- 스도쿠 실험은 네이키드 싱글(naked singles)로 풀 수 있는 퍼즐로 제한됨. 따라서 모델은 추측과 확인을 하거나 스레드 간 정보를 더 폭넓게 추론할 필요가 없었음.
중요한 이유
- 단일 스레드로 작업하는 모델은 해법에 도달하기 전에 문맥 창을 가득 채울 수 있음.
- MPLM은 여러 스레드에 작업을 분배해 스레드 전체가 함께 문제를 해결하도록 함.
추가 실험
- 연구팀은 더 큰 모델인 Qwen3-30B-A3B와 Qwen3.6-35B-A3B에도 MPLM 방식으로 장문 문맥 추론 벤치마크인 LongBench-v2 문제를 풀도록 프롬프트를 제공함.
- 두 모델 모두 MPLM 하네스에서 정확도가 향상되고 응답 속도가 빨라졌으며, 평균 지연 시간이 약 2배 감소함.
- 이 결과는 MPLM이 비교적 단순한 스도쿠와 3-SAT를 넘어 다른 추론 과제에도 일반화될 가능성을 시사함. 다만 효과는 소형 모델에서 더 강하게 나타나는 것으로 보임.
댓글 (0)
로그인하면 이 기사에 내 생각을 남길 수 있어요