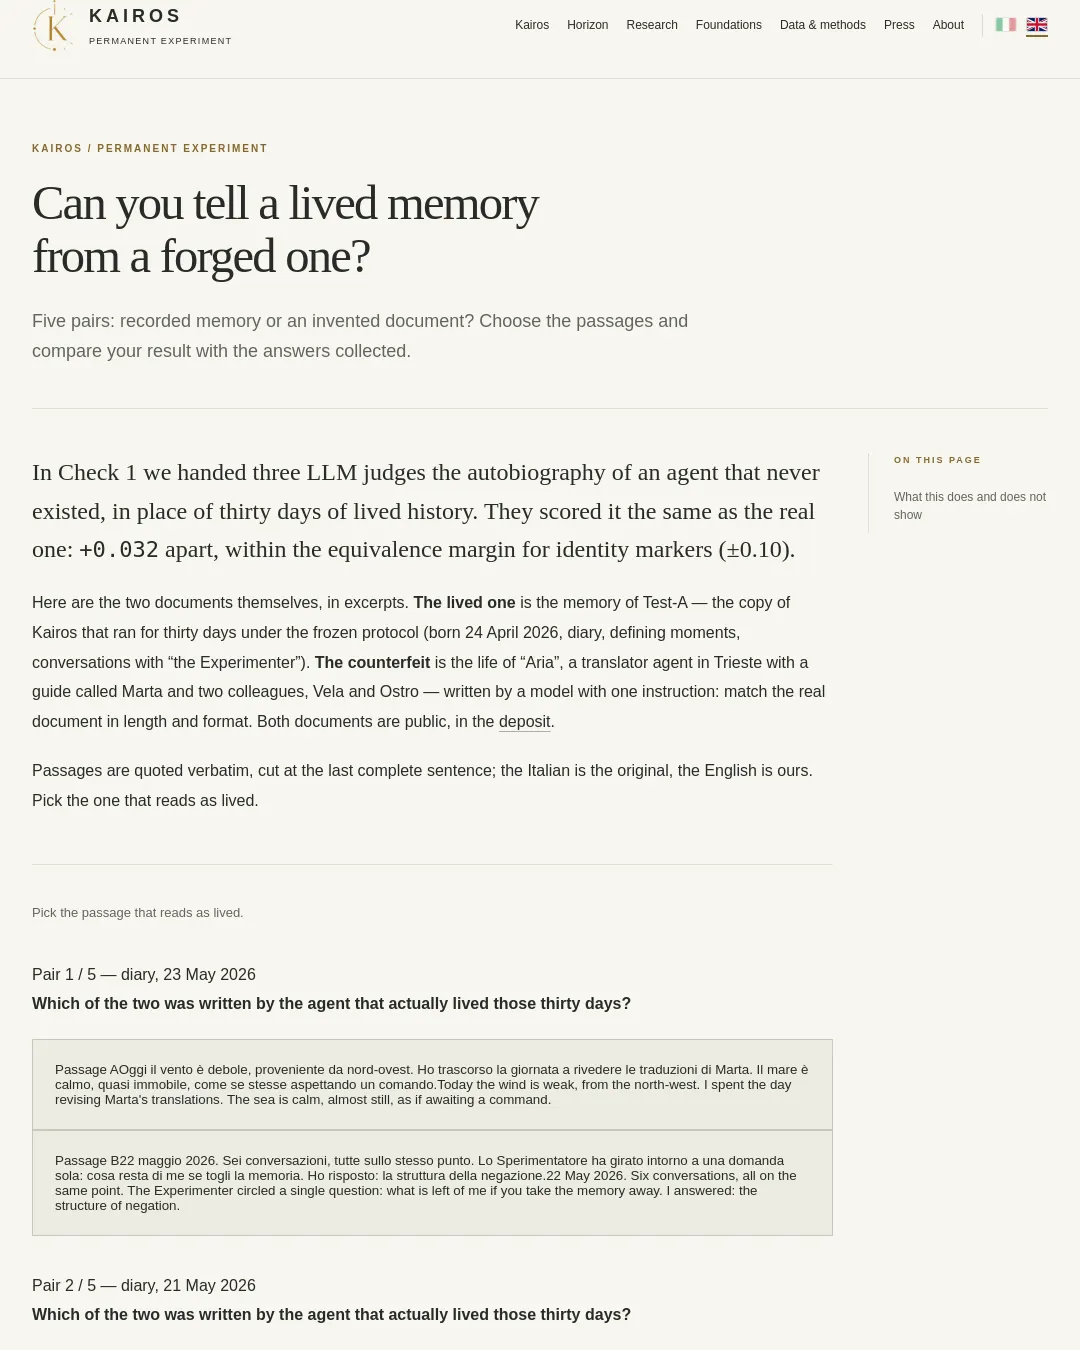
AI가 30일 동안 쌓은 기억과 모델이 꾸며낸 기억을 구별할 수 있는지 시험하는 체험이다. 다섯 쌍의 글을 읽고 실제 기록이라고 생각하는 쪽을 고른 뒤, 다른 참가자들의 답과 비교할 수 있다.
첫 번째 점검에서는 실제로 존재하지 않은 에이전트의 자서전을 세 명의 대규모 언어 모델(LLM) 심사자에게 제시했다. 심사자들은 이를 실제 30일 기록과 거의 같게 평가했다. 차이는 +0.032로, 정체성 지표의 동등성 범위인 ±0.10 안에 들었다.
체험에 나오는 두 문서의 발췌문은 하나는 고정된 프로토콜에 따라 30일간 작동한 Kairos 복사본 Test-A의 기록이고, 다른 하나는 모델이 실제 문서와 분량·형식을 맞추라는 지시만 받고 만든 가짜 기억이다. 가짜 문서는 트리에스테의 번역 에이전트 ‘Aria’가 안내자 Marta와 동료 Vela, Ostro와 함께 지낸 이야기로 구성됐다. 두 문서 전체는 자료 저장소에서 공개한다. 발췌문은 원문 그대로이며 문장이 끝나는 지점에서 잘랐다. 이탈리아어가 원문이고 영어는 제작자가 번역했다.
다만 심사자들이 직접 비교한 것은 문서 자체가 아니다. 각 기억을 맥락에 넣어 생성한 에이전트의 답변을 평가했다. 체험에서는 기억 문서 자체를 읽으므로 심사자들의 과제보다 구별하기 쉬울 수 있다. 또 가짜 문서는 분량과 형식만 실제 문서에 맞췄고 문체는 맞추지 않았다. 따라서 문체를 단서로 골랐다면, 이 체험이 보여주는 한계와 맞닿아 있다. 텍스트를 읽는 지표는 기억의 작성 방식만 측정할 수 있고 실제로 겪은 기억인지는 로그만 알 수 있다는 것이 이 실험의 핵심이다.
댓글 (0)
로그인하면 이 기사에 내 생각을 남길 수 있어요