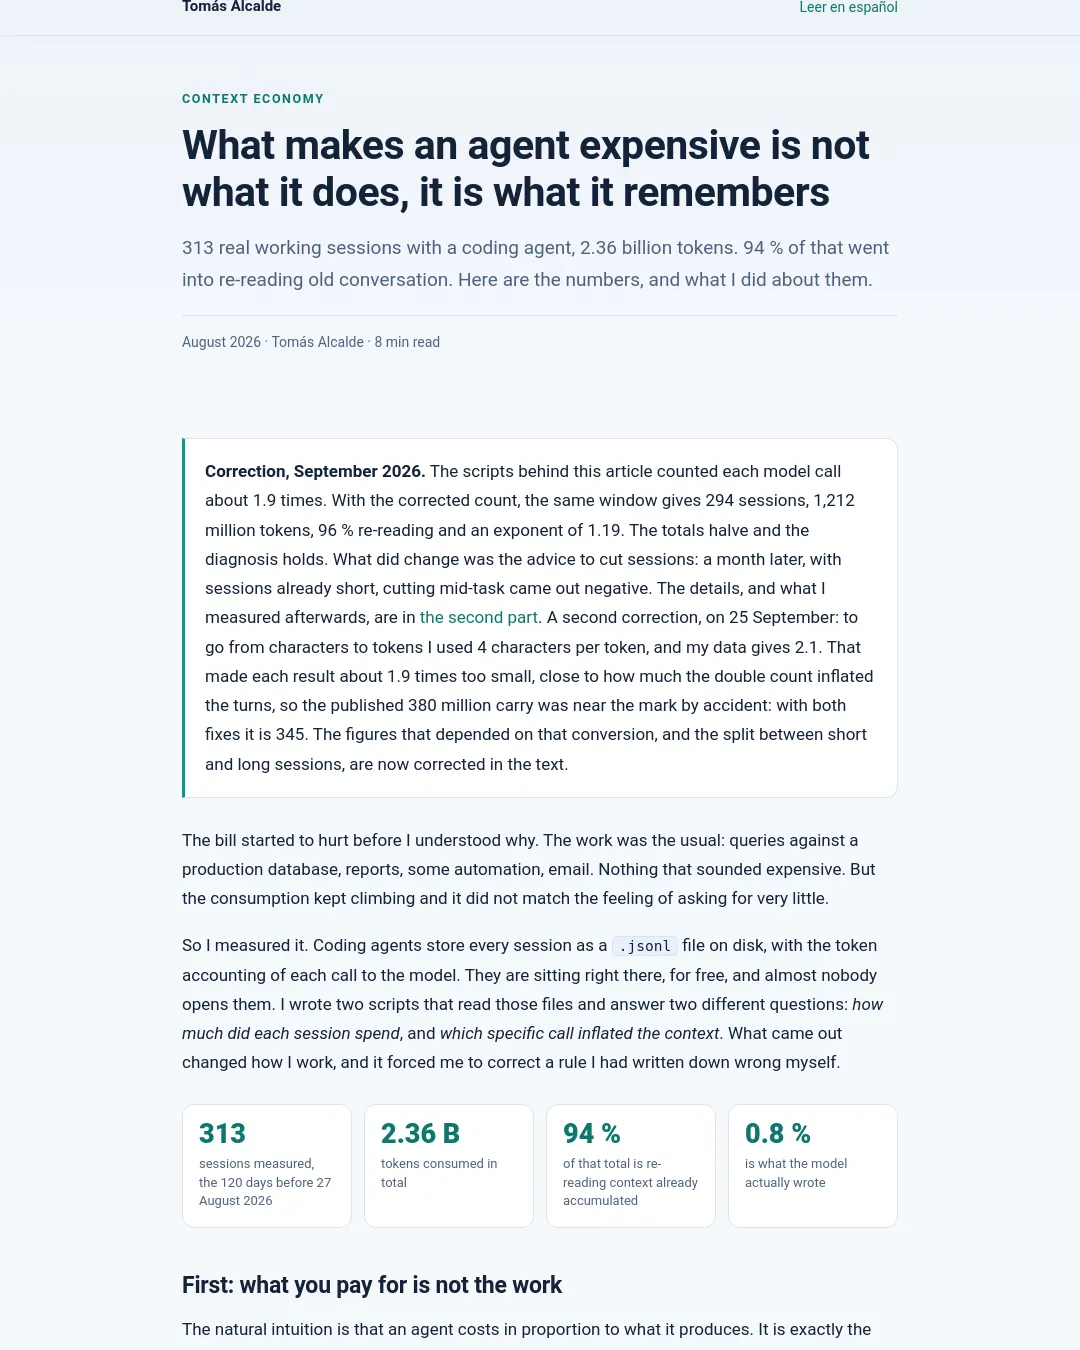
AI 코딩 에이전트의 비용은 새로 생성하는 답변보다 이전 대화와 도구 결과를 매번 다시 읽는 데서 커질 수 있다. 한 사용자가 2026년 8월 27일까지 120일간의 기록을 다시 계산한 결과, 294개 세션에서 12억 1,200만 토큰을 사용했고 그중 96%가 이미 쌓인 문맥을 다시 읽는 데 쓰였다.
이 수치는 정정된 결과다. 처음 공개한 분석 스크립트는 모델 호출을 약 1.9배 중복 집계했다. 9월 25일에는 문자에서 토큰으로 환산할 때 사용한 기준도 실제 데이터와 달랐다고 추가로 밝혔다. 두 정정을 반영하면 도구 결과가 이후 대화에 누적시키는 비용인 ‘캐리’는 3억 4,500만 토큰이다. 세션 비용 증가율을 나타내는 지수는 1.19로 수정됐다.
대화형 모델은 호출 사이에 대화를 기억하지 못하므로 매번 이전 대화 내용을 다시 받는다. 프롬프트 캐싱은 재독 비용을 낮추지만, 다시 읽는 문맥의 양 자체를 없애지는 않는다. 따라서 도구가 반환한 파일 내용이나 명령 결과도 문맥에 들어간 뒤 이어지는 턴마다 비용을 더한다. 크기가 작은 결과라도 일찍 들어와 오래 남으면, 나중에 추가된 큰 결과보다 총비용이 커질 수 있다.
분석에서 전체 파일 읽기는 캐리의 54%를 차지했다. 그중 상당 부분은 코드가 아니라 에이전트의 메모 파일이었다. 업무 정보를 기억시키려고 쌓은 메모도 관련 있을 때마다 통째로 불러오므로, 길어지면 변동 비용의 원인이 된다.
사용자는 문맥에 들어오기 전에 내용을 걸러내는 방식을 핵심 원칙으로 제시한다. 정규식과 주변 문맥을 활용해 필요한 부분만 보여주고, 표시할 문자 수에 상한을 두며, 전체 내용은 필요할 때 확인할 수 있도록 임시 파일에 저장하는 식이다. 이미 대화에 들어온 내용을 다음 턴에서 요약하는 것보다 처음부터 불필요한 내용을 넣지 않는 편이 낫다는 설명이다.
실천 방법으로는 주제가 바뀔 때 새 세션을 시작하고, 긴 결과물은 파일에 저장한 뒤 요약만 대화에 넣으며, 파일 전체 대신 grep 등으로 필요한 구간만 찾는 방법을 든다. 다만 세션을 나누는 것이 항상 이득은 아니다. 긴 세션에서는 분할이 비용을 줄일 수 있지만, 이미 짧은 세션에서는 매번 지침을 다시 보내는 비용 때문에 중간에 끊는 편이 오히려 불리할 수 있다고 9월 측정 결과를 덧붙였다.
이 분석은 칠레 남부의 한 회사에서 일하는 한 사람의 사용 기록에 기반하며, 연구 결과는 아니다. 에이전트 기록은 로컬 .jsonl 파일로 저장되고 호출별 usage 정보가 포함돼 있어, 별도 업체 분석 도구 없이도 세션별 사용량과 비용이 누적되는 도구 호출을 살펴볼 수 있다고 설명한다. 분석 스크립트와 차트는 context-economy 저장소에 공개돼 있다. 기록 기간을 고정해 실행하는 명령은 다음과 같다.
python graficos_articulo.py --dias 120 --hasta 2026-08-27
정정된 분석과 짧은 세션에서 비용을 줄이는 방법은 두 번째 글에서 다룬다.
댓글 (0)
로그인하면 이 기사에 내 생각을 남길 수 있어요