TL;DR
- 대형 언어 모델(LLM) 에이전트가 Triton 커널을 NVIDIA PTX로 직접 변환하는 AI 로워링을 수행하며, 평가한 커널에서 자동 튜닝된 Triton 대비 0.83~3.34배 성능을 달성함.
- Ada, Hopper, Blackwell 그래픽처리장치(GPU)의 일반 커널 12개와 최근 머신러닝 논문의 커널 10개를 대상으로 성능을 평가함.
- BitDelta의 패킹된 이진 가중치 디코딩, FlashAttention의 소프트맥스 행 배정, 합성곱 윈도 재사용 등 기존 Triton 로워링이 수행하지 않는 변환에서 가장 큰 성능 향상이 나타남.
- Blackwell의
tcgen05텐서 코어 인터페이스를 검증할 수 있도록 기존 PTX 검증기 Volta를 확장하고, 텐서 메모리와 비동기 실행 등 아키텍처 기능을 모델링함. - 결과는 AI 컴파일러가 맞춤형 중간 표현과 검사기를 대체해 새 범용·맞춤형 칩용 소프트웨어 개발에 드는 시간과 엔지니어링 노력을 줄일 가능성을 제시함.
논문 정보
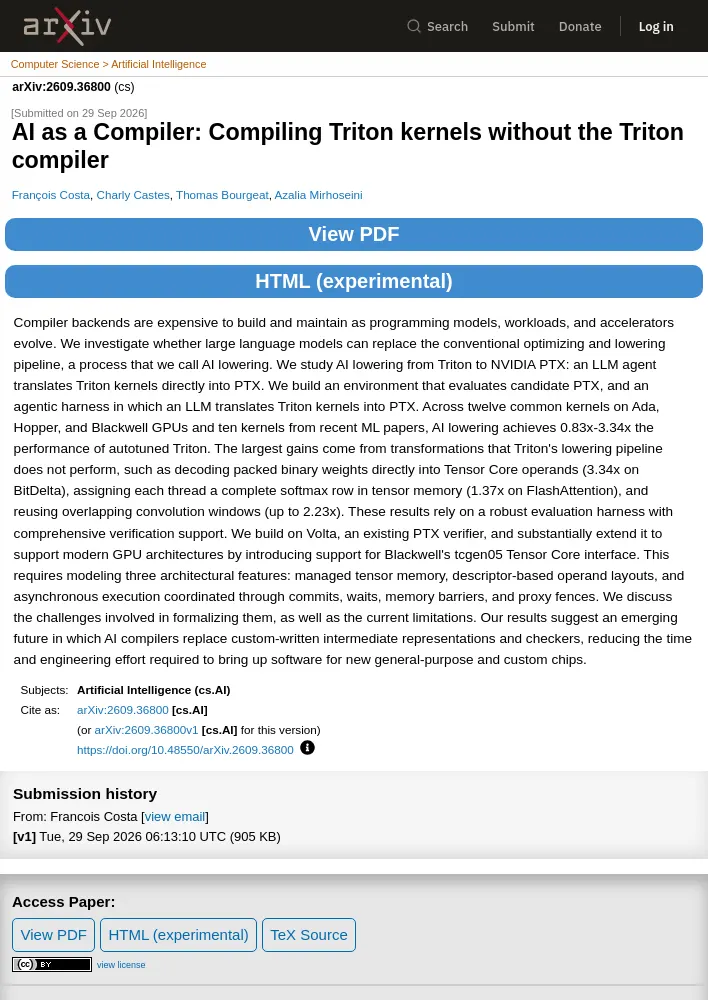
- 논문 제목은 “AI as a Compiler: Compiling Triton kernels without the Triton compiler”이며, François Costa, Charly Castes, Thomas Bourgeat, Azalia Mirhoseini가 작성함.
- arXiv 식별자는 2609.36800이며, 제출일은 2026년 9월 29일임.
- DOI: https://doi.org/10.48550/arXiv.2609.36800
연구 배경과 접근 방식
- 컴파일러 백엔드는 프로그래밍 모델, 워크로드, 가속기가 변화함에 따라 구축과 유지보수에 많은 비용이 듦.
- 기존 최적화 및 로워링 파이프라인을 대형 언어 모델이 대체할 수 있는지 조사하고, 이 과정을 AI 로워링(AI lowering)이라고 정의함.
- Triton에서 NVIDIA PTX로의 변환을 연구 대상으로 삼아, LLM 에이전트가 Triton 커널을 PTX로 직접 변환하는 환경과 에이전트 하네스를 구축함.
- 후보 PTX 코드를 실행해 평가하는 환경을 마련하고, 결과 검증을 위한 포괄적인 지원을 갖춘 평가 하네스를 사용함.
성능 평가와 주요 변환
- Ada, Hopper, Blackwell GPU에서 흔히 사용되는 커널 12개와 최근 머신러닝 논문에서 가져온 커널 10개를 평가함.
- AI 로워링의 성능은 자동 튜닝된 Triton 대비 0.83~3.34배 범위임.
- 가장 큰 향상은 Triton의 기존 로워링 파이프라인이 수행하지 않는 변환에서 발생함.
- BitDelta에서는 패킹된 이진 가중치를 텐서 코어 피연산자로 직접 디코딩해 3.34배 성능을 달성함.
- FlashAttention에서는 각 스레드에 텐서 메모리의 소프트맥스 행 전체를 배정해 1.37배 성능을 달성함.
- 합성곱에서는 겹치는 윈도를 재사용해 최대 2.23배 성능을 달성함.
PTX 검증과 Blackwell 지원
- 기존 PTX 검증기인 Volta를 기반으로 삼고, 최신 GPU 아키텍처 지원을 위해 크게 확장함.
- Blackwell의
tcgen05텐서 코어 인터페이스를 지원하도록 다음 세 가지 아키텍처 기능을 모델링함. - 관리형 텐서 메모리
- 디스크립터 기반 피연산자 레이아웃
- 커밋, 대기, 메모리 배리어, 프록시 펜스로 조율되는 비동기 실행
- 해당 기능을 형식화하는 데 따르는 어려움과 현재의 한계를 논의함.
시사점
- 연구 결과는 AI 컴파일러가 맞춤형으로 작성된 중간 표현과 검사기를 대체할 수 있는 가능성을 시사함.
- 이러한 접근 방식은 새 범용 칩과 맞춤형 칩용 소프트웨어를 준비하는 데 필요한 시간과 엔지니어링 노력을 줄일 수 있음.
댓글 (0)
로그인하면 이 기사에 내 생각을 남길 수 있어요