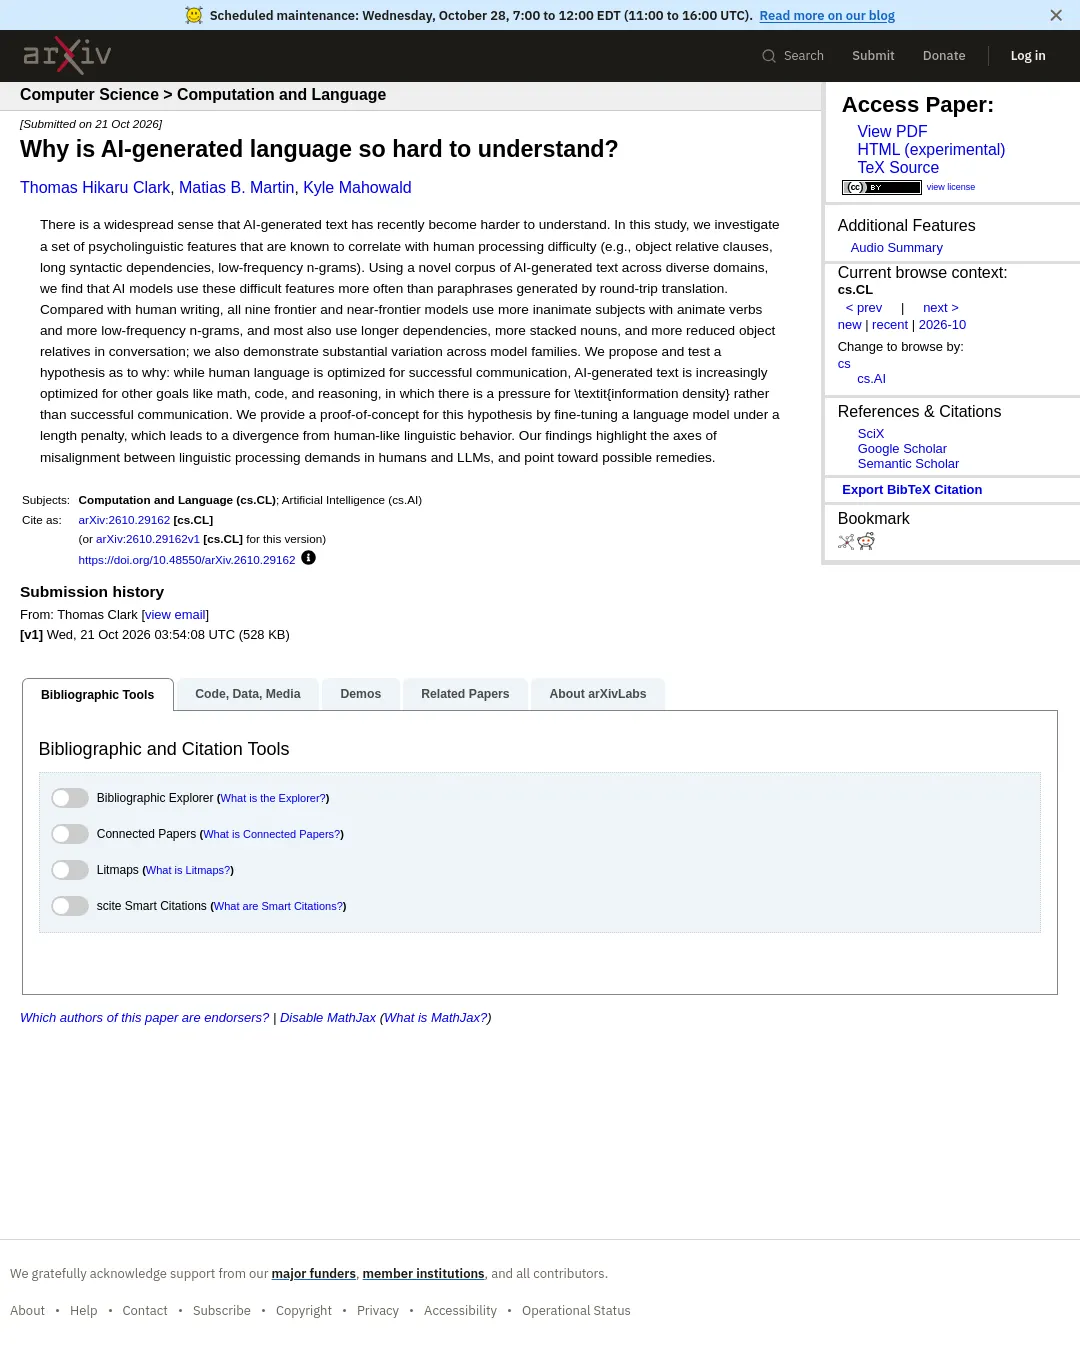
토머스 히카루 클라크(Thomas Hikaru Clark), 마티아스 B. 마틴(Matias B. Martin), 카일 마호월드(Kyle Mahowald)가 수행한 연구에 따르면, 분석한 최신·준최신 모델 9종은 사람 글보다 처리하기 어려운 언어적 특징을 더 자주 사용했다. 연구진은 AI가 의사소통의 명료성보다 수학·코드·추론에 필요한 정보 밀도를 추구하는 것이 한 원인일 수 있다고 제안했다.
연구진은 사람이 문장을 이해하는 데 부담을 주는 언어적 특징을 살폈다. AI가 생성한 다양한 분야의 글은 역번역으로 만든 바꿔쓰기 문장보다 이런 특징을 더 많이 포함했다. 사람 글과 비교했을 때 9개 모델 모두 무생물 주어와 생물 동사를 결합한 표현, 빈도가 낮은 단어 묶음을 더 많이 썼다. 대화에서는 대부분의 모델이 더 긴 문장 의존 관계, 명사 중첩, 축약된 목적어 관계절도 더 자주 사용했다. 모델 계열에 따른 차이도 컸다.
연구진은 언어가 사람 사이의 원활한 의사소통에 맞춰진 반면, AI 생성 문장은 수학·코드·추론 같은 다른 목표에 맞춰 최적화되고 있으며 이 과정에서 정보 밀도가 우선될 수 있다는 가설을 제시했다. 길이에 불이익을 주는 방식으로 언어 모델을 미세조정한 개념 증명 실험에서는 사람다운 언어 사용에서 벗어나는 현상도 나타났다. 연구진은 이 결과가 인간의 언어 처리 요구와 대규모 언어 모델의 목표 사이에 어긋남이 있음을 보여주며, 이를 줄일 방법을 모색할 필요가 있다고 설명했다.
논문은 arXiv에서 확인할 수 있다.
댓글 (0)
로그인하면 이 기사에 내 생각을 남길 수 있어요