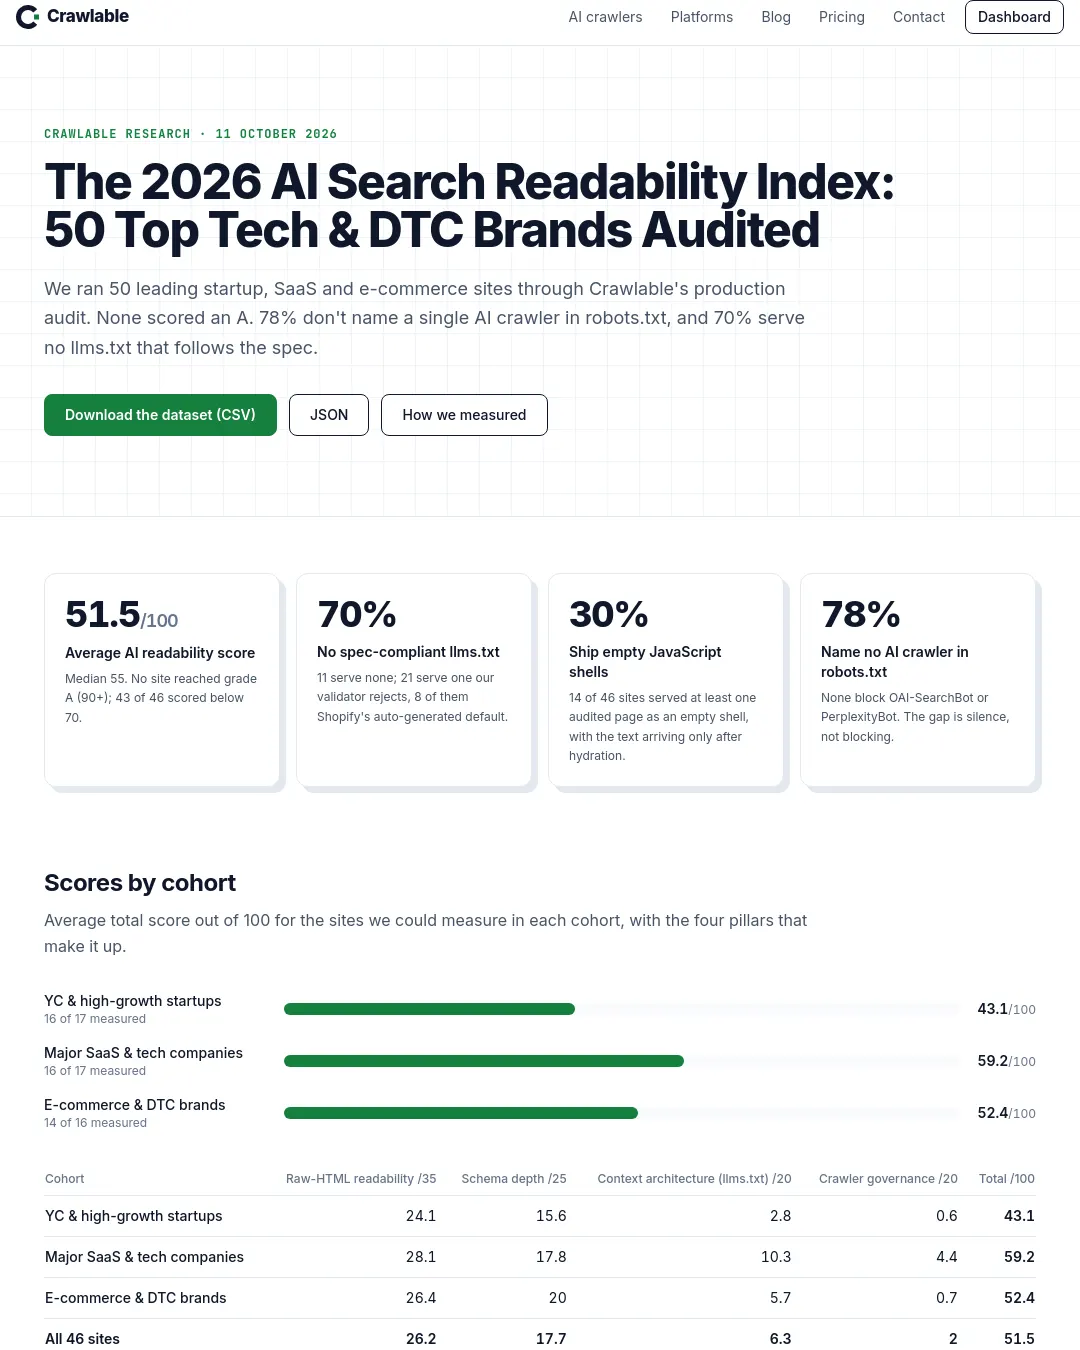
측정 가능한 사이트 46곳의 평균 AI 가독성 점수는 100점 만점에 51.5점이었다. A등급을 받은 사이트는 없었다.
Crawlable은 스타트업·소프트웨어 서비스·전자상거래 브랜드 50곳을 대상으로 AI 검색 가독성 조사를 했다. 조사 결과는 웹사이트를 운영하며 AI 검색 서비스가 자사 콘텐츠를 읽고 찾을 수 있게 하려는 팀에 참고가 된다.
AI 검색 가독성은 무엇을 재나?
웹페이지가 AI 크롤러에게 읽히고, 콘텐츠의 맥락과 접근 규칙을 얼마나 잘 제공하는지를 점수로 나타낸 지표다. 책의 본문과 목차, 열람 규칙을 각각 살펴보는 일에 빗대면 쉽다. Crawlable은 원시 HTML 가독성, 구조화 데이터, llms.txt, 크롤러 규칙을 합산해 100점 만점으로 평가했다.
Crawlable의 점수는 원시 HTML 가독성 35점, 구조화 데이터 25점, llms.txt 20점, 크롤러 관리 20점으로 구성됐다. 조사 사이트 중 43곳은 70점 미만이었다. 평균 점수는 주요 SaaS·기술 기업이 59.2점으로 가장 높았고, 전자상거래·DTC 브랜드가 52.4점, YC 및 고성장 스타트업이 43.1점이었다.
| 조사 그룹 | 측정 사이트 | 평균 점수 |
|---|---|---|
| YC 및 고성장 스타트업 | 17곳 중 16곳 | 43.1/100 |
| 주요 SaaS·기술 기업 | 17곳 중 16곳 | 59.2/100 |
| 전자상거래·DTC 브랜드 | 16곳 중 14곳 | 52.4/100 |
크롤러 규칙과 `llms.txt`는 어땠나?
측정된 사이트 46곳 중 36곳은 robots.txt에 AI 크롤러를 하나도 명시하지 않았다. 조사에서 어떤 사이트도 OAI-SearchBot이나 PerplexityBot을 홈페이지 경로에서 차단하지 않았다. Crawlable은 이를 차단이라기보다 별도 의사 표시가 없는 상태로 해석했다. 일반 규칙인 *가 적용되지만, 검색용 크롤러와 학습용 크롤러를 구분하는 정책은 드러나지 않는다는 것이다. 크롤러 관리 항목의 전체 평균은 20점 중 2점이었다.
llms.txt는 46곳 중 35곳이 제공했지만, Crawlable의 검사 기준을 통과한 파일은 14곳뿐이었다. 기준에는 # 제목, > 요약, ## 구역, 설명이 붙은 절대 링크가 포함됐다. 21곳의 파일은 이 가운데 하나 이상을 충족하지 못했고, 11곳은 파일을 제공하지 않았다. 기준 미달 파일 8개는 Shopify가 2026년 5월부터 기본 제공한 ‘Agent Instructions’였다. 이 파일은 상품 목록 안내보다 쇼핑 에이전트용 결제 엔드포인트를 설명한다고 Crawlable은 지적했다.
페이지 내용은 바로 읽을 수 있었나?
46곳 중 14곳은 조사한 페이지 가운데 적어도 하나가 빈 자바스크립트 셸 형태였다. 브라우저에서 자바스크립트를 실행한 뒤에야 텍스트가 나타나는 페이지다. Next.js를 사용하는 것으로 확인된 26곳 중 11곳에서도 이런 페이지가 하나 이상 나왔다. v0.app은 조사한 40개 페이지 가운데 37개가 셸이었다. 반면 46곳 중 10곳은 원시 HTML 가독성에서 35점 만점을 받았다.
구조화 데이터 항목은 46곳 중 27곳이 만점을 받았다. 예를 들어 상품 제안이 포함된 소프트웨어 애플리케이션 정보나 작성자 정보가 붙은 기사처럼, 개체의 세부 정보까지 제공한 경우다. 12곳은 조직·웹사이트 정보만 있거나 유효한 JSON-LD가 없었다.
결과를 어떻게 해석해야 하나?
Crawlable은 2026년 10월 11일 자체 운영 감사 도구의 커밋 5857303과 점수 체계 v2를 사용했다고 밝혔다. 수작업으로 점수를 매기지 않았으며, 사이트당 최대 40개 페이지를 사이트맵이나 홈페이지 링크에서 골라 45초 동안 한 번씩 원시 HTML로 가져왔다. 자바스크립트는 실행하지 않았다. 요청은 클라우드 서버에서 CrawlableBot/1.0 (+https://usecrawlable.com/bot; AI-readability auditor)라는 식별자로 전송됐다.
Perplexity.ai, Canva, Liquid I.V., Bombas는 봇 검사나 오류 페이지로 크롤러 요청을 거부해 평균에서 제외됐다. Crawlable은 이 결과만으로 해당 사이트가 각 운영자의 네트워크에서 접속하는 인증된 AI 크롤러를 어떻게 다루는지는 알 수 없다고 했다. 빈 자바스크립트 셸이 나온 경우에는 점수 상한이 64점으로 제한됐다. robots.txt는 홈페이지 경로의 규칙을 평가했다.
사이트는 바뀔 수 있어 지금 다시 조사하면 결과가 달라질 수 있다. 사이트별 점수와 거부된 llms.txt의 검증 사유는 CSV 데이터와 JSON 데이터에서 확인할 수 있다. 측정 방식은 조사 방법에, Next.js와 Shopify 관련 안내는 Next.js 가이드와 Shopify 가이드에 있다. 원문은 이 점수와 지표가 AI 검색 노출이나 성과에 미치는 영향을 밝히지 않는다.
댓글 (0)
로그인하면 이 기사에 내 생각을 남길 수 있어요