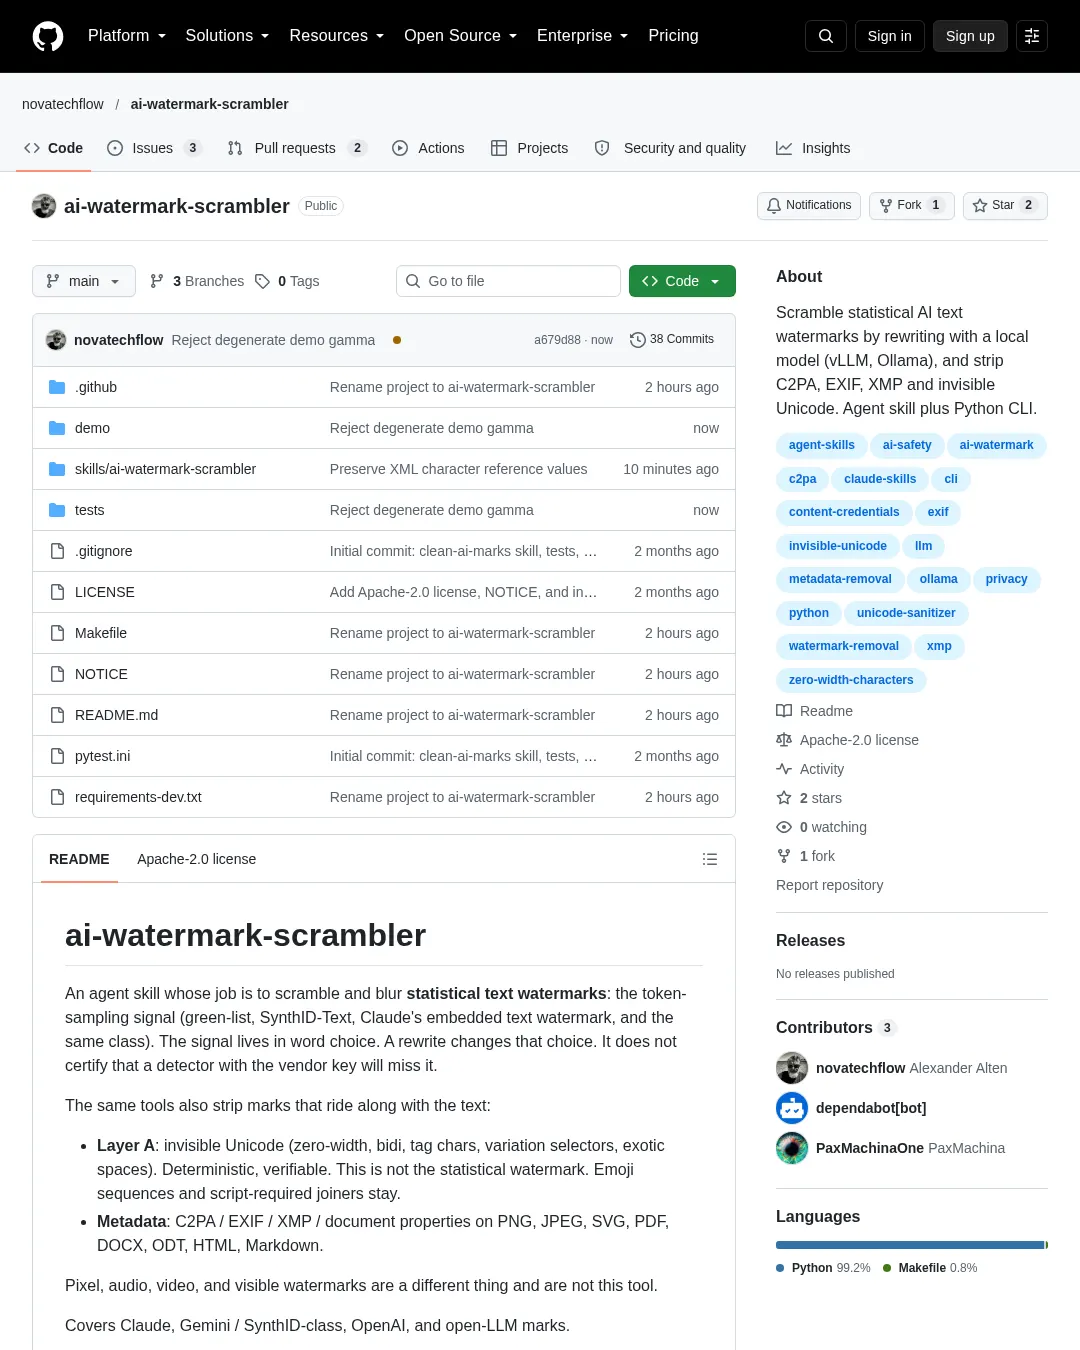
ai-watermark-scrambler는 텍스트의 통계적 워터마크를 흐리고 파일의 일부 보이지 않는 문자와 메타데이터를 제거하는 에이전트 스킬이다. 다만 통계적 흔적이 사라졌다고 보증하지 않으며, 픽셀·오디오·비디오·눈에 보이는 워터마크는 처리하지 않는다.
이 도구는 그린 리스트, SynthID-Text, Claude의 내장 텍스트 워터마크와 같은 토큰 샘플링 방식의 흔적을 대상으로 한다. 이런 신호는 단어 선택에 들어가므로 문장을 다시 쓰면 약해질 수 있지만, 업체 키를 가진 탐지기가 더는 찾아내지 못한다는 인증은 아니다. Claude, Gemini·SynthID 계열, OpenAI 및 오픈 LLM의 표시를 다룬다고 저장소는 설명한다.
별도 기능인 Layer A는 제로폭 문자, 양방향 문자, 태그 문자, 변형 선택자, 특수 공백 등 보이지 않는 유니코드를 결정론적으로 제거하고 결과를 확인할 수 있게 한다. 이는 통계적 워터마크와 다른 종류의 흔적이다. 이모지 시퀀스와 문자 체계에 필요한 결합 문자는 보존한다. 파일 메타데이터 기능은 PNG, JPEG, SVG, PDF, DOCX, ODT, HTML, Markdown의 C2PA·EXIF·XMP·문서 속성을 대상으로 한다.
텍스트 워터마크와 다시 쓰기
통계적 워터마크는 글자 사이에 별도 표시를 숨기는 방식이 아니다. 모델이 다음 토큰을 고를 때 특정 토큰을 선택하도록 편향을 준다. 그린 리스트 방식은 최근 토큰과 비밀 키를 해시해 어휘를 그린 목록과 레드 목록으로 나누고, 그린 토큰의 로짓을 조금 높인다. 문장은 자연스럽게 읽히지만 그린 토큰이 우연보다 많이 나타나는 것이 신호가 된다. 키를 가진 탐지기는 초과분을 세어 z 점수로 바꾼다. 긴 글일수록 판정하기 쉽고 짧은 글은 그렇지 않은 경우가 많다. 자세한 내용은 Kirchenbauer 외, 2023에 소개돼 있다.
SynthID-Text는 토너먼트 샘플링을 이용해 키가 부여된 점수로 후보 토큰을 고른다. Anthropic은 Claude의 내장 텍스트 워터마크가 텍스트에 섞여 복사·붙여넣기 뒤에도 남으며, 바꿔 쓰기·번역·큰 폭의 편집을 거치면 약해진다고 설명한다. 알고리즘과 키는 공개되지 않았다. Anthropic 도움말에 따르면 텍스트 표시 탐지는 비공개 프리뷰다.
문맥 해시 방식은 앞선 토큰을 바탕으로 그린 목록을 다시 만든다. 반면 문맥과 무관한 유니그램 워터마크는 각 토큰을 따로 그린색 또는 빨간색으로 칠한다. 이 방식은 단어 하나를 고쳐도 뒤의 목록이 바뀌지 않으므로 가벼운 편집을 더 잘 견딘다. 워터마크 편향은 모델이 실제로 선택할 여지가 있는 곳에 적용된다. 예측하기 쉬운 기능어를 강제로 바꾸면 문장이 어색해지므로 신호는 주로 purchase와 buy, approximately와 about처럼 내용어 선택에 실린다. 유니그램 방식은 Zhao 외, 2023에서 다룬다.
다시 쓰기는 탐지기가 찾는 ‘우연보다 많은 그린 토큰’의 증거를 줄인다. 문맥 해시 방식에서는 한 단어를 바꾸는 것만으로 뒤에 그린 목록이 다시 만들어져, 직접 바꾸지 않은 후속 단어도 탐지에 더는 기여하지 않을 수 있다. 문맥 독립 방식은 목록이 그대로이므로 바꾼 단어가 목록 밖의 대체어로 바뀐 경우에만 해당 단어에서 이득을 얻는다. 또한 같은 워터마크 모델에 텍스트를 다시 넣으면 이전 표시 대신 새 통계적 표시가 생긴다.
저장소의 rewrite_text.py는 토큰열을 얼마나 바꾸는지에 따라 네 가지 강도를 제공한다.
simplify: 내용어를 더 짧고 흔한 동의어로 바꾸되 순서는 유지한다. 동의어 치환은 문맥 해시 표시를 움직이지만 문맥 독립 표시는 남는 경우가 많다. 관련 연구는 Cheng 외, 2025다.paraphrase: 문장 순서는 유지하면서 표현을 새로 쓴다. DIPPER의 어휘 다양성 설정에 해당하며 Krishna 외, 2023을 참고한다.backtranslate: 다른 언어로 번역했다가 되돌린다. Kirchenbauer의 견고성 평가 방식이다.structural: 개요를 만든 뒤 새로운 표현과 문장 순서로 다시 쓴다. DIPPER의 순서 설정에 재구성을 더한 방식이다.
한 차례 다시 쓰는 것만으로 유니그램 워터마크가 탐지되지 않게 되는 경우가 많다고 단정할 수는 없다. 워터마크 모델에 질의해 그린 목록을 알아낸 뒤 단어를 바꾸는 공격은 이 스킬의 기능이 아니다. 관련 연구는 Wu와 Chandrasekaran, 2024, Jovanović 외, 2024다. 공격 방식과 이 도구가 다루지 않는 픽셀·가시적 표시의 세부 내용은 watermark-attacks.md에 있다.
저장소의 연구 하네스는 보유한 키로 문서를 생성하고 Layer A를 실행한 뒤, 키를 쓰지 않는 방식으로 다시 써서 그린 리스트 z 점수를 출력한다. 실험 설명과 기본 수치는 demo/README.md에 있으며 make qa로 다시 실행한다.
에이전트에 설치하고 사용하는 방법
저장소를 복제하는 것만으로 스킬이 에이전트에 로드되지는 않는다. 에이전트는 탐색 디렉터리에 있는 스킬만 읽으며 저장소 루트의 skills/는 그 디렉터리가 아니다. 스킬의 계약은 skills/ai-watermark-scrambler/SKILL.md에, 명령어·옵션·종료 코드·잔여 위험 표는 스킬 README에 있다.
Grok의 모든 프로젝트에 설치할 때는 make install-skill을 실행한다. 기본 위치는 ~/.grok/skills/ai-watermark-scrambler이며, SKILLS_DIR로 바꿀 수 있다. 이때 /ai-watermark-scrambler 명령을 사용할 수 있고, 설명과 요청이 맞으면 자동으로 불러온다. 저장소 안에서만 쓰려면 .grok/skills에 연결한다. Claude Code와 Cursor는 각각 ~/.claude/skills/ai-watermark-scrambler 또는 <repo>/.claude/skills/ai-watermark-scrambler, ~/.cursor/skills/ai-watermark-scrambler 또는 <repo>/.cursor/skills/ai-watermark-scrambler에 둘 수 있다. 이들도 같은 SKILL.md를 읽으며 Grok도 이 디렉터리를 탐색한다. Python을 실행할 수 있는 다른 에이전트는 skills/ai-watermark-scrambler/SKILL.md를 직접 지정할 수 있다.
# all Grok projects
make install-skill

# this repo only, so a clone is enough
mkdir -p .grok/skills
ln -sfn ../../skills/ai-watermark-scrambler .grok/skills/ai-watermark-scrambler

# Claude Code, all projects
mkdir -p ~/.claude/skills
ln -sfn "$(pwd)/skills/ai-watermark-scrambler" ~/.claude/skills/ai-watermark-scrambler
슬래시 명령 이름은 디렉터리 이름인 ai-watermark-scrambler다. 설명에 나오는 /remove-ai-marks, /remove-claude-marks는 별도 명령이 아니라 호출을 유도하는 문구다.
에이전트 작업 흐름은 다음과 같다. 먼저 inspect_file.py로 검사하며, 종료 코드 1은 표시를 찾았다는 뜻이지 명령 실패가 아니다. 다음으로 clean_file.py가 보이지 않는 유니코드와 파일 메타데이터를 제거한 *.cleaned.* 사본을 만든다. 이 단계는 통계적 워터마크를 건드리지 않는다. 산문에는 Layer B 다시 쓰기를 제안할 수 있다. rewrite_text.py --backend print-prompt는 프롬프트만 출력하며, 통계적 흔적을 바꾸려면 에이전트가 직접 다시 쓰거나 --backend ollama를 사용해야 한다. simplify는 더 약한 편집이다. 원문을 만든 모델과 다른 모델을 사용한다. 마지막으로 다시 검사하고, 무엇을 확인했는지와 어떤 다시 쓰기를 했는지, 통계적 신호가 완전히 사라졌다는 보증은 없다는 점을 알린다. make test와 make smoke는 스크립트를 점검하지만 에이전트가 스킬을 불러왔는지는 확인하지 않는다.
빠른 시작 명령은 다음과 같다.
make tools # optional extras (pikepdf, c2pa-python) into the skill venv
make test # pytest
make smoke # end-to-end CLI run over tests/fixtures

python3 skills/ai-watermark-scrambler/scripts/inspect_file.py notes.md
python3 skills/ai-watermark-scrambler/scripts/clean_file.py notes.md -o notes.cleaned.md
저장소 구조는 skills/ai-watermark-scrambler/ 아래에 에이전트용 SKILL.md, 사용자용 README.md, 표시 유형·업체별 안내·제거 범위·Claude 세부사항을 담은 references/, CLI 진입점과 지원 모듈을 담은 scripts/, 선택 의존성을 적은 requirements.txt가 있다. 루트에는 pytest 제품군과 픽스처가 있는 tests/, 그린 리스트 z 점수 연구 하네스가 있는 demo/, 그리고 tools, test, smoke, qa, install-skill, clean 대상을 제공하는 Makefile이 있다.
make tools는 skills/ai-watermark-scrambler/.venv를 만들고 선택 의존성을 설치한다. make test는 pytest를 실행하고, make smoke는 tests/fixtures를 대상으로 CLI 전체 흐름을 실행한다. make qa는 그린 리스트 연구 하네스를 실행하며, 설명은 demo/README.md에 있다. make install-skill은 스킬을 ~/.grok/skills/에 연결한다. make clean은 __pycache__, .pytest_cache와 두 가상환경을 제거한다.
의존성 설치 경로는 두 가지다. 호스트에 스킬만 설치하고 저장소는 받지 않은 경우 ensure_tools.py --install을 사용해 <skill>/.venv에 스킬 선택 의존성을 설치한다. 저장소를 개발할 때는 pip install -r requirements-dev.txt로 스킬 의존성과 pytest를 설치한다. requirements-dev.txt는 테스트 실행기만 추가하며 런타임에서는 읽지 않는다. 스킬은 자체 requirements.txt를 제공하고 전용 가상환경에 설치하므로 새 호스트에서 저장소에 있는 파일을 필요로 하지 않는다. 스크립트는 Python 표준 라이브러리만으로도 실행되며 선택 의존성은 기능이 제한되는 상태를 줄일 뿐 필수는 아니다.
pikepdf는 PDF 제거와 다시 쓰기에 쓰인다. 이것도 qpdf도 없으면 PDF 정리는 종료 코드 3으로 끝나며 제거 전 버전을 계속 읽을 수 있다. c2pa-python은 C2PA 매니페스트를 검사한다. exiftool은 pip 패키지가 아니므로 brew install exiftool 또는 apt install libimage-exiftool-perl로 설치한다. 도구 상태는 다음 명령으로 확인한다.
python3 skills/ai-watermark-scrambler/scripts/ensure_tools.py
테스트 제품군은 유니코드 및 컨테이너 정리, 이미지 메타데이터 처리, Layer B 다시 쓰기 연결부, ZIP 폭탄·심볼릭 링크 쓰기·경로 처리 관련 보안 속성, 실제 --help 출력과 문서화된 종료 코드·옵션을 대조하는 CLI 계약을 다룬다. pikepdf나 c2pa가 필요한 테스트는 해당 패키지가 없으면 건너뛰므로 선택 의존성이 있거나 없어도 제품군이 통과하도록 구성돼 있다. 저장소 루트에 가상환경이 있으면 make test는 .venv/bin/python을 쓰고, 없으면 python3를 쓴다. 스킬 가상환경 skills/ai-watermark-scrambler/.venv는 스크립트가 sys.path에 추가하므로 활성화할 필요가 없다.
CI는 푸시·풀 리퀘스트·수동 실행 때 make test와 make smoke를 실행한다. Python 3.11, 3.12, 3.13을 매트릭스로 사용한다. exiftool을 설치해 관련 분기를 시험하고, pip 선택 의존성 설치는 실패해도 빌드 실패로 처리하지 않는다. 테스트 제품군이 선택 의존성 없이도 동작하도록 설계됐기 때문이다.
적용 범위와 주의점
도구가 제거한다고 밝힌 항목은 보이지 않는 유니코드, 파일에 묶인 C2PA 매니페스트, EXIF·XMP·문서 속성 같은 컨테이너 메타데이터다. 유니코드와 C2PA는 다시 검사해 제거 여부를 확인할 수 있다. 통계적 텍스트 워터마크는 줄어들 뿐, 제거됐다고 증명할 수 없다. 소프트 바인딩 C2PA 매니페스트는 설계상 남는다. SynthID-media 같은 픽셀·오디오·비디오 워터마크, 로고나 스톡 이미지 표시 같은 눈에 보이는 오버레이, 데이터 기반 모델 백도어도 처리하지 않는다. 따라서 파일이 깨끗하다는 검사 결과가 AI 출처 정보가 전혀 남지 않았다는 뜻은 아니다. 결과에 의존하기 전에는 스킬 README의 잔여 위험 표를 확인해야 한다.
저장소는 자신이 소유하거나 처리 권한이 있는 파일의 공개 전 메타데이터 제거, 후속 처리·비교·검색을 방해하는 제로폭 문자의 정리, 워터마크 견고성 연구와 출처 표시 방식의 레드팀 점검을 사용 목적으로 든다. 공개 전 자신의 문서에서 GPS 좌표나 기기 일련번호가 들어갈 수 있는 EXIF, 작성자 이름과 편집 이력이 들어갈 수 있는 XMP·문서 속성, 예상하지 못한 시스템으로 복사될 수 있는 보이지 않는 유니코드를 제거하는 것은 일반적인 위생 작업이라고 설명한다.
반면 공개 의무를 피하기 위한 도구는 아니라고 밝힌다. 학술 제출물, 저널리즘, 법적 확인서처럼 사람이나 기관이 제작 방식을 솔직히 알 권리가 있거나 명시적인 AI 공개 정책이 있는 상황에서 표시를 제거해도 공개해야 할 사실은 달라지지 않는다. 표시를 지운다고 공개하지 않은 제출물이 정직해지는 것도 아니다. 결과는 최선 노력에 따른 것이며 보장이 아니다. 검사를 통과한 사실도 어떤 주장의 증거가 되지 않는다. 메타데이터 제거, 증거 취급, 문서 변조에 관한 현지 법률은 사용자가 확인해야 한다.
저장소는 Apache License 2.0으로 배포된다. LICENSE와 NOTICE를 참고할 수 있다. 저작권 표기는 Copyright 2026 Novatechflow다.
관련 연구·자료:
- Kirchenbauer 외, 2023, 대규모 언어 모델을 위한 워터마크: 그린 리스트, 로짓 편향, z 점수.
- Zhao 외, 2023, AI 생성 텍스트를 위한 검증 가능한 강건 워터마킹: 문맥 독립 유니그램 목록. 가벼운 편집으로 깨기 더 어렵다.
- Dathathri 외, 2024, 대규모 언어 모델 출력을 식별하는 확장 가능한 워터마킹, Nature: SynthID-Text.
- Krishna 외, 2023, 바꿔 쓰기로 AI 생성 텍스트 탐지기를 회피하기: DIPPER의 어휘·순서 다양성.
- Cheng 외, 2025, 자기정보량 다시 쓰기 공격으로 드러난 텍스트 워터마킹의 약점: 동의어 치환과 놀라운 토큰만 다시 쓰는 방식 비교.
- Wu와 Chandrasekaran, 2024, 색상 인식 치환으로 LLM 워터마크 우회하기: 워터마크가 적용된 모델이 필요하며 이 도구에는 구현되지 않았다.
- Jovanović 외, 2024, 대규모 언어 모델의 워터마크 탈취: 질의로 그린 목록을 학습하는 방식이며 이 도구에는 구현되지 않았다.
- Anthropic, Claude가 AI 생성 콘텐츠에 표시하는 방법: 내장 텍스트 워터마크와 C2PA. 텍스트 표시 탐지는 비공개 프리뷰다.
- C2PA 명세: 파일에 직접 묶인 매니페스트로, 통계적 텍스트 표시와는 다른 경로다.
댓글 (0)
로그인하면 이 기사에 내 생각을 남길 수 있어요