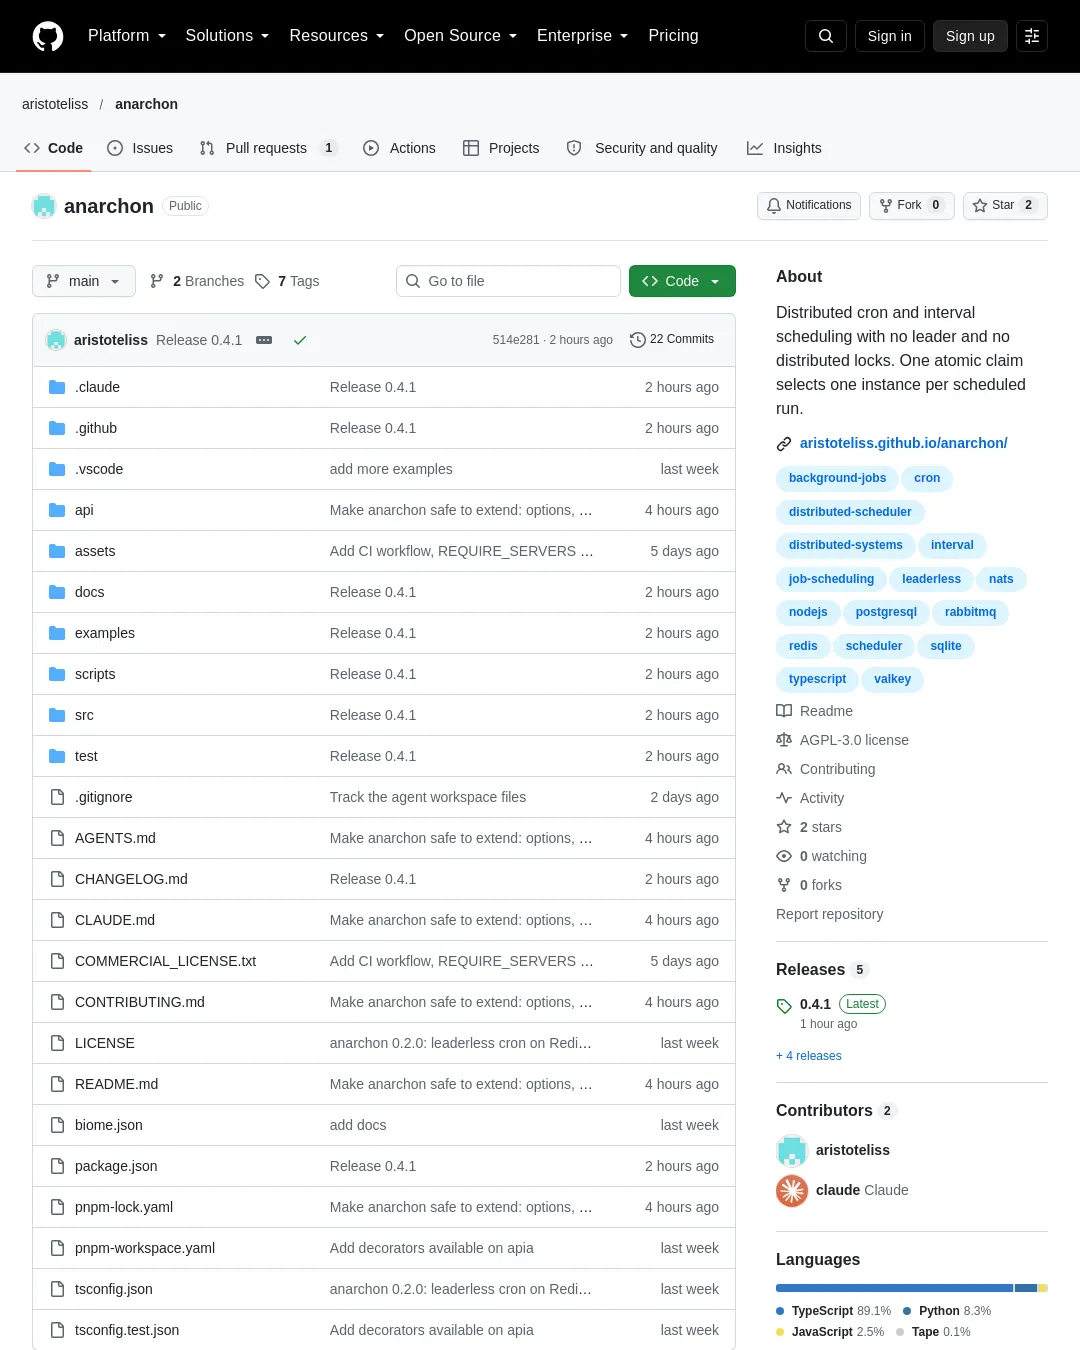
anarchon은 여러 Node.js 인스턴스가 같은 예약 작업을 등록해도 각 실행 시점(slot)마다 한 인스턴스만 작업을 시작하게 하는 스케줄러다. Redis, Valkey, PostgreSQL 또는 SQLite에서 원자적으로 실행 권한을 확보하며, 기본 lease 전략은 실행 인스턴스가 임대(lease) 갱신을 멈추면 백업 인스턴스가 작업을 다시 시작한다. 실패 뒤 최소 한 번 실행(at-least-once)을 보장하는 방식이지 부수 효과까지 정확히 한 번만 일어나게 하는 것은 아니다. 작업 핸들러는 멱등하게 작성해야 하며, 멈췄던 인스턴스가 깨어나면 대체 인스턴스와 잠시 겹칠 수 있다.
문서와 사용 예시는 프로젝트 저장소, 문서 사이트, 빠른 시작, 보장과 한계에서 확인할 수 있다.
설치와 빠른 체험
Redis를 사용하는 기본 설치 명령은 다음과 같다. npm install과 yarn add도 사용할 수 있다.
pnpm add anarchon redis
redis 패키지는 anarchon이 Redis 연결을 직접 열 때만 필요하다. 직접 만든 ioredis, iovalkey, node-redis, Valkey GLIDE 클라이언트도 전달할 수 있다. Redis 5 이상과 Valkey를 지원한다. 다른 저장소를 쓰려면 해당 드라이버를 설치한다.
pnpm add anarchon pg # PostgreSQL (or bring your own pg / postgres.js client)
pnpm add anarchon # SQLite with node:sqlite (Node 22.13+), or add better-sqlite3 / @libsql/client
pnpm add anarchon amqplib # RabbitMQ
pnpm add anarchon @nats-io/transport-node @nats-io/jetstream # NATS JetStream
저장소 설정은 필수다. 기본 저장소를 가정하지 않으므로 new Scheduler()만 호출하면 오류가 난다. 예를 들어 RedisBackend를 지정한 뒤 every, cron, at으로 반복·크론·일회성 작업을 등록한다. 동일한 코드를 모든 인스턴스에서 실행하면 된다. 예제는 PostgreSQL과 SQLite 구성도 다룬다.
서버를 따로 띄우지 않는 데모는 SQLite 빠른 시작을 따르면 된다. 같은 컴퓨터에서 세 프로세스가 SQLite 파일 하나를 공유한다. 저장소의 Redis 예제는 Redis를 실행하고 터미널 세 개에서 각각 다음 명령을 실행한다.
pnpm install
npx tsx examples/basic.ts
REDIS_URL을 지정하지 않으면 예제는 redis://localhost:6379에 연결한다. sync 작업이 슬롯마다 한 인스턴스에서 실행되는 모습을 볼 수 있고, report를 실행 중인 인스턴스에서 Ctrl+C를 누르면 정상 인계(graceful handover)가 일어난다.
저장소의 examples/quick-start.ts는 한 컴퓨터에서 세 프로세스가 SQLite 파일과 4초짜리 작업을 공유하는 데모다. 저장소에서 npx tsx examples/quick-start.ts로 실행하며, 약 23초 동안 세 상황을 보여준다.
- 한 프로세스가 작업을 시작하고 나머지 둘은
taken으로 건너뛴다. - 실행 중인 프로세스에
SIGINT(Ctrl+C)를 보내면 작업을 넘긴다. 다른 프로세스가 두 번의 하트비트 안에 같은 작업을 두 번째 시도로 시작한다. - 실행 중인 프로세스에
SIGKILL(kill -9)을 보내면 즉시 인계하지 않는다. 다른 프로세스는 임대가 만료될 때까지 기다렸다가 약 3초 뒤 두 번째 시도로 작업을 시작한다.
데모는 임대를 3초, 하트비트를 0.5초로 설정해 인계를 빠르게 보여준다. 기본값은 각각 30초와 5초이므로 충돌 뒤 인계까지 약 30초가 걸린다. 인계된 작업은 이전 진행 지점에서 이어지는 것이 아니라 처음부터 다시 실행된다.
실행 조정 방식과 장애 처리
모든 인스턴스는 같은 실행 시각을 계산한다. 반복 작업은 1970년 UTC부터 센 시간 격자에 맞춘다. 따라서 every 10s는 :00, :10, :20에 실행된다. 크론 작업은 크론 표현식을 사용한다. 각 인스턴스는 슬롯 시각에 0부터 기본 2초인 jitterMs까지 무작위 지연을 더한 뒤 권한을 요청한다. 원자적 요청에서 한 인스턴스만 이기며, 승자는 임대 아래에서 작업을 실행하고 다른 인스턴스는 백업으로 대기한다. 이 방식은 모든 서버가 { name, intendedAt }을 고유 인덱스가 있는 컬렉션에 넣고 먼저 삽입한 서버가 이기는 Meteor의 SyncedCron과 유사하지만, anarchon은 임대를 더해 승자가 사라졌는지도 감지한다.
기본 lease 전략은 Redis 서버 시계 기준으로 임대를 기록한다. 기본 임대 시간 leaseMs는 30초, 갱신 간격 heartbeatMs는 5초다. 백업들은 실행이 끝나지 않았는데 임대가 만료되면 다음 시도를 요청하고, 한 인스턴스만 승리한다. 충돌한 실행은 최대 maxAttempts회(기본 3회) 시작한다. 다음 작업 실행 시각이 먼저 오면 이전 충돌 작업은 interrupted로 표시되고 새 작업이 이를 대체할 수 있다. 일반적인 충돌 뒤 인계는 임대 한 번이 지난 시점에 일어나며, 최대 대기 시간은 leaseMs + 2 × heartbeatMs다.
stop() 때 작업이 ctx.signal의 중단에 예외를 던지면 실행 권한을 넘긴다. 백업은 다음 확인 시점, 즉 두 번의 하트비트 안에 작업을 인수하며 이 인계는 maxAttempts에 포함되지 않는다. 중단 신호를 무시하고 정상 반환하는 작업은 완료로 처리된다. 종료 제한 시간이 지나도 작업이 계속되면 임대 갱신을 멈추므로 임대 만료 뒤 백업이 인계한다.
같은 작업의 이전 실행이 유효한 임대를 보유하면 새 실행은 시작하지 않는다. overlap: 'allow'를 설정하면 겹쳐 실행할 수 있다. 임대는 잠금을 잡았다가 해제하는 방식이 아니며, 실행자가 멈춘 동안에는 인계 사실을 알 수 없어 두 시도가 잠시 겹칠 수 있다. 부수 효과 전에 ctx.signal을 확인하고 작업을 멱등하게 유지해야 한다.
시작할 때 각 인스턴스는 실행자가 사라진 미완료 작업을 먼저 처리한다. 이어서 마지막 실행 시각이 지나갔지만 아무도 권한을 얻지 못했고, 지연 시간이 catchUpMs(기본 5분)보다 짧으면 reason: 'catch-up'으로 실행한다. catchUpMs: 0은 따라잡기를 끈다. 너무 늦은 새 요청은 Redis 서버 시계로 거르므로 재연결 중 대기한 명령이 오래된 작업을 시작하지 않는다.
주요 실패 시 동작은 다음과 같다. 단순 stream-id 방식에서는 7초 작업을 3초마다 예약하면 세 복사본이 동시에 실행될 수 있고, 실행 중 승자가 죽으면 실행 기록이 running으로 남는다. 기본 lease 방식은 동시에 한 번만 실행하고, 그 사이 도래한 실행은 overlap 사유로 건너뛴다. 승자가 죽으면 백업이 임대 만료 뒤 두 번째 시도로 처리한다. 승자가 임대보다 오래 멈추면 백업이 인계하고, 기존 실행자가 깨어났을 때 ctx.signal이 중단되며 lost 이벤트를 낸다. 승자가 아닌 인스턴스의 재시작은 실행에 영향을 주지 않고, 재시작한 인스턴스는 백업이 될 수 있다. 정상 종료 신호 SIGTERM으로 승자를 멈추면 즉시 인계할 수 있다. 세 인스턴스가 모두 작업 중 종료돼도 재시작 뒤 두 번째 시도로 재실행한다. 작업 예정 시각에 세 인스턴스가 모두 내려가 있으면 단순 방식에서는 작업이 사라지지만, lease는 재시작 시 catchUpMs 안에 든 작업을 따라잡는다.
임대보다 긴 작업은 overlap: 'skip'일 때 계속 임대를 갱신하며 이후 실행을 막을 수 있다. timeoutMs를 설정해 제한해야 한다. 인스턴스 간 시계는 NTP로 동기화해야 한다. 실행 시각은 각 인스턴스의 시계를 따르고 임대는 Redis 서버 시계를 따른다. every()는 UTC 격자를 사용하며 특정 시간대의 벽시계 시각에는 cron()과 timezone을 사용한다.
저장소와 전략
Redis, Valkey, PostgreSQL, SQLite는 임대, 백업, 중복 방지, 따라잡기, 정상 종료 시 인계를 지원한다. RabbitMQ와 NATS는 각 실행에서 한 인스턴스만 고르는 기능은 제공하지만, 백업이 확인할 임대는 제공하지 않는다.
- Redis·Valkey는 Lua 스크립트 하나로 권한을 요청한다. 기본
lease는 Redis 5 이상 또는 Valkey가 필요하다. - PostgreSQL은 짧은 트랜잭션으로 요청하며 PostgreSQL 9.5 이상과
pg또는postgres.js클라이언트가 필요하다. - SQLite는
BEGIN IMMEDIATE트랜잭션을 사용한다. SQLite 3.35 이상과node:sqlite,better-sqlite3,@libsql/client중 하나가 필요하다. - RabbitMQ는 실행별 게이트 큐에 메시지 하나를 두고 게시 확인으로 먼저 권한을 얻은 쪽을 가린다. RabbitMQ 3.9 이상과
amqplib가 필요하다. - NATS는 JetStream 게시에
Nats-Msg-Id: <job>:<slot>을 사용해 중복 게시를 판별한다. JetStream과@nats-io/transport-node,@nats-io/jetstream이 필요하다.
SQLite는 같은 파일을 여는 프로세스끼리만 조정한다. 따라서 한 컴퓨터 또는 파일 잠금이 제대로 작동하는 볼륨에서 사용해야 하며 NFS는 지원 대상이 아니다. 여러 컴퓨터에서는 PostgreSQL이나 원격 URL을 사용하는 libSQL 서버를 이용한다. PostgreSQL과 SQLite는 시작 시 실행 기록 테이블을 만든다. 실행별 상태·임대는 anarchon_runs, 시도별 이력은 anarchon_runs_attempts에 저장한다. PostgreSQL은 anarchon_runs_jobs도 추가하며 두 저장소 모두 형식 정보를 anarchon_runs_meta에 둔다. 테이블 이름은 table 옵션으로 바꿀 수 있고 임대는 데이터베이스 시계를 사용한다.
RabbitMQ와 NATS는 실행을 기본 5분인 slotTtlMs 또는 duplicateWindowMs 동안 기억하므로 jitterMs + maxLateMs는 이보다 짧아야 한다. 작업 이름은 영문자, 숫자, _, -만 허용한다. 이력은 개수로만 보존하므로 historyTtlMs를 사용할 수 없다. 연결이 게시 중 끊겨 요청 응답을 잃으면 중복 실행을 피하기 위해 해당 인스턴스는 그 실행을 건너뛴다.
Redis의 기본 전략 lease는 백업, 중복 방지, 재시도, 따라잡기를 제공하는 유일한 전략이다. 비교·최소 구성용 전략은 다음과 같다.
stream-id: 슬롯을 Redis Stream ID로 추가하고 마지막 ID보다 새 ID여야 승리한다. Redis 5 이상 또는 Valkey가 필요하다.idmp: Redis 8.6 이상에서 멱등성 키로 첫 항목을 보존한다. Valkey에서는 지원하지 않는다.script: Lua로 스트림에서 슬롯을 확인한 뒤 없으면 추가한다. Redis 5 이상 또는 Valkey가 필요하다.
작업 등록, 실행 데이터와 기록
작업은 scheduler.every(name, interval, handler, options?), scheduler.cron(name, expression, handler, options?), scheduler.at(name, when, handler, options?)로 등록한다. 간격은 '10s', '35m', '1h30m' 또는 밀리초를 받을 수 있다. 크론은 5개 필드 또는 초를 앞에 둔 6개 필드를 사용하며, at()은 Date, 밀리초 또는 ISO 문자열로 한 번 실행할 시각을 받는다.
클래스 메서드에는 @Every, @Cron, @At 데코레이터를 쓸 수 있다. 프레임워크나 reflect-metadata, 별도 등록 호출은 표준 데코레이터에 필요하지 않다. 객체가 생성될 때 작업을 추가한다. 레거시 데코레이터("experimentalDecorators": true)는 객체 생성 시 코드를 실행할 수 없어 클래스에 @Scheduled()를 붙이거나 scheduler.register(object)를 호출해야 한다. Scheduler.configure({ backend, autoStart: true })로 자동 시작하거나 설정 후 Scheduler.startAll()을 호출할 수 있다. 직접 new Scheduler({ backend })를 만들고 start()해도 된다. 종료 때는 Scheduler.stopAll()을 호출한다.
작업은 서로 다른 스케줄러를 선택할 수 있다. 같은 이름을 지정한 작업은 하나의 스케줄러를 공유하고, 설정된 적 없는 이름은 기본 설정으로 만든다. 여러 테넌트 객체를 등록할 때는 prefix를 달리해 작업 이름 충돌을 막고, defaults로 시간대와 실행 데이터를 줄 수 있다. 접두사 없이 같은 클래스의 객체를 두 개 만들면 작업 이름이 중복돼 생성자가 오류를 낸다. 이름을 생략하면 Class-method가 되며 클래스·메서드 이름 변경이나 빌드 시 축약으로 작업 이력이 새로 생길 수 있다. 작업 이름을 명시하는 편이 안전하다.
작업 실행 데이터는 스케줄러, 작업, 개별 수동 실행 수준에서 제공할 수 있으며 핸들러에서는 ctx.data로 읽는다. 두 일반 객체는 병합하고 다른 값은 더 구체적인 값이 대체한다. 함수로 지정한 데이터는 실행 시작 때 읽는다. 데이터는 저장되거나 인스턴스 간 공유되지 않으므로 비밀값이나 클라이언트를 담을 수 있다. 데이터 함수가 예외를 내면 실행이 실패한다.
핸들러는 { name, slot, scheduledAt, instanceId, manual, attempt, reason, signal, data }를 포함한 컨텍스트를 받는다. attempt는 첫 시도에서 1이며 인계 뒤에는 2 이상이다. reason은 'scheduled', 'manual', 'catch-up', 'takeover' 중 하나다. signal은 종료, 시간 초과, 백업 인계 때 중단된다. 중단 시 ctx.signal.throwIfAborted()처럼 예외를 내야 종료된 실행을 완료로 기록하지 않고 넘길 수 있다.
작업 옵션에는 스케줄러 기본값을 덮어쓰는 jitterMs, maxLateMs, historySize, historyTtlMs가 있다. timeoutMs는 제한 시간 뒤 신호를 중단하고 실행을 실패로 표시한다. overlap 기본값은 'skip'이며 'allow'는 겹친 실행을 허용한다. maxAttempts 기본값은 3이다. 종료 시 인계는 이 횟수에 포함되지 않는다. catchUpMs 기본값은 300000밀리초, offsetMs 기본값은 0이며 offsetMs는 every()에만 적용된다. timezone은 스케줄러 기본값을 따르거나 cron()에서 설정한다. 임대·하트비트와 함께 overlap, maxAttempts, catchUpMs를 쓰려면 임대를 지원하는 Redis·Valkey lease, PostgreSQL 또는 SQLite 백엔드가 필요하다. 다른 백엔드에서 설정하면 타입 단계에서 제공되지 않으며, 설정을 강제로 넣어도 오류가 난다. at()에는 overlap을 설정할 수 없다.
start()는 연결과 서버를 확인하고 작업을 예약하며 미완료·누락 실행을 처리한다. stop({ timeoutMs = 30000 })은 예약을 멈추고 신호를 중단한 뒤 실행 중 작업을 기다린다. anarchon이 연 연결은 닫으며 반환 뒤에는 Redis에 추가 요청을 보내지 않는다. runNow(name, { data }?)는 중복 제거 없이 현재 인스턴스에서 수동 실행하며 수동 실행은 재시도하지 않는다. remove(name)은 현재 인스턴스에서 해당 작업 예약을 멈춘다.
history(name, count)는 모든 인스턴스의 최근 시도를 최신순으로 반환하고, lastRun(name), nextRun(name), jobs()로 마지막 실행·다음 실행·현재 작업을 확인한다. 실행 기록에는 작업명, 슬롯, 예약 시각, 인스턴스 ID, 수동 실행 여부, 시도 번호, 실행 사유, 상태, 시작·종료 시각, 소요 시간, 오류가 포함된다. interrupted는 실행자가 죽거나 멈췄거나, 백업에 권한을 넘겼거나, 종료된 시도를 뜻한다. history()는 작업을 등록하지 않은 별도 API 프로세스에서도 모든 작업 이름에 대해 읽을 수 있다.
이벤트는 실행 시작의 start, 성공의 success, 실패와 원인의 failure, 실패가 아닌 중단의 interrupted, 건너뛴 이유(taken, late, overlap)를 알리는 skip, 백업 인계를 알리는 lost, Redis 문제를 알리는 error다. 오류 이벤트를 수신하는 리스너가 없으면 로그에 기록된다.
라이선스와 추가 자료
anarchon은 GNU AGPLv3와 별도 상용 라이선스를 제공하는 이중 라이선스 소프트웨어다. AGPLv3는 카피레프트 조건을 포함한다. 상용 라이선스는 AGPL 카피레프트 의무 없이 상용 제품에 통합할 수 있으며, 라이선스 사용자의 전 세계 총매출에 따른 연간 요금을 정한다. 도입 전에 AGPLv3 라이선스와 상용 라이선스 조건 및 요금표를 확인해야 한다. 라이선스 안내에는 매출 산정, 무료 등급 등록, 문의처에 관한 설명이 있다.
예제 목록에는 SQLite 빠른 시작, Redis·PostgreSQL 예제, HTTP API, 장애 인계, 데코레이터와 실행 데이터 예제가 있다. 테스트는 실제 서버를 사용하며 실행 중이 아닌 서버의 테스트는 건너뛴다. pnpm test:servers는 Redis 8.6·7.0, Valkey, PostgreSQL, libSQL을 시작하고 COMPOSE_PROFILES=brokers pnpm test:servers는 RabbitMQ와 NATS도 추가한다. pnpm test는 test/e2e를 제외한 테스트, pnpm test:slow는 실제 프로세스와 시계를 사용하는 클러스터·장애 테스트, pnpm test:all은 전체 테스트를 실행한다. pnpm scenarios는 Redis·PostgreSQL·SQLite에서 단순 권한 요청과 임대 전략의 장애 상황을 비교한다.
댓글 (0)
로그인하면 이 기사에 내 생각을 남길 수 있어요