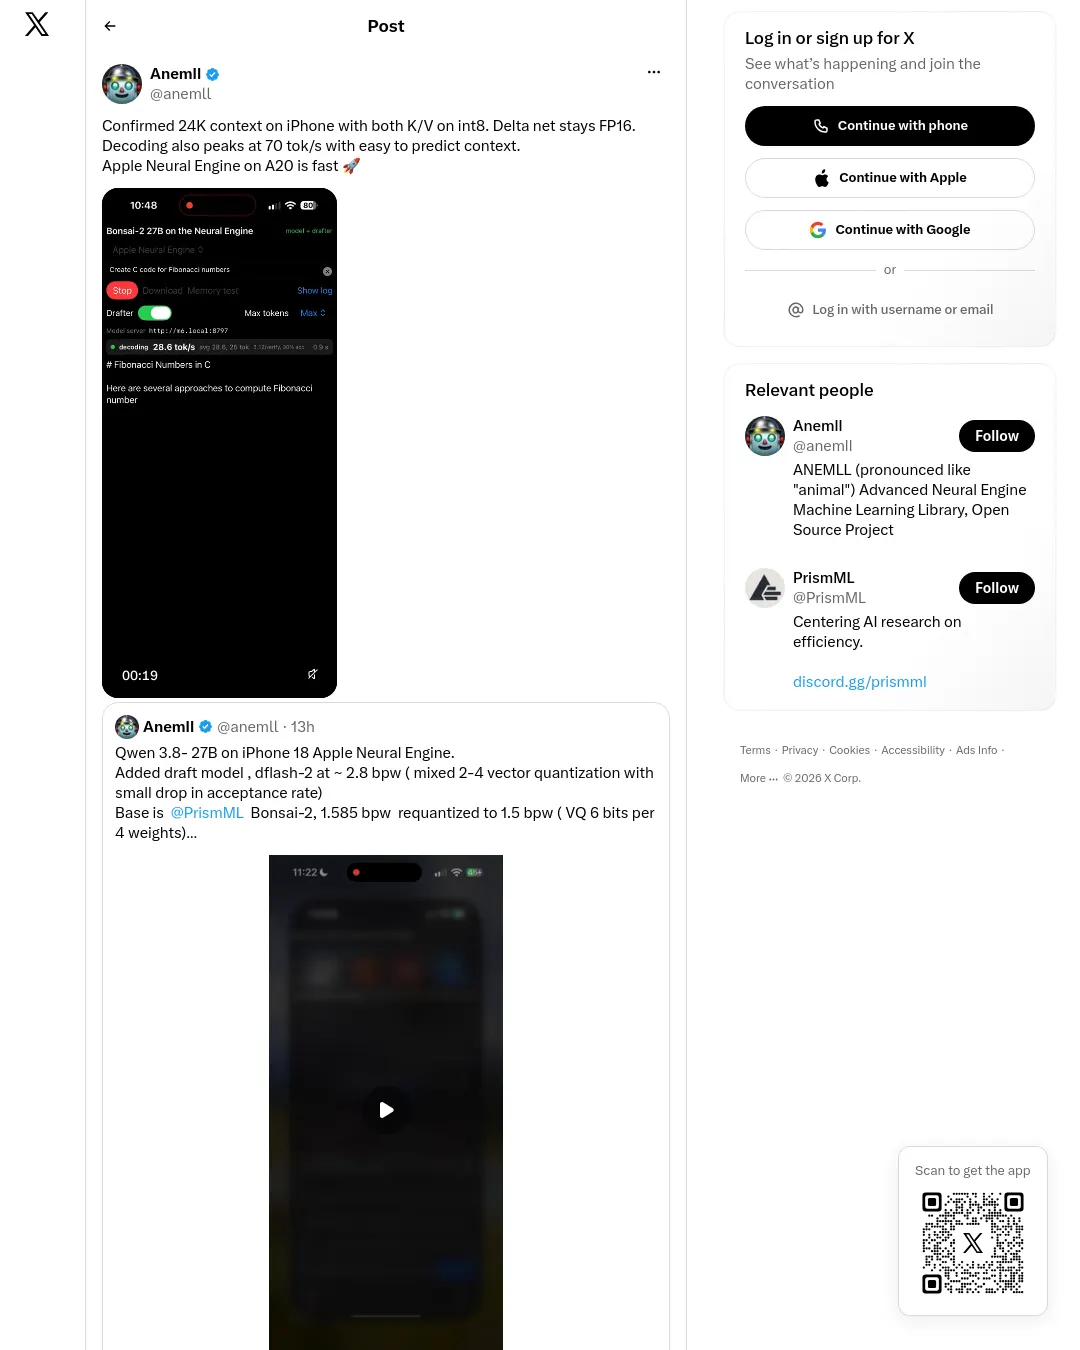
Anemll은 Apple A20 Neural Engine을 탑재한 iPhone 18에서 Qwen 3.8-27B를 실행해 초당 15~60토큰, 조건에 따라 최대 70토큰의 디코딩 속도를 냈다고 밝혔다. 게시물에는 24K 컨텍스트를 확인했으며 키·값 캐시를 모두 int8로 처리하고 델타 네트워크는 FP16으로 유지했다고 적었다.
기본 모델은 PrismML의 Bonsai-2를 1.585 bpw에서 1.5 bpw로 재양자화한 것으로, 가중치 4개당 6비트의 벡터 양자화를 사용했다. Anemll은 약 2.8 bpw의 초안 모델 dflash-2도 추가했으며, 2~4비트 혼합 벡터 양자화로 수용률이 소폭 낮아졌다고 설명했다. 게시물에는 컨텍스트 길이에 따라 디코딩 속도가 달라질 수 있다는 취지의 언급도 있다.
댓글 (0)
로그인하면 이 기사에 내 생각을 남길 수 있어요