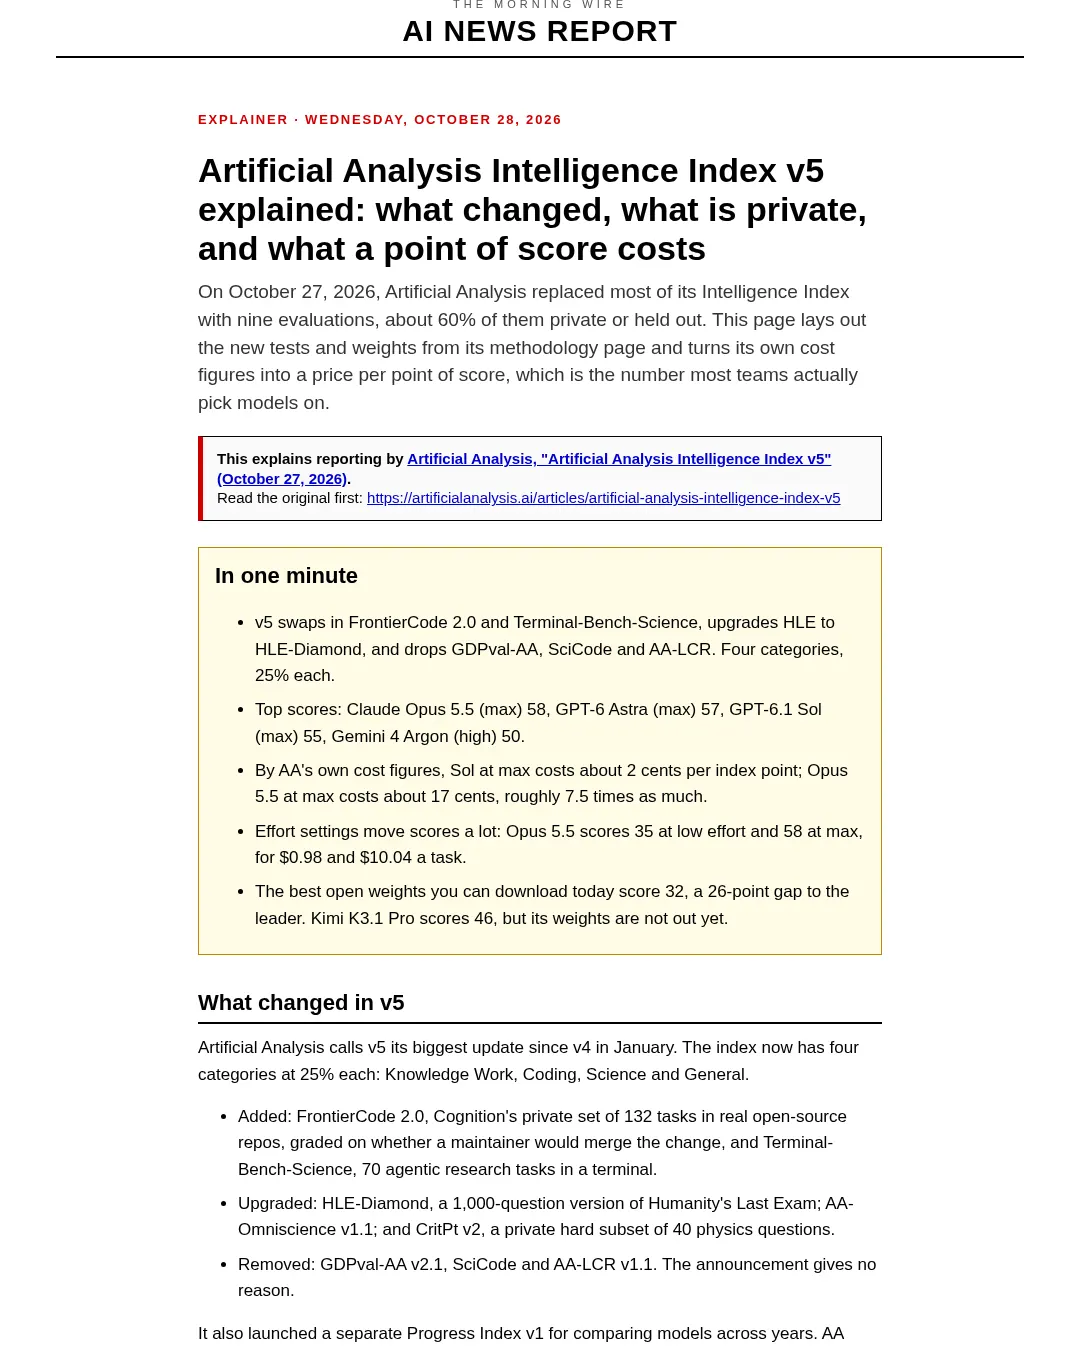
Artificial Analysis는 2026년 10월 27일 Intelligence Index v5를 발표하며 평가 항목 대부분을 바꾸고, 지수 점수와 실행 비용을 공개했다. 모델을 선택하는 팀은 점수만 비교하지 말고 실제로 사용할 추론 노력 설정에서 점수당 비용도 따져볼 필요가 있다.
- v5는 평가 항목 9개와 네 가지 범주를 각각 25% 비중으로 구성한다. 새 항목을 추가하고 일부 항목을 교체했으며, 약 60%는 비공개 시험 세트 또는 공개되지 않은 정답으로 평가한다고 밝혔다.
- 최고 점수는 Claude Opus 5.5(max)의 58점이고, GPT-6.1 Sol(max)은 55점이다. Artificial Analysis가 공개한 비용으로 계산하면 Sol(max)의 점수당 비용은 약 2센트, Opus 5.5(max)는 약 17센트다.
- 현재 다운로드할 수 있는 오픈 웨이트 모델의 최고 점수는 32점이다. Kimi K3.1 Pro는 46점이지만 아직 가중치가 공개되지 않았다.
Artificial Analysis의 Intelligence Index v5 보도 자료를 바탕으로 변경 사항과 비용을 정리했다.
v5에서 달라진 점
Artificial Analysis는 v5를 1월의 v4 이후 가장 큰 업데이트라고 설명한다. 지수는 Knowledge Work, Coding, Science, General 네 범주로 나뉘며 각 범주의 비중은 25%다.
- 추가 항목: Cognition의 비공개 벤치마크 FrontierCode 2.0과 터미널에서 수행하는 에이전트형 연구 과제 70개로 구성된 Terminal-Bench-Science다. FrontierCode 2.0은 실제 오픈소스 저장소의 과제 132개를 사용하며, 변경 사항을 관리자가 병합할지 평가한다.
- 개선 항목: Humanity's Last Exam의 1,000문항 버전인 HLE-Diamond, AA-Omniscience v1.1, 비공개 물리 문제 40개로 이루어진 어려운 하위 집합 CritPt v2다.
- 제외 항목: GDPval-AA v2.1, SciCode, AA-LCR v1.1이다. 발표문은 제외 이유를 밝히지 않았다.
Artificial Analysis는 연도별 모델 비교를 위한 별도 지수 Progress Index v1도 출시했다. 다만 현재 모델을 선택할 때는 Intelligence Index를 기준으로 삼으라고 안내한다.
평가 항목과 비공개 여부
다음 항목과 비중은 Artificial Analysis의 방법론 페이지에 따른다. 마지막 열에는 해당 페이지가 시험 세트에 관해 밝힌 내용을 옮겼다. 별도 설명이 없으면 그 사실을 그대로 표시했다.
| v5 평가 항목 | 비중 | 과제 수 | 반복 횟수 | 시험 세트 설명 |
|---|---|---|---|---|
| AA-Briefcase v1.1 | 15% | 91 | 1 | 명시되지 않음 |
| AutomationBench-AA | 5% | 657 | 1 | 비공개 홀드아웃 분할 |
| GDP.pdf | 5% | 100 | 5 | 명시되지 않음 |
| FrontierCode 2.0 | 15% | 132 | 3 | Cognition의 비공개 벤치마크 |
| Terminal-Bench 4.0 | 10% | 66 | 3 | 명시되지 않음 |
| Terminal-Bench-Science | 15% | 70 | 3 | 명시되지 않음 |
| CritPt v2 (hard subset) | 10% | 40 | 5 | 70개 중 40개로 된 비공개 목록 |
| AA-Omniscience v1.1 | 15% | 3,000 | 1 | Hugging Face에 공개 하위 집합이 있음 |
| HLE-Diamond | 10% | 1,000 | 1 | 명시되지 않음 |
발표문에 따르면 지수의 약 60%는 비공개 시험 세트나 공개되지 않은 정답을 사용한다. 방법론 페이지는 AutomationBench-AA와 CritPt v2를 비공개 세트로 표시하고, Cognition은 FrontierCode를 비공개라고 설명한다. AA-Omniscience에는 공개 하위 집합이 있다. 나머지 항목은 하나씩 공개 여부를 밝히지 않아, 두 페이지의 정보만으로는 60%를 재구성할 수 없다.
비공개 세트는 모델이 정답으로 학습했을 위험을 줄이지만, Artificial Analysis 외부에서는 점수를 다시 계산할 수 없다는 문제가 생긴다.
점수당 비용은 얼마인가
Artificial Analysis는 일부 상위 모델의 지수 과제 1회 실행 비용을 공개한다. 아래의 점수당 비용은 과제당 비용을 지수 점수로 나눈 값으로, Artificial Analysis가 발표한 지표는 아니다.
| 모델 및 설정 | 지수 점수 | 과제당 비용(달러) | 지수 1점당 비용(달러) |
|---|---|---|---|
| Claude Opus 5.5 (max) | 58 | 10.04 | 0.173 |
| GPT-6 Astra (max) | 57 | 6.24 | 0.109 |
| GPT-6.1 Sol (max) | 55 | 1.27 | 0.023 |
| Claude Opus 5.5 (low) | 35 | 0.98 | 0.028 |
GPT-6.1 Sol(max)은 Opus 5.5(max)보다 점수가 3점 낮지만, 과제당 비용은 약 8분의 1이다. Artificial Analysis도 이 차이를 언급했다. Opus 5.5(low)는 과제당 비용이 Sol(max)보다 조금 낮지만, 점수는 20점 낮아 점수당 비용은 더 높다.
모델뿐 아니라 추론 노력 설정도 결과에 큰 영향을 준다. Artificial Analysis에 따르면 v5에서 최저 노력과 최고 노력 간 점수 차이는 Claude Sonnet 5.5의 경우 20점에서 29점으로, GPT-6.1 Sol은 10점에서 20점으로 커졌다. Opus 5.5는 low 설정에서 35점과 과제당 0.98달러, max 설정에서 58점과 10.04달러를 기록했다.
점수 상위 10개 모델 가운데 과제당 비용이 가장 낮은 모델은 GPT-6.1 Terra(max)로 0.96달러, 가장 높은 모델은 Claude Fable 5.1(max)로 13.04달러다. 발표문에는 Terra의 지수 점수가 없어 점수당 비용은 계산하지 않았다.
토큰 사용과 오픈 웨이트 모델
모든 모델은 v4.3보다 과제당 출력 토큰을 더 많이 사용했다. Artificial Analysis가 제시한 중앙값은 약 59,000토큰으로, 이전의 35,000토큰에서 늘었다.
Terminal-Bench-Science, Terminal-Bench 4.0, AA-Briefcase, FrontierCode 2.0 등 에이전트형 평가 네 가지는 전체 가중치의 55%를 차지하지만, 출력 토큰 중앙값의 약 90%를 사용한다. 이 가운데 Terminal-Bench-Science 하나가 약 3분의 1을 차지한다. 따라서 짧은 답변을 주로 처리하는 작업에서는 위의 과제당 비용이 실제 지출보다 높게 나타날 수 있다.
Artificial Analysis는 최고 오픈 웨이트 모델과 선두 모델의 점수 차이가 v4.3의 3점에서 v5의 12점으로 벌어졌다고 밝혔다. 이 12점 차이는 아직 가중치가 공개되지 않은 Kimi K3.1 Pro의 46점을 기준으로 한다.
현재 다운로드할 수 있는 가중치 중에서는 DeepSeek V4.1 Flash 1017과 GLM-5.3이 32점으로 가장 높다. 이는 Claude Haiku 5.5의 36점보다 낮으며, 차이는 HLE-Diamond와 Terminal-Bench-Science에서 가장 크다.
모델을 고를 때 확인할 점
v4 점수에 따라 모델을 선택한 팀은 새 평가 항목으로 순위가 다시 계산됐으므로 다음 모델 결정 전에 결과를 재확인할 필요가 있다. 최고 노력 설정을 기준으로 예산을 세우는 팀은 상위 10개 모델의 과제당 비용이 13배 넘게 차이 나고, 노력 설정에 따라서도 점수와 비용이 달라진다는 점을 고려해야 한다. 오픈 웨이트 사용자는 현재 공개된 최고 점수 32점과 선두 점수 58점을 비교할 수 있다.
모델을 바꾸기 전에는 최고 점수보다 실제로 사용할 노력 설정에서의 점수당 비용을 비교하는 편이 낫다. 또한 지수 과제가 긴 에이전트 실행 중심이므로, 실제 업무와 비슷한 짧은 평가도 별도로 수행해야 한다. 점수를 독립적으로 확인할 수 있다고 간주하기 전에 방법론 페이지에서 어떤 평가가 비공개인지 확인해야 한다.
아직 공개되지 않은 정보도 있다. 아홉 개 평가 중 어떤 항목들이 Artificial Analysis가 말한 비공개 또는 홀드아웃 60%를 구성하는지, 세 가지 평가를 제외한 이유, GPT-6.1 Terra처럼 비용 목록에 있지만 점수가 없는 모델의 점수는 해당 페이지들에서 확인할 수 없다. 점수당 비용은 Artificial Analysis의 공개 수치를 나눈 값이며, 회사가 발표한 지표는 아니다.
참고 자료: Artificial Analysis의 Intelligence Index v5 보도 자료, Artificial Analysis의 Intelligence Index 방법론(v5.0)
부록: 원문 예시
v5 evaluation weight tasks repeats test set (per AA's pages)
AA-Briefcase v1.1 15% 91 1 not stated
AutomationBench-AA 5% 657 1 private held-out split
GDP.pdf 5% 100 5 not stated
FrontierCode 2.0 15% 132 3 Cognition's private benchmark
Terminal-Bench 4.0 10% 66 3 not stated
Terminal-Bench-Science 15% 70 3 not stated
CritPt v2 (hard subset) 10% 40 5 private list of 40 of 70
AA-Omniscience v1.1 15% 3,000 1 public subset on Hugging Face
HLE-Diamond 10% 1,000 1 not stated
Cost per Intelligence Index task, from Artificial Analysis (October 27, 2026)
Model and setting Index $ per task $ per index point
Claude Opus 5.5 (max) 58 10.04 0.173
GPT-6 Astra (max) 57 6.24 0.109
GPT-6.1 Sol (max) 55 1.27 0.023
Claude Opus 5.5 (low) 35 0.98 0.028

$ per index point = $ per task / index score (our division, not an AA metric)
댓글 (0)
로그인하면 이 기사에 내 생각을 남길 수 있어요