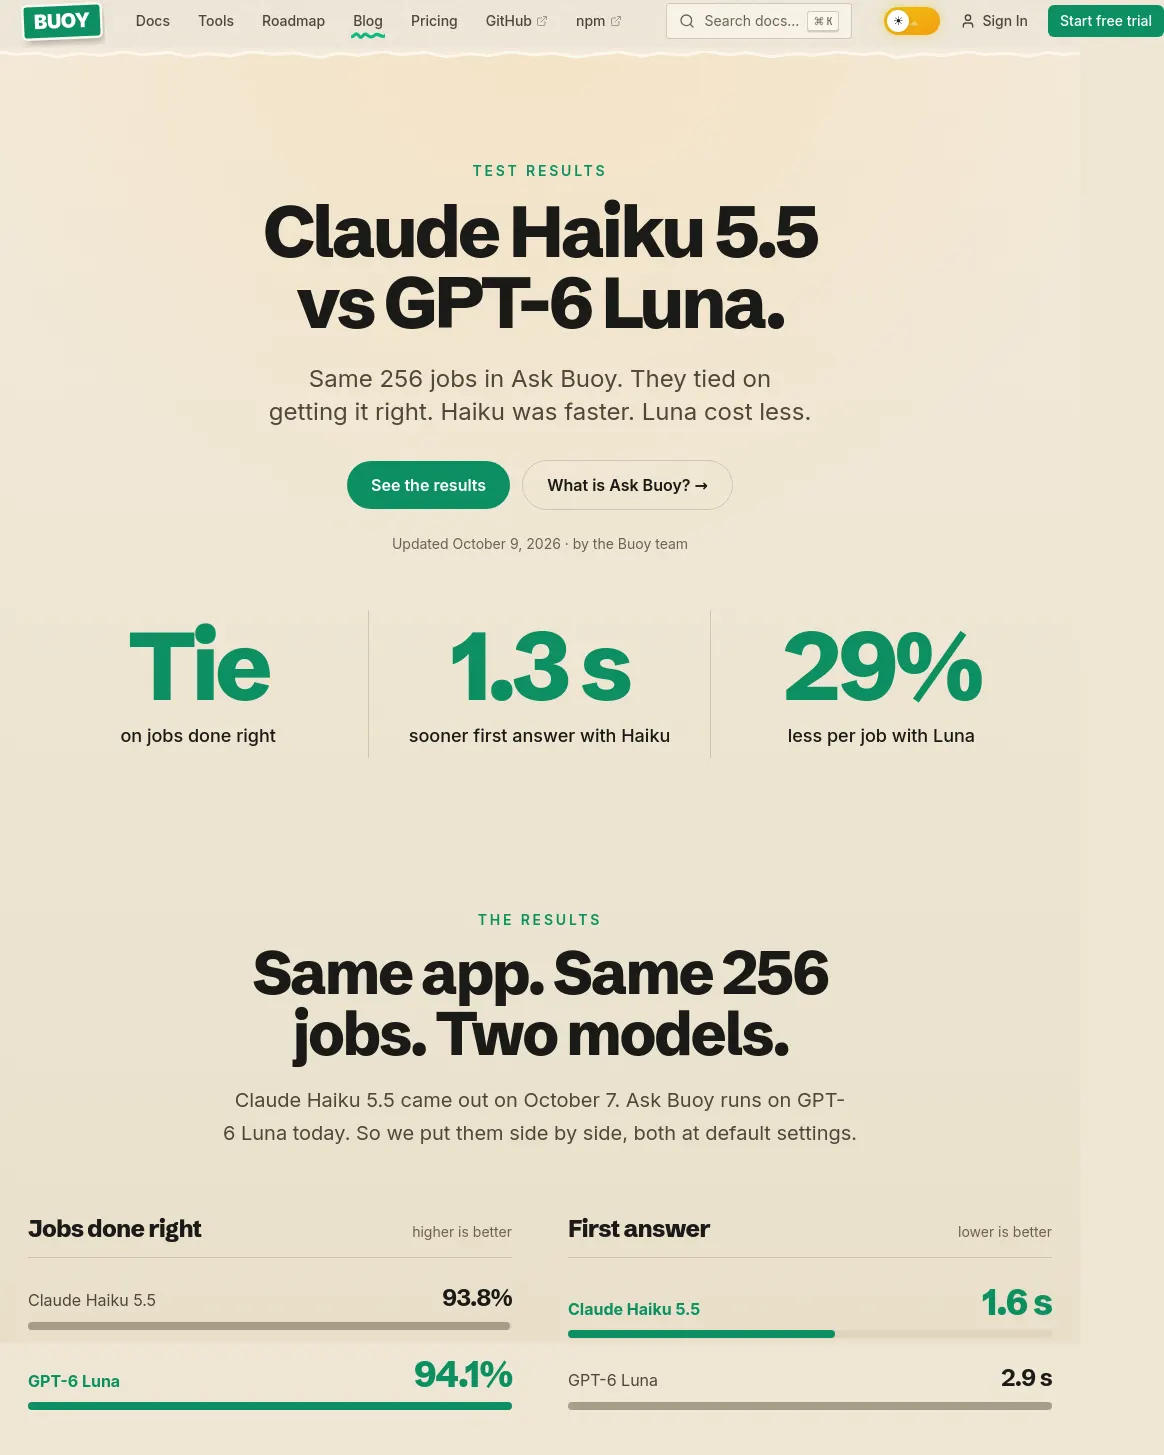
Buoy가 iOS 시뮬레이터에서 256개 작업을 시험한 결과 Claude Haiku 5.5와 GPT-6 Luna는 기본 설정에서 비슷한 성공률을 보였다. Haiku는 첫 응답과 전체 작업이 더 빨랐고, Luna는 작업당 비용이 약 29% 낮았다.
각 모델은 작업을 한 번씩 수행했다. 성공률은 Haiku가 93.8%, Luna가 94.1%였다. 첫 응답까지는 각각 1.6초와 2.9초, 전체 작업 시간은 중앙값 기준 20.9초와 27.9초였다. 작업당 비용은 Haiku가 0.62센트, Luna가 0.44센트였다. Buoy는 성공률 차이가 1~2%포인트인 경우 우연일 수 있다고 밝혔다.
분야별로는 Haiku가 버그 설명과 긴 대화(56개 작업), 사용자와 시간(16개), 오류와 로그(8개) 등 3개 분야에서 앞섰다. Luna는 웹 호출, 화면과 링크, 앱 데이터 저장소, 저장된 데이터, 설정과 콘텐츠, 위치와 권한, 실행 취소와 속도 등 7개 분야에서 더 높은 점수를 얻었다. 서버 데이터, 복원 지점과 앱 수명, 탭과 입력, 기본 작업 등 4개 분야는 동률이었다.
| 분야 | 작업 수 | Claude Haiku 5.5 | GPT-6 Luna |
|---|---|---|---|
| 버그 설명과 긴 대화 | 56 | 94% | 88% |
| 웹 호출 | 28 | 96% | 100% |
| 화면과 링크 | 22 | 93% | 95% |
| 앱 데이터 저장소 | 21 | 90% | 95% |
| 서버 데이터 | 19 | 100% | 100% |
| 저장된 데이터 | 18 | 94% | 100% |
| 복원 지점과 앱 수명 | 16 | 94% | 94% |
| 사용자와 시간 | 16 | 100% | 94% |
| 설정과 콘텐츠 | 14 | 79% | 82% |
| 위치와 권한 | 13 | 85% | 96% |
| 실행 취소와 속도 | 9 | 89% | 100% |
| 오류와 로그 | 8 | 100% | 88% |
| 탭과 입력 | 8 | 100% | 100% |
| 기본 작업 | 8 | 100% | 100% |
최종 확인을 위해 따로 둔 140개 작업에서는 Haiku가 95.0%, Luna가 94.7%를 기록했다. Haiku의 추론 강도를 높인 시험에서는 성공률이 93.8%에서 95.1%로 올랐지만, 전체 작업 시간은 20.9초에서 24.8초로 늘었고 작업당 비용도 0.62센트에서 0.73센트로 증가했다. 기본 설정 시험에는 두 모델 모두 추가 추론 시간을 주지 않았다.
시험은 Buoy가 만든 음식 주문 앱에서 진행했다. 각 작업은 사람이 입력할 법한 내용을 타이핑하고, 스크립트가 앱 자체를 확인하는 방식이다. 앱 화면에 결과가 나타나야 작업을 성공으로 판정했다. 두 모델은 같은 시험 코드와 작업, 판정 기준을 사용했다. 이틀 동안 2,500회가 넘는 시험을 실행했고, 최종 비교는 모델별 256회씩 총 512회였다.
Buoy는 자체 앱과 작업을 사용해 시험했으며, 독자의 앱에서는 결과가 다를 수 있다고 밝혔다. 두 모델은 같은 코드와 앱으로 시험했지만 서로 다른 시간에 실행했다. 비용은 각 실행에서 사용한 토큰 수와 정가를 기준으로 계산했다. 전체 실행 비용은 2.72달러였고, Haiku는 256개 작업에 1.59달러, Luna는 1.13달러가 들었다.
호스팅형 Ask Buoy 베타는 현재 GPT-6 Luna를 사용하지만, Buoy는 Ask Buoy가 두 모델 모두에서 실행될 수 있다고 설명한다. Ask Buoy는 실행 중인 앱에서 화면을 읽고 웹 호출을 확인하며 앱 데이터를 바꾸고 버튼을 누르는 AI 채팅 기능이다. Ask Buoy 안내
Buoy는 시험 작업을 직접 작성한 주체라는 점을 공개했다. 실행 기록은 보관하고 있으며, 수치를 확인하려면 Buoy에 문의할 수 있다고 밝혔다. 기능 설명의 근거는 각 업체의 문서이며, 해당 페이지에 따르면 2026년 10월 9일에 확인했다.
댓글 (0)
로그인하면 이 기사에 내 생각을 남길 수 있어요