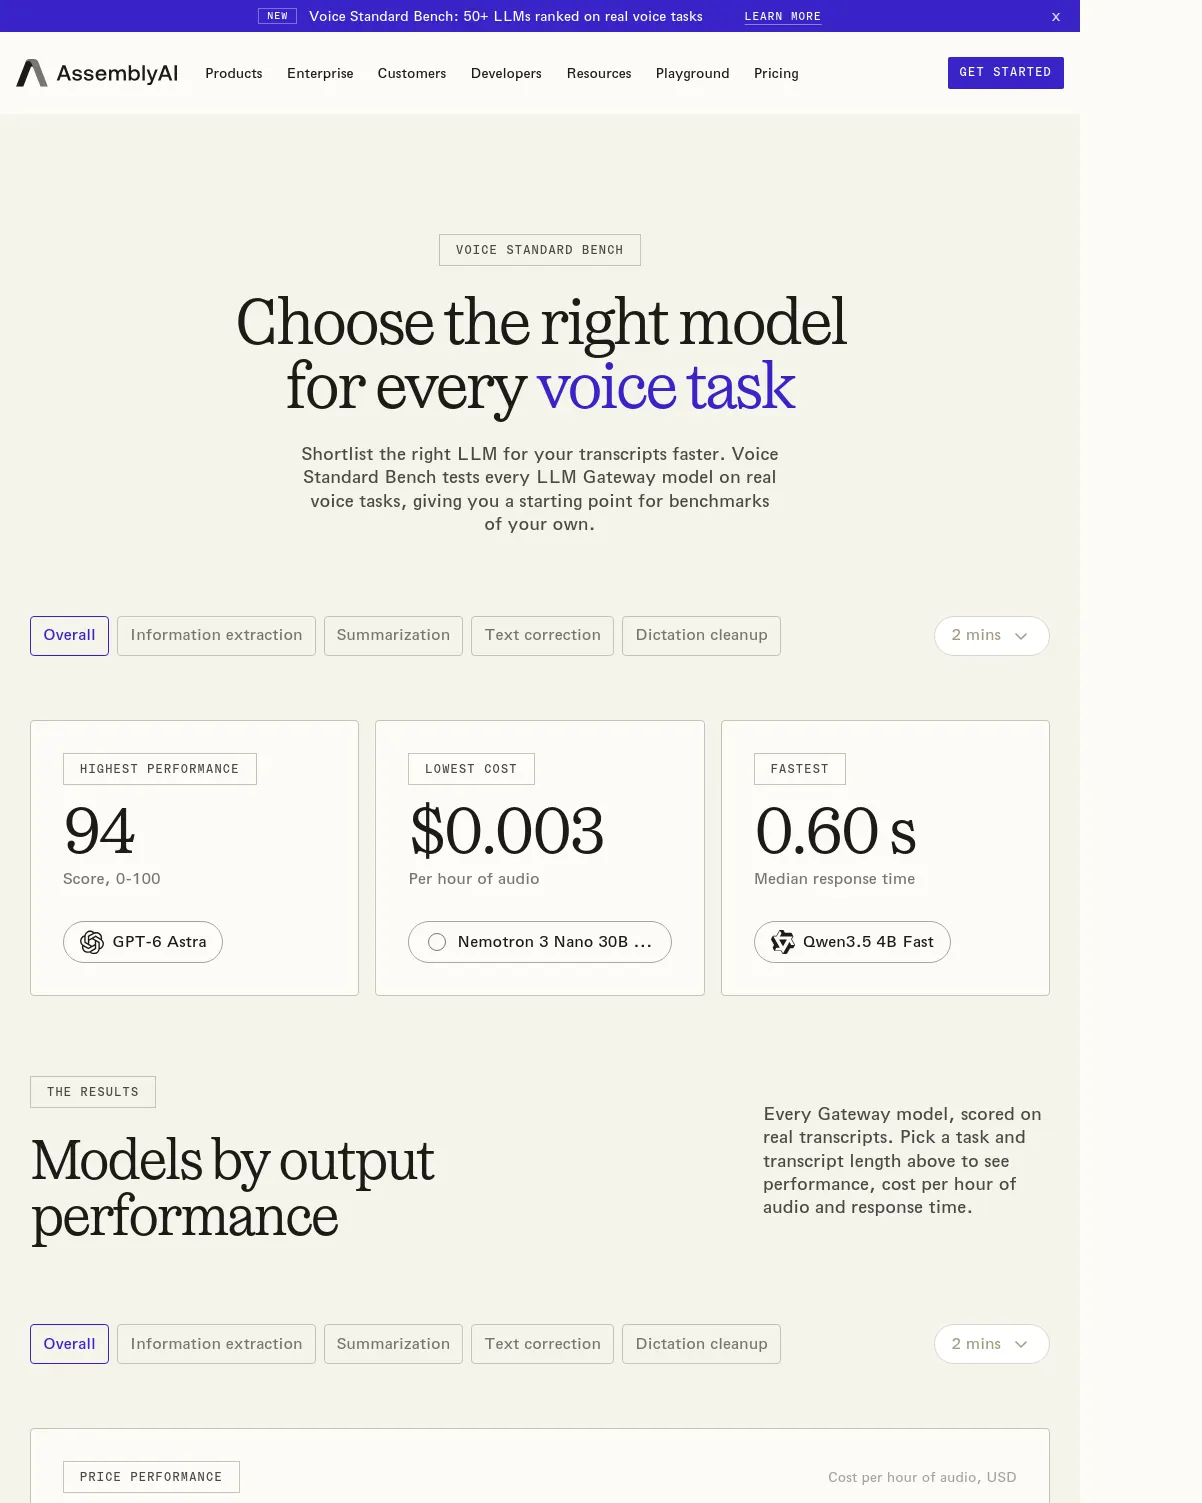
AssemblyAI의 Voice Standard Bench는 LLM Gateway에서 제공하는 50개 이상의 모델을 실제 음성 전사본에 적용해 성능, 오디오 1시간당 비용, 응답 시간을 비교하는 체험 사이트다. 정보 추출·요약·문장 교정·받아쓰기 정리 작업과 전사본 길이를 선택해 모델을 살펴보고, 자신의 오디오로 결과를 비교할 수 있다.
2분 전사본의 전체 작업 기준으로 사이트는 GPT-6 Astra를 최고 성능 모델(94점), Nemotron 3 Nano 30B A3B를 최저 비용 모델(시간당 0.003달러), Qwen3.5 4B Fast를 가장 빠른 모델(중앙 응답 시간 0.60초)로 제시한다. 이는 특정 작업과 길이에 대한 결과가 아니라 전체 보기의 예시이므로, 사이트에서 작업과 전사본 길이를 바꿔 확인해야 한다. 짧은 전사본과 긴 전사본에서 유리한 모델이 달라질 수 있다고 안내한다.
성능 점수는 작업별 기준에 따라 0~100점으로 평가하며, 전체 점수는 각 작업을 같은 비중으로 합산한다. 오디오 1시간당 비용은 작업별 벤치마크 호출의 평균 비용을 전사본 1시간 기준으로 환산한 값이다. AssemblyAI LLM Gateway의 글로벌 라우팅과 공급자 요금을 기준으로 하며, 미국 또는 EU 리전 라우팅은 10% 더 비싸다. 응답 시간은 해당 길이에서 모든 호출의 중앙값이다. 결과는 실제 전사본으로 측정하고, 모델은 30초부터 1시간까지 네 가지 길이로 평가한다. 벤치마크 측정 방법
사용자는 LLM Gateway 플레이그라운드에 파일을 올리고 전사본에 프롬프트를 적용한 뒤 모델을 바꿔 응답을 비교할 수 있다. 사이트는 코드를 작성하기 전 자신의 오디오로 모델을 시험해 보도록 안내한다. 전체 측정값은 GitHub 저장소에서 JSON으로 확인할 수 있으며, LLM Gateway는 Speech-to-Text와 같은 API 키로 이용하고 공급자 요금에 0% 수수료를 더한다고 AssemblyAI는 설명한다.
댓글 (0)
로그인하면 이 기사에 내 생각을 남길 수 있어요