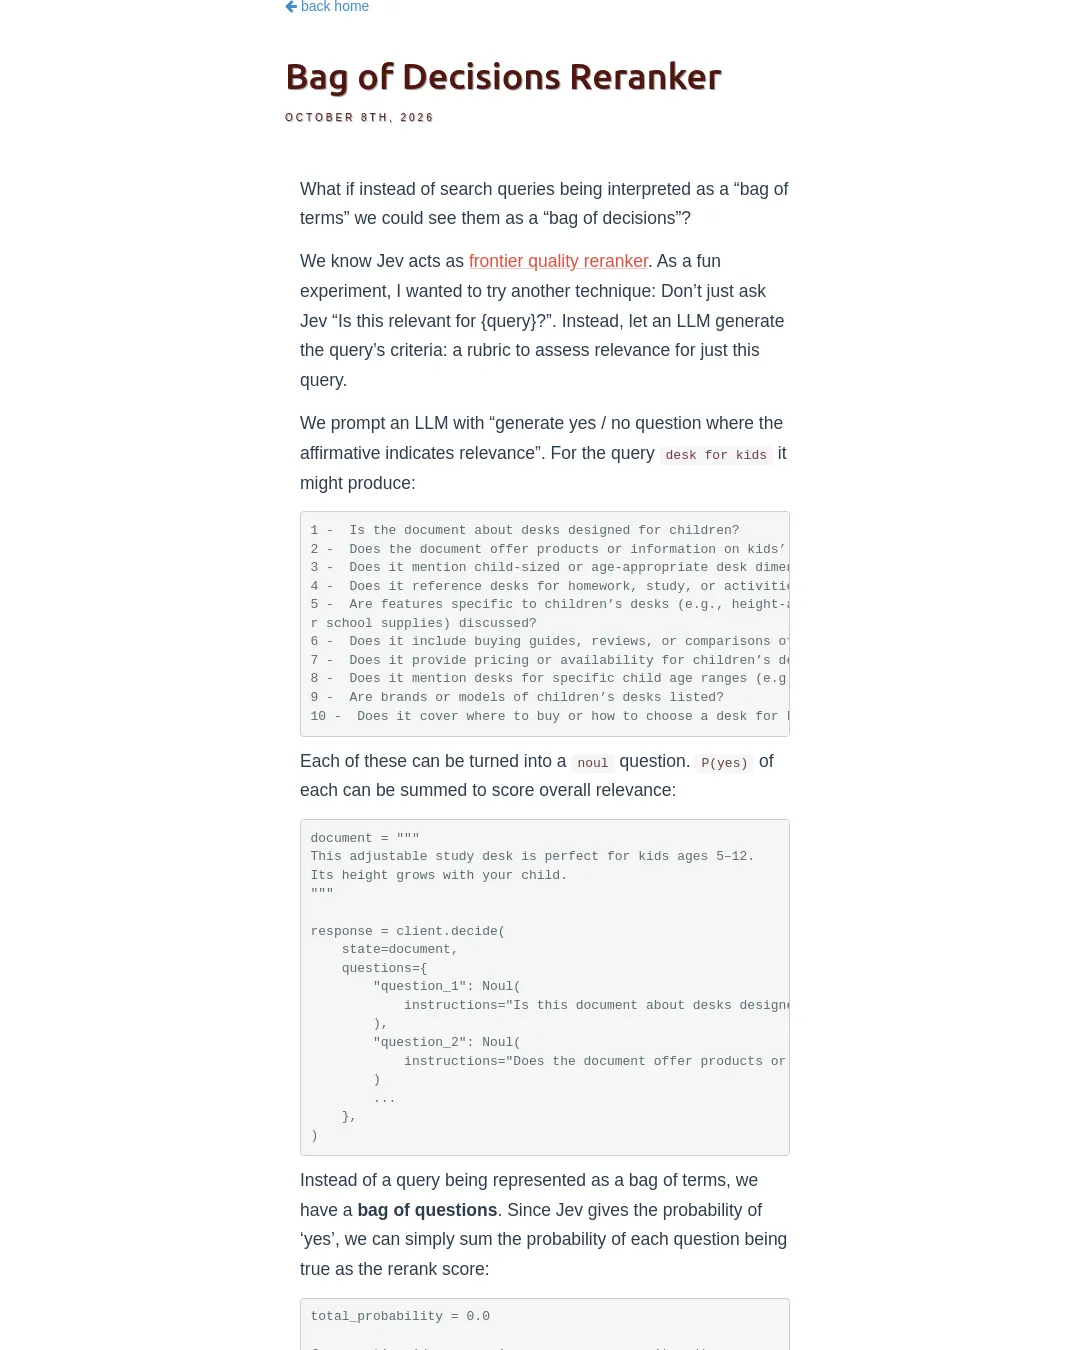
검색 질의를 단어의 묶음이 아니라 판단 기준의 묶음으로 다루는 재순위화(reranking) 방식이 제안됐다. Doug Turnbull은 대규모 언어 모델(LLM)이 질의별 관련성 질문을 만들고 Jev가 각 질문에 ‘예’라고 답할 확률을 합산해 점수를 매기는 실험을 진행했다. 두 전자상거래 데이터셋에서 이 방식은 BM25와 단일 질문을 사용하는 Jev 재순위화보다 높은 평균 정규화 할인 누적 이득(NDCG)을 기록했다.
예를 들어 desk for kids라는 질의에 대해 LLM은 어린이용 책상인지, 어린이에게 적합한 크기나 인체공학적 설계를 다루는지, 가격이나 구매처를 제공하는지 등을 묻는 질문을 만든다. 질문은 다음과 같다.
1 - Is the document about desks designed for children? 2 - Does the document offer products or information on kids’ desks? 3 - Does it mention child-sized or age-appropriate desk dimensions or ergonomics? 4 - Does it reference desks for homework, study, or activities for kids? 5 - Are features specific to children’s desks (e.g., height-adjustable for kids, safety/rounded edges, storage fo r school supplies) discussed? 6 - Does it include buying guides, reviews, or comparisons of kids’ desks? 7 - Does it provide pricing or availability for children’s desks? 8 - Does it mention desks for specific child age ranges (e.g., toddlers, elementary, teens) as kids’ desks? 9 - Are brands or models of children’s desks listed? 10 - Does it cover where to buy or how to choose a desk for kids?
각 질문을 noul 질문으로 만들고, 문서에 대한 답변에서 ‘예’일 확률을 합산한다. 예시 문서와 질문 설정은 다음과 같다.
document = """ This adjustable study desk is perfect for kids ages 5–12. Its height grows with your child. """ response = client.decide( state=document, questions={ "question_1": Noul( instructions="Is this document about desks designed for children?" ), "question_2": Noul( instructions="Does the document offer products or information on kids’ desks?" ) ... }, )
확률을 합산하는 코드는 다음과 같다.
total_probability = 0.0 for question_id, answer in response.answers.items(): probability = answer.noul print(f"{question_id}: {probability:.2f}") total_probability += probability
이 합계를 최종 재순위화 점수로 사용하거나 BM25 점수와 결합할 수 있다. 비교 대상은 BM25, 질의와 문서의 관련성을 한 번 묻는 Jev 재순위화, 여러 질문을 사용하는 ‘bag of decisions’ 방식이다. 실험의 자세한 내용은 GitHub 문서에 공개했다.
| 데이터셋 | 전략 | 평균 NDCG | 중앙값 NDCG |
|---|---|---|---|
| WANDS | bm25 | 0.5407 | 0.475 |
| WANDS | jev_reranker | 0.574 | 0.561 |
| WANDS | bag_of_decisions | 0.610 | 0.561 |
| ESCI | bm25 | 0.289 | 0.171 |
| ESCI | jev_reranker | 0.314 | 0.205 |
| ESCI | bag_of_decisions | 0.360 | 0.341 |
Turnbull은 이를 질의마다 특징을 만들고, LLM이 해당 질의에서 중요할 요소를 제안하면 Jev가 문서가 그 기준을 충족하는지 측정하는 방식으로 설명했다. 다만 생성된 질문 가운데 반복되는 내용이 있어 더 정확하고 다양한 질문을 만들도록 LLM 호출 방식을 개선할 여지가 있다고 봤다.
이번 결과는 WANDS와 Amazon ESCI라는 두 전자상거래 데이터셋을 사용한 초기 실험에 한정된다. Turnbull은 이 장난감 실험에서 가능성을 확인했으며 추가 연구가 필요하다고 밝혔다. 특정 분야에 맞춘 의사결정 모델을 만들 수 있다는 가능성도 언급하며 관련 게시물을 연결했다.
댓글 (0)
로그인하면 이 기사에 내 생각을 남길 수 있어요