TL;DR
Lava에서 버터플라이 네트워크를 사용해 임의 크기의 정렬기를 재귀적으로 구성하고, 두 개의 수를 정렬하는 회로를 기본 단위로 삼는 설계임.- Batcher 비토닉 병합기는 두 정렬기 회로를 버터플라이 형태로 연결하며, 입력의 앞 절반과 뒤 절반이 각각 오름차순과 내림차순(또는 그 반대)이어야 하므로 상위 정렬 결과를 뒤집는 구조임.
riffle,unriffle,two,ilv,evens조합자로 배선 패턴을 표현하고, 이를 재귀적으로 결합해 임의 차수의 버터플라이 네트워크와 정렬기를 만드는 방식임.- 차수 3 정렬기는 8개 입력, 차수 4는 16개 입력, 차수 5는 32개 입력을 처리하며, 32개의 16비트 수를 매 클록 정렬하는 구현은 XC2V3000에서 165MHz, 14클록 지연을 기록함.
- 더 큰 데이터 집합은 수를
BlockRAM에 저장한 뒤 반복적으로 정렬하고 병합할 수 있으며, 일부 네트워크는 XCV300 FPGA에서 구현되고ChipScope로 실제 정렬 동작을 검증함.
Lava의 정렬기 예제
버터플라이 네트워크로 정렬하기
- 높은 성능을 내도록 배치한 버터플라이 네트워크를 사용해 정렬기 회로를 구성하는 방법임.
- 회로는 하위 정렬 결과를 재귀적으로 병합하는 구조임.
- 병합기는 비토닉 형식으로, 입력 목록의 앞 절반이 오름차순이고 뒤 절반이 내림차순이거나 그 반대인 입력을 요구함. 최상위 정렬기의 결과를 뒤집어 이 조건을 맞춤.
Batcher 비토닉 병합기
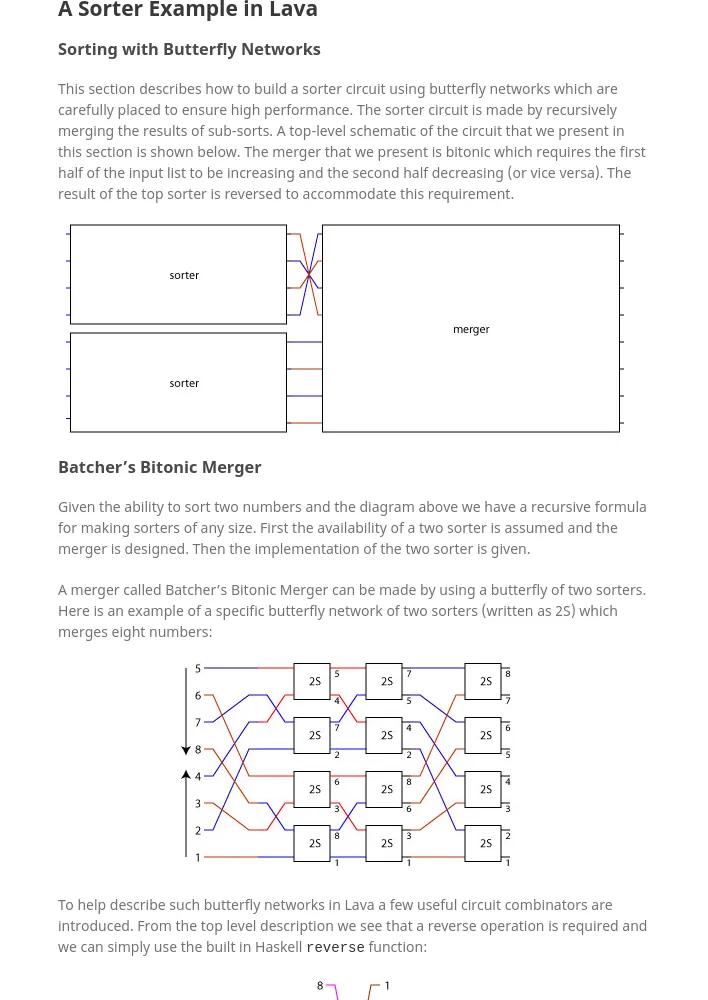
- 두 수를 정렬하는 기능을 전제로 하면, 두 정렬기 회로를 버터플라이로 구성해 병합기를 만들 수 있음. 이 병합기를 Batcher 비토닉 병합기라고 부름.
- 두 정렬기를
2S로 나타내는 버터플라이 네트워크는 8개 수를 병합하는 사례를 제공함. Lava에서 이러한 네트워크를 기술하기 위한 배선 조합자는 다음과 같음.reverse: 내장 Haskell 함수로 목록을 뒤집음.riffle: 입력 목록의 홀수 위치와 짝수 위치 원소를 서로 끼워 넣음.halve가 목록을 두 부분으로 나누고,ziP가 두 목록의 대응 원소를 쌍으로 묶으며,unpair가 쌍 목록을 평탄화함.unriffle:riffle의 역연산으로,riffle회로를 수직축 기준으로 반사한 형태임.pair로 묶고unzip으로 분리한 뒤unhalve로 목록을 합침.two r: 입력 버스를 절반으로 나눠 아래쪽 절반에는r의 첫 복사본을, 위쪽 절반에는 두 번째 복사본을 적용한 뒤 다시 합침.ilv r(인터리브): 아래쪽 회로가 짝수 위치 입력을, 위쪽 회로가 홀수 위치 입력을 처리함.unriffle,two r,riffle의 연결로 정의됨.evens f: 입력 목록을 두 원소씩 나눈 뒤 각 쌍에 쌍 입력·쌍 출력 회로f의 복사본을 적용하고 결과를 이어 붙임.
버터플라이 네트워크의 재귀 구성
r이 쌍 입력·쌍 출력 회로일 때, 크기 1의bfly는r자체임. 크기n의bfly는 크기n-1버터플라이를ilv에 넣고 그 결과에evens r를 연결함.- 두 입력을 정렬하는 회로에서는 크기 1 버터플라이가 단일 두 수 정렬기 하나로 구현됨.
- 크기 3 버터플라이는 크기 2 버터플라이를
ilv로 구성한 뒤evens r를 연결하는 형태이며, 전개하면ilv와evens조합자의 배치를 확인할 수 있음. - 이 버터플라이에 두 수 정렬기를 적용하면 비토닉 병합기가 됨. 이를 정렬기 아키텍처의 병합 단계에 사용함.
정렬기의 재귀 아키텍처
- 상위 정렬기의 두 하위 정렬기는 같은 방법으로 재귀 분해함. 예를 들어 상위 절반 정렬기는 병합기를 적용한 뒤 두 하위 목록을 정렬하며, 각 하위 목록에 원소가 두 개만 남으면 재귀의 기본 사례인 두 수 정렬기를 적용함.
- 병합기는 다시 두 수 정렬기의 버터플라이로 구성됨. 하위 정렬기에도 같은 분해 방법을 적용하면 차수 3, 즉 2³=8개 입력 정렬기의 전체 아키텍처가 완성됨.
- 정렬기 정의는 차수 1에서 비교기
cmp를 사용하고, 더 큰 차수에서는 두 개의 작은 정렬기를 병렬 적용한 뒤 상위 정렬 결과를 뒤집고bfly cmp로 병합하는 구조임. 따라서 사용할 두 수 정렬기를 매개변수로 지정할 수 있음. sorter two_sorter의 사례는 Virtex-II 장치에서 동작하는 파이프라인 8입력 정렬기를 생성함.Lava조합자는 연결 정보뿐 아니라 배치 정보도 포함하므로 결과 회로는 도식과 대응하는 직사각형 영역을 차지함.- 차수 4 정렬기는 16개 입력, 차수 5 정렬기는 32개 입력을 처리함.
성능과 하드웨어 검증
- 위 네트워크를 조금 확장한 구현은 16비트 수 32개를 매 클록마다 정렬하며, XC2V3000에서 165MHz로 동작하고 지연 시간은 14클록임. 측정에는 Xilinx 설계 도구 4.1i 버전이 사용됨.
- 더 큰 데이터 집합은 수를
BlockRAM에 저장하고 반복적으로 정렬 및 병합하는 방식으로 처리할 수 있음. - 일부 버터플라이 네트워크는 XCV300 FPGA에 구현됐으며,
ChipScope를 사용해 실제 하드웨어가 수를 정렬하는지 검증함. - 관련 내용은 논문 *Design and Verification of a Sorter Core*에서 확인할 수 있음.
다음 절
- 1차원 시스토릭 유한 임펄스 응답 필터
댓글 (0)
로그인하면 이 기사에 내 생각을 남길 수 있어요