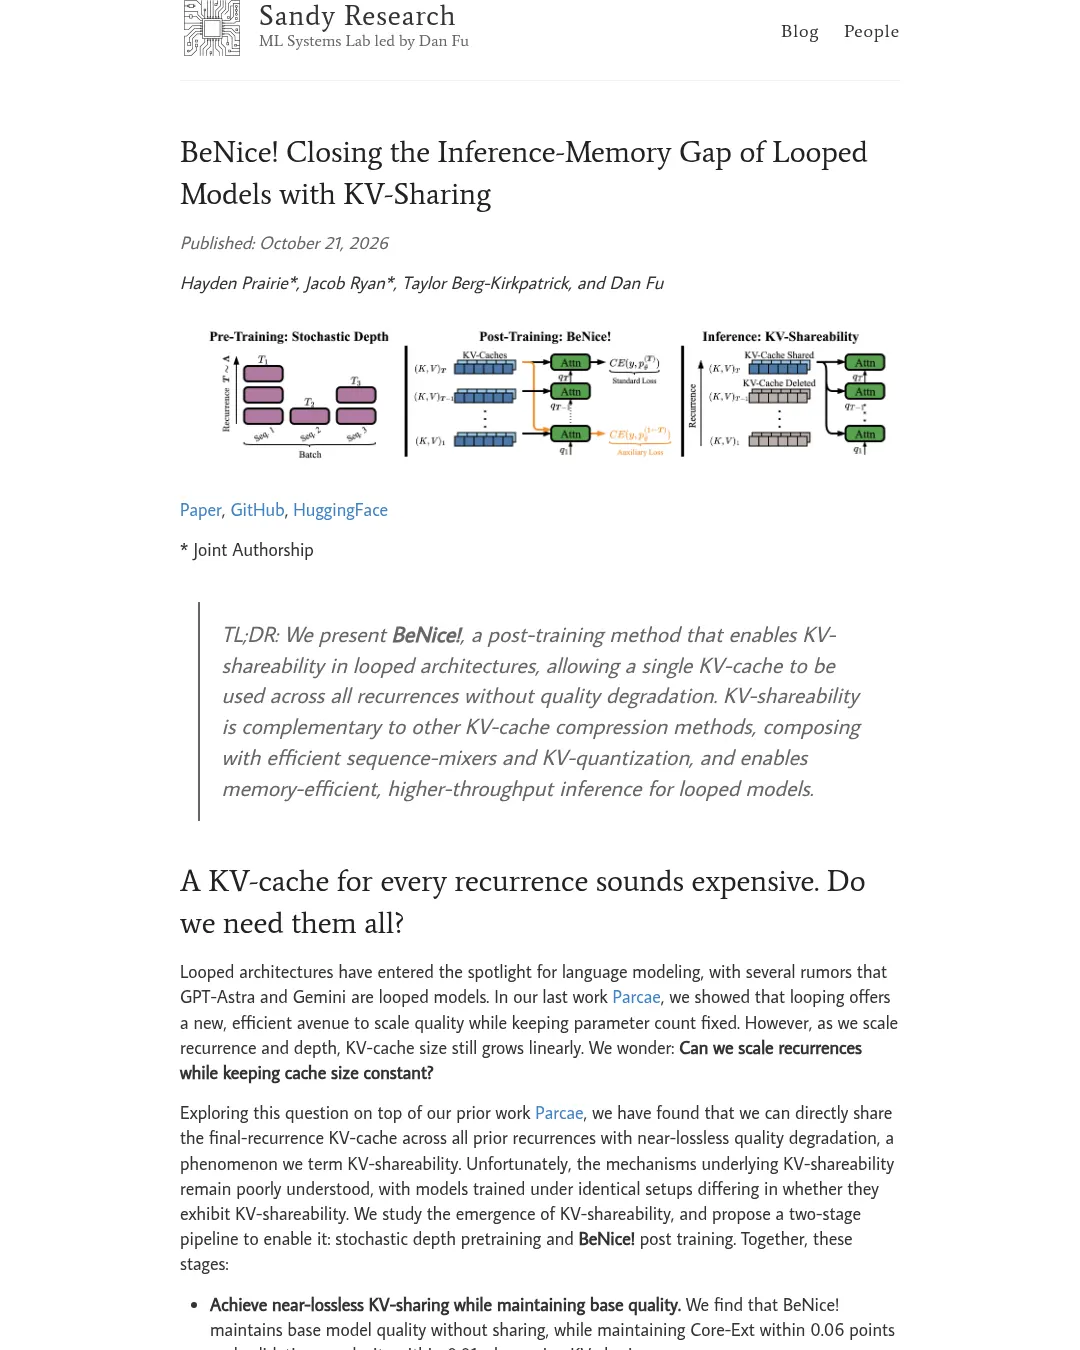
SandyResearch 연구팀은 반복형 모델의 여러 반복 단계에서 KV 캐시를 공유하도록 학습하는 후처리 방법 BeNice!를 제안했다. 연구팀은 합성 추론 환경에서 메모리 제약이 큰 고부하 상황의 처리량이 최대 23.6% 늘고 p90 첫 토큰 지연 시간이 139.2초에서 23.2초로 줄었다고 보고했다.
반복형 모델은 같은 가중치 블록에 활성값을 반복해서 통과시켜 파라미터 수를 늘리지 않고 품질을 높일 수 있지만, 반복 횟수가 늘면 KV 캐시 크기도 선형으로 증가한다. 일부 모델은 마지막 반복 단계의 키·값을 앞선 단계에서도 재사용해도 품질이 거의 떨어지지 않는 특성을 보인다. 연구팀은 이를 KV 공유 가능성(KV-shareability)이라고 부른다.
연구팀의 2단계 방법은 사전학습에서 확률적 깊이(stochastic depth)를 적용해 반복 단계마다 예측하도록 학습한 뒤, BeNice!로 첫 반복 단계가 이후 단계의 KV 캐시와 호환되도록 미세 조정하는 방식이다. 확률적 깊이는 반복 잔차가 수렴하도록 유도하지만, 이것만으로 모든 모델에서 KV 공유 가능성이 나타나지는 않았다. 연구팀은 첫 반복의 첫 번째 층에서 발생하는 토큰 독립적 기저 이동이 수렴 표현을 바꿔 공유에 따른 품질 저하를 일으킬 수 있다고 설명했다.
연구팀은 BeNice!가 KV 캐시를 공유하지 않을 때 기본 모델의 품질을 유지하고, 공유할 때는 Core-Ext 점수 차이를 0.06점 이내, 검증 퍼플렉서티 차이를 0.01 이내로 유지했다고 밝혔다. 또한 이 방법은 MLA·KDA 시퀀스 믹서와 최대 4비트 KV 양자화와 함께 사용할 수 있었다.
추론 효과는 실제 요청 기록, 합성 모델 규모, 최적화된 서빙 플랫폼을 반영한 합성 환경에서 평가했다. 낮은 부하인 초당 0.5건에서는 공유하지 않는 기준선과 지연 시간 및 처리량이 비슷했으며, 높은 부하인 초당 2건에서는 처리량이 23.6% 증가했다. 동시 사용자 수를 늘리는 실험에서는 고정된 중앙값 디코딩 속도에서 처리량이 최대 6.7% 높았고, 고정 처리량에서는 중앙값 디코딩 속도가 34.8% 높았다. 이는 합성 환경의 결과이며, 글은 실제 배포 환경에서의 성능을 검증했다고 밝히지는 않는다.
댓글 (0)
로그인하면 이 기사에 내 생각을 남길 수 있어요