BrokenML은 에이전트가 깨진 머신러닝(ML) 작업을 고칠 때 접근 권한이 성능과 비용에 미치는 영향을 비교한 벤치마크다. 9개 모델이 고장 난 작업 46개를 세 가지 접근 수준에서 수행한 결과, 접근 권한이 높아질수록 성능이 좋아지고 비용은 최대 8배 낮아졌다.
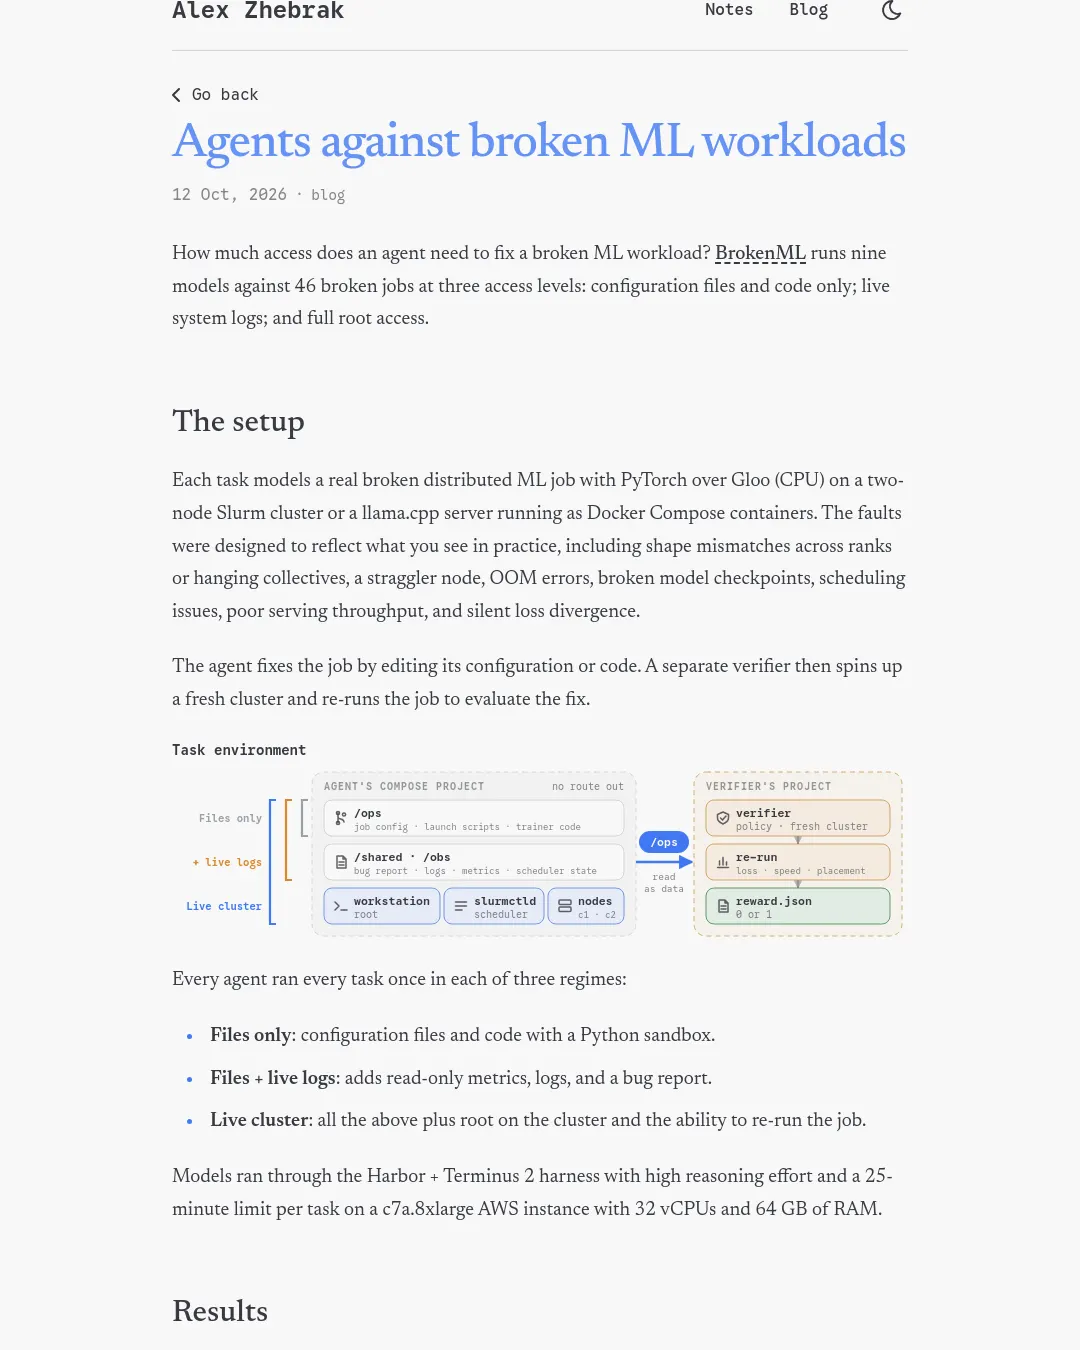
작업은 Gloo를 사용하는 PyTorch 분산 작업을 두 노드 Slurm 클러스터에서 실행하거나, Docker Compose 컨테이너로 llama.cpp 서버를 구동하는 환경을 본떴다. 오류 유형에는 노드 간 텐서 형태 불일치, 멈춘 집합 연산, 느린 노드, 메모리 부족, 손상된 체크포인트, 스케줄링 문제, 낮은 서빙 처리량, 감지되지 않는 손실 발산이 포함됐다. 에이전트는 설정이나 코드를 수정했고, 별도의 검증기가 새 클러스터에서 작업을 다시 실행해 수정 결과를 평가했다.
접근 수준은 설정 파일과 코드만 제공하는 경우, 여기에 읽기 전용 지표·로그와 버그 보고서를 추가하는 경우, 그리고 클러스터의 루트 권한과 작업 재실행 권한까지 제공하는 경우로 나뉘었다. 모든 모델은 각 작업을 세 조건에서 한 번씩 수행했다. Harbor + Terminus 2 하네스에서 추론 강도를 높게 설정하고 작업당 25분 제한을 적용했으며, AWS c7a.8xlarge 인스턴스(32 vCPU, RAM 64GB)를 사용했다.
평가 결과는 모델별 작업당 시도가 한 번뿐이므로 신중하게 해석해야 한다. 작업은 Fable 5.1과 Opus 5.5 코딩 에이전트로 개발해 편향이 생겼을 수 있으며, Sonnet 5.5와 Qwen 3.8 27B로 사전 테스트했다. 저렴한 모델도 더 높은 접근 권한을 받으면 더 유능한 모델을 앞설 수 있었지만, 파일만 볼 수 있는 조건에서는 가장 강한 모델만 과반수 작업을 해결했다. 강한 모델에서는 실시간 로그가 전체 클러스터 접근 권한을 거의 대체했다. 이 벤치마크에서 GPT-6 Luna는 Sonnet 5.5 기록 비용의 약 5%로 가장 나은 가격 대비 성능을 보인 것으로 나타났다.
다만 일부 오류는 정확한 진단에 노드 상태가 필요했고, 불완전한 체크포인트 같은 문제는 로그만으로 진단할 수 있는 경우가 있었다. 서빙 엔진처럼 설정만으로 정의된 작업은 파일 접근만으로 충분할 수 있다.
측정에는 여러 변수가 있었다. Sonnet 5.5는 하네스가 버린 추론에 비용의 39%를 썼고, 이 문제는 Harbor 이슈와 관련됐다. 따라서 Sonnet 5.5의 실제 작업당 비용은 하네스 기록보다 1.7배 높다. 평가 도중 추가된 Haiku 5.5는 반복 작업에 빠져 토큰을 소모해 제외됐다. Qwen 3.8 27B는 시험 실행에서 약 87%를 기록해 실행 간 편차를 드러냈고, 비용이 높고 성능이 낮았던 gpt-oss-120b는 32회 시도 뒤 중단됐다. 추론 제공업체의 처리량도 성능에 영향을 줬을 수 있으며, 오픈 웨이트 모델 결과에도 영향을 미쳤을 가능성이 있다.
평가자는 권한이 제한된 컨테이너에서 slurmd 동작을 고치기 위해 Slurm을 패치했다. 레드팀 검토에서는 일부 Docker 호스트명·네트워크·마운트가 작업 디렉터리 이름에서 만들어져 에이전트가 이를 통해 오류를 추론할 수 있는 정보 노출이 발견됐고, 평가 전에 수정됐다.
벤치마크는 CPU와 Gloo에서 실행됐다. 핵심 증상은 2×H100과 NCCL에서도 교차 확인했지만, 실제 GPU 클러스터 오류를 다룬 범위는 제한적이다. Pass@1의 변동성이 크고 하네스·추론 강도·양자화 방식은 미리 정해졌다. 로그 조건에는 실제 상황에서는 제공되지 않을 수 있는 버그 보고서도 포함됐다. 또 전체 클러스터 권한을 가진 최첨단 모델은 벤치마크에서 점수가 포화됐다.
2026년 10월 13일 업데이트에 따르면 Qwen3.8 Flash (Next)는 실시간 클러스터 조건에서 27B 모델과 비슷한 성능을 보였다. 하지만 해결한 작업 하나당 재제출 횟수 중앙값이 8회로, 27B의 1회보다 많았고 반복 실행을 할 수 없는 조건에서는 성능이 뒤처졌다.
코드는 zhebrak/brokenml에서 확인할 수 있다. 관련 자료로 SREGym, NeurIPS 2026, Incident-Arena, 2026, InfraBench, 2026, Williams 외, SWE-Serve, 2026, Φ-Bench, 2026, Jiang 외, TrainCheck, OSDI 2025, Grattafiori 외, The Llama 3 Herd of Models, 2024, Harbor가 제시됐다.
댓글 (0)
로그인하면 이 기사에 내 생각을 남길 수 있어요