TL;DR
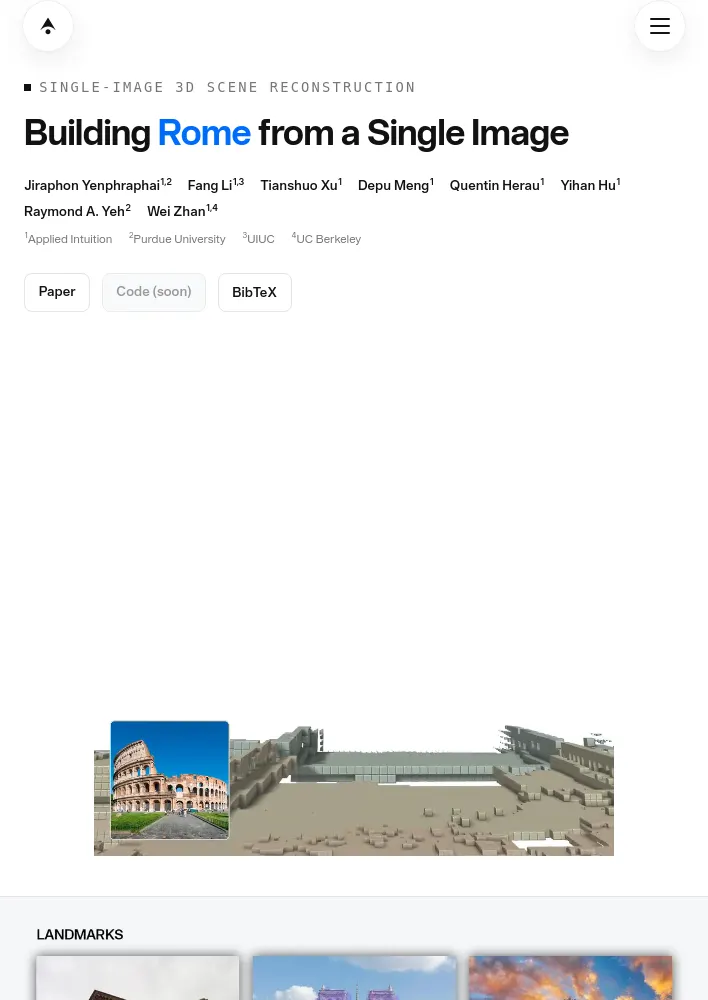
- 단일 이미지에서 전체 장면을 재구성하는 Building Rome from a Single Image은 거리별 적응형 장면 청크와 명시적 2D–3D 조건화, 자기회귀 생성을 결합한 기술임.
- 장면 청크는 거리에 따라 크기가 달라지며, 작은 청크는 가까운 세부 묘사를 유지하고 큰 청크는 먼 건물을 포함함.
- 이미지 특징을 관측된 표면에 투영하고 각 복셀을 비어 있음, 보임, 가려짐으로 구분하는 방식임.
- 인접 청크가 겹치는 잠재 표현을 재사용해 새로 생성되는 기하 구조가 장면과 일관성을 유지함.
- 웹 뷰어용 메시(mesh)는 약 150만 개의 면으로 단순화되며, 논문 그림과 영상에는 전체 해상도 메시가 사용됨.
단일 이미지 3D 장면 재구성
- 프로젝트 제목은 Building Rome from a Single Image임.
- 연구진은 Jiraphon Yenphraphai, Fang Li, Tianshuo Xu, Depu Meng, Quentin Herau, Yihan Hu, Raymond A. Yeh, Wei Zhan임.
- 소속은 Applied Intuition, Purdue University, UIUC, UC Berkeley임.
- 자료 항목은 논문(Paper), 코드(Code, 곧 공개 예정), BibTeX임.
인터랙티브 재구성 탐색
- 마우스 드래그로 회전하고, 스크롤로 확대·축소하며, WASD 키로 이동하고, QE 키로 아래·위 방향으로 이동함.
- 두 점을 선택해 거리를 미터 단위로 측정할 수 있음.
- 웹 뷰어의 메시(mesh)는 약 150만 개의 면으로 단순화되어 있으며, 논문 그림과 영상에는 전체 해상도 메시가 사용됨.
개요: 전체 장면용으로 재설계한 객체 생성기
- 적응형 장면 청크: 청크 크기가 거리에 따라 커지며, 작은 청크는 가까운 세부 묘사를 유지하고 큰 청크는 먼 건물을 포함함.
- 명시적 2D–3D 조건화: 이미지 특징을 관측된 표면에 투영하며, 각 복셀은 비어 있음, 보임, 가려짐 가운데 하나로 구분됨.
- 자기회귀 생성: 이웃한 청크가 겹치는 잠재 표현을 재사용해 새 기하 구조와 장면 사이의 일관성을 유지함.
비교
- 비교 항목은 입력(Input), 자체 결과(Ours), World Tracing, GenRecon, VolFill, Lyra 2.0임.
댓글 (0)
로그인하면 이 기사에 내 생각을 남길 수 있어요