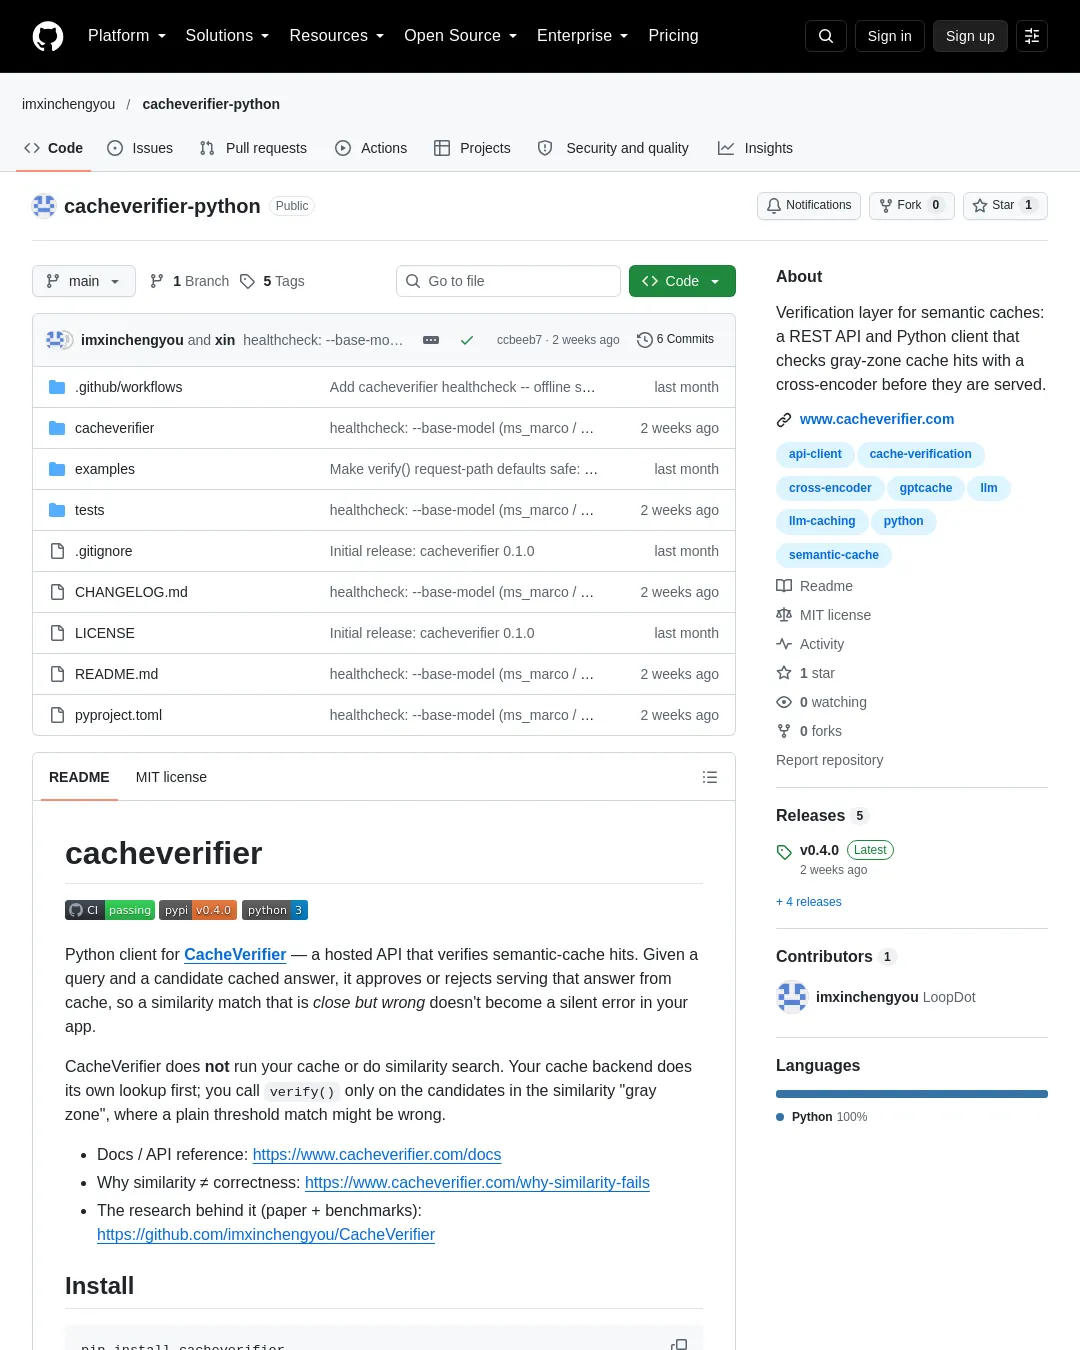
CacheVerifier는 의미 기반 캐시에서 찾은 답변을 실제로 제공해도 되는지 확인하는 호스팅 API와 Python 클라이언트를 제공한다. 캐시 검색을 대신하지는 않으며, 유사도만으로 정답인지 판단하기 어려운 후보를 검증하는 용도다.
캐시 백엔드가 먼저 답변 후보를 찾은 뒤 verify()에 질문과 후보 답변을 전달한다. 검증 결과가 승인되면 캐시 답변을 사용하고, 거부되면 LLM 호출로 넘어가는 방식이다. 제작자는 유사도 기준만으로는 틀린 답변이 앱에서 오류 없이 제공될 수 있다고 설명한다.
- 문서와 API 참고: CacheVerifier 문서
- 유사도가 정확성을 보장하지 않는 이유: Why similarity fails
- 관련 연구와 벤치마크: CacheVerifier 연구 저장소
설치와 요청 처리
Python 3.9 이상이 필요하며, 기본 런타임 의존성은 httpx다. GPTCache 연동과 오프라인 상태 점검은 선택적 추가 기능으로 설치한다.
pip install cacheverifier
# with the GPTCache adapter:
pip install "cacheverifier[gptcache]"
# with the offline Health Check (adds torch + sentence-transformers):
pip install "cacheverifier[healthcheck]"
API 키는 CacheVerifier 웹사이트에서 발급받는다. 안내에 따르면 셀프 서비스 검증과 파인튜닝은 카드 등록 없이 무료로 이용할 수 있다.
from cacheverifier import CacheVerifier

cv = CacheVerifier(api_key="cv_...")

query = "how do I cancel my subscription"
candidate = "Go to Settings > Billing > Pause subscription for a month." # from your cache

result = cv.verify(query, candidate)
if result.approved:
 answer = candidate # verified hit — skip the LLM call
else:
 answer = call_your_llm(query) # not trustworthy — fall through

# Later, once you know if it was actually right (thumbs-down, reopened ticket, ...):
cv.feedback(query, answer, was_correct=True, similarity_score=0.86)
VerifyResult에는 답변 승인 여부와 점수·기준값, 모델 버전, 서버 추론 시간, 결과가 성능 저하 상황에서 클라이언트 쪽에서 만들어졌는지를 나타내는 degraded가 포함된다. 승인 기준은 score >= threshold다.
검증은 요청 처리 경로에서 실행된다. 기본 검증 제한 시간은 1초이며, 파인튜닝·피드백·모니터링 호출에는 별도의 기본 제한 시간 10초를 적용한다. 제작자는 정상적으로 준비된 모델의 검증이 서버에서 수십 밀리초 걸린다고 설명한다. 시간 초과, 연결 오류, 5xx 응답에서는 기본적으로 실패를 닫는 방식으로 처리한다. 예외를 발생시키는 대신 경고를 기록하고 degraded=True, approved=False를 반환해 캐시 미스와 마찬가지로 LLM 호출로 넘어가게 한다. 잘못된 키나 요청, 요청 제한 초과에 해당하는 4xx 응답은 CacheVerifierError를 발생시킨다.
fail_open=True를 설정하면 서비스 장애 때도 답변을 승인한다. 제작자는 오래되거나 거의 맞는 답변을 제공해도 괜찮은 트래픽에만 이 설정을 고려하라고 안내한다. 아직 공식 가동 시간 SLA는 없다.
GPTCache 연동과 파인튜닝
GPTCache에서는 포크 없이 검증기를 유사도 평가기로 연결할 수 있다. 제공된 예제는 실제 응답 결과를 알게 된 뒤 피드백을 보고하는 방법도 보여준다. GPTCache 예제
피드백 데이터가 약 20건 이상 모이면 자체 회색 영역 라벨로 검증기를 파인튜닝할 수 있다. 다만 서비스 측 연구에서는 가장 어려운 데이터의 경우 약 1,000건보다 적은 데이터로 파인튜닝하면 성능에 오히려 불리한 경우가 많았다고 밝혔다. 결과 모델은 검토 대기 상태로 끝날 수 있으며, 이때는 명시적으로 활성화해야 한다. dry_run()은 모델을 배포하거나 데이터를 기록하지 않고 전달한 예제에서 기준 모델과 파인튜닝 모델의 AUC를 비교한다.
오프라인 상태 점검
dry_run()은 예제를 API로 전송한다. 네트워크 밖으로 운영 트래픽을 보내기 어려운 경우에는 cacheverifier[healthcheck]를 설치해 로컬에서 평가할 수 있다. 입력은 질문, 후보 답변, 정답 여부를 담은 JSON 배열 또는 JSONL이며, 선택적으로 각 행에 stale: true를 포함할 수 있다. 데이터는 시간순으로 학습·보정·시험 세트에 나뉘어 호스팅 서비스와 수치를 비교할 수 있도록 구성된다.
기본 모델은 영어 트래픽용 ms_marco다. nli는 영어용이며 부정 표현이나 개체 교체에 더 강하다고 안내하고, multilingual과 더 작은 multilingual_small은 중국어 및 기타 비영어 트래픽용이다. 영어 모델은 중국어 문자를 대부분 미등록 토큰으로 처리하므로 중국어 트래픽에 사용한 결과는 의미가 없다고 제작자는 경고한다. CLI는 영어 모델에 CJK 문자가 주로 입력되면 경고하며, Hugging Face 모델 ID나 로컬 모델 디렉터리도 지정할 수 있다.
오프라인 평가에서는 기본 모델이 Hugging Face에서 한 번 내려받아진 뒤 데이터가 외부로 전송되지 않는다. --emit-summary는 질의나 답변 텍스트를 제외하고 AUC, 건수, 비율만 담은 집계 파일을 만든다. 저장소에는 학습·보정·시험 데이터가 각각 3349건, 419건, 419건인 예시 결과가 실려 있으며, 이 예시에서 홀드아웃 AUC는 기본 검증기 0.6120, 파인튜닝 모델 0.7080으로 표시됐다. 이는 해당 예시 데이터의 결과다.
클라이언트는 단일·배치 검증과 피드백, 파인튜닝 작업 관리, 모델 활성화, 드리프트 상태와 회색 영역 기준 확인, 사용량·절감량 조회 기능을 제공한다. MIT 라이선스이며, 연구 저장소는 별도 라이선스를 따른다. Python 클라이언트 저장소
댓글 (0)
로그인하면 이 기사에 내 생각을 남길 수 있어요