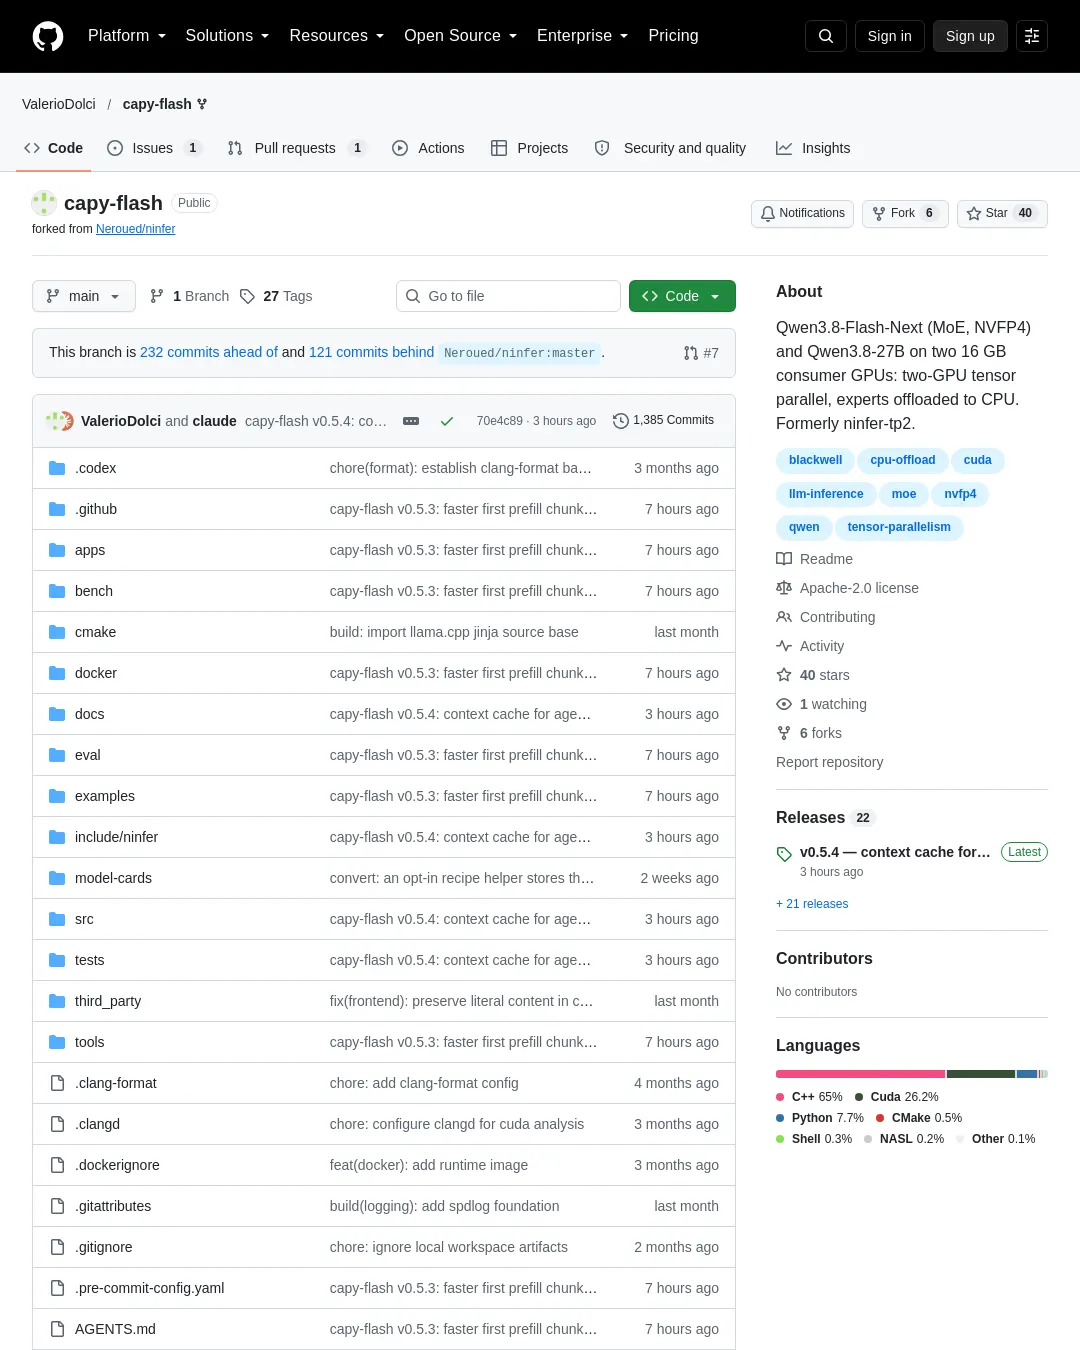
capy-flash는 16GB 그래픽카드 두 장에서 Qwen3.8-Flash-Next 125B MoE 모델을 실행하는 오픈소스 추론 엔진이다. 제작자는 RTX 5070 Ti 두 장을 쓴 한 대의 컴퓨터에서 Strata와 비교한 측정 결과를 공개했으며, 이 결과는 해당 장비에서 측정한 값이다.
같은 NVFP4 가중치를 사용한 에이전트 작업 재생에서 capy-flash는 첫 토큰까지 중앙값 1.82초, 생성 속도 초당 100.8토큰, 전체 처리 시간 243초를 기록했다. Strata 0.1.44.1은 각각 2.42초, 초당 78.3토큰, 314초였다. Strata의 3비트 IQ3_S 설정은 초당 124.1토큰으로 더 빨랐지만, 같은 코딩 작업에서 실행당 토큰을 23% 더 생성해 전체 작업 시간은 236초였다. 이 비교의 에이전트 작업은 합성 세션 3개, 53개 턴을 사용했다.
코딩 작업 5개를 각각 4회 실행한 평가에서는 capy-flash가 20회 모두 해결했고, 도구 호출 1,124건에서 형식이 잘못된 호출은 없었다고 제작자는 밝혔다. 같은 작업에서 Strata IQ3_S도 20회 모두 해결했지만 실행당 생성 토큰은 capy-flash의 42.9k보다 많은 52.7k였다.
설치에는 Linux, CUDA 13.1, 16GB 메모리의 RTX 50 시리즈 GPU 두 장, AVX-512를 지원하는 CPU, 약 70GiB의 여유 RAM이 필요하다. 모델은 64.6GiB의 전문가 가중치를 호스트 메모리에 두고 CPU에서 계산하며, 나머지는 두 GPU에서 처리한다. 제작자는 측정과 테스트가 한 대의 컴퓨터에서만 이뤄졌다고 명시했다.
프로젝트는 GitHub 저장소에서 확인할 수 있다. 미리 빌드된 파일은 릴리스 페이지, 변환된 모델 가중치는 Hugging Face에서 제공한다. capy-flash는 Apache License 2.0을 따르며, Qwen이나 NVIDIA와 제휴한 프로젝트는 아니다.
댓글 (0)
로그인하면 이 기사에 내 생각을 남길 수 있어요