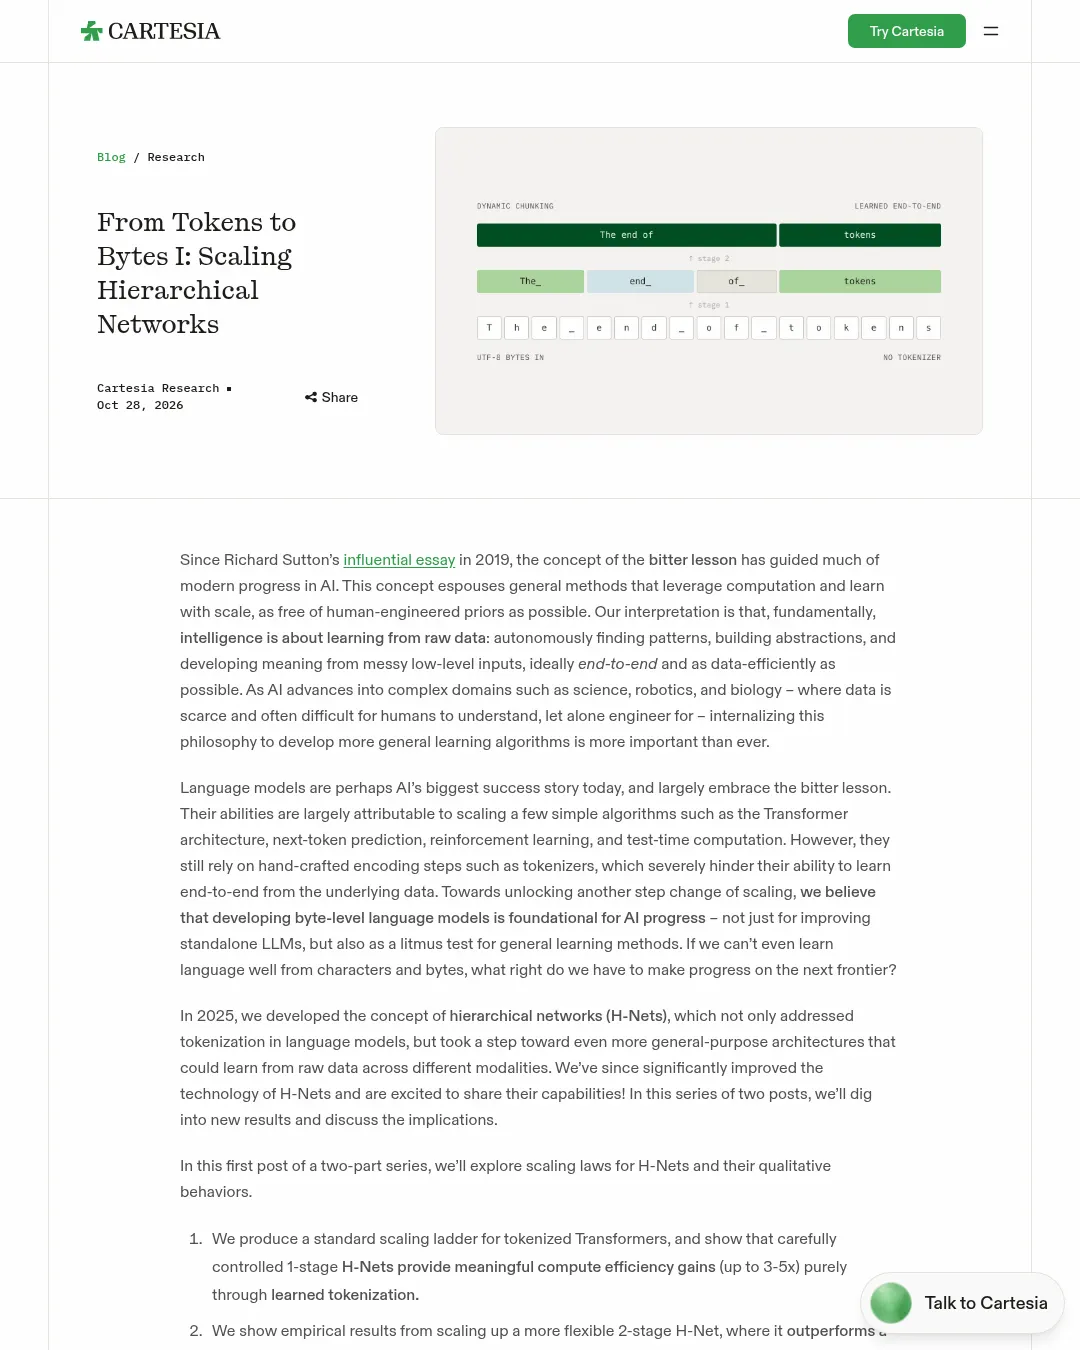
Cartesia Research는 바이트에서 의미 단위를 학습하는 계층형 네트워크(Hierarchical Networks, H-Nets)의 성능과 확장 실험을 공개했다. 회사는 토크나이저를 학습 과정 안에서 대체한 1단계 H-Net이 일부 평가에서 기존 Transformer보다 계산 효율이 높았고, 2단계 모델은 SmolLM3와 비슷한 평가 점수에 약 1조 토큰으로 도달했다고 보고했다. 다만 데이터와 계산량을 공정하게 맞추는 방법에는 여전히 연구 과제가 있다고 밝혔다.
H-Nets는 언어 모델이 바이트를 고정된 토큰으로 바꾸는 대신, 모델 안에서 입력을 의미 단위로 묶도록 설계됐다. 계층을 중첩해 문자에서 단어, 구절, 개념으로 이어지는 추상화를 학습한다는 구상이다. Cartesia는 이를 언어뿐 아니라 이미지와 생물학 데이터에도 적용하는 범용 아키텍처로 제시한다. 이번 글은 2부작 가운데 첫 편으로, 확장 실험과 학습된 동작을 다룬다.
리처드 서턴의 2019년 에세이가 제시한 ‘쓴 교훈’은 사람이 설계한 선험적 구조보다 계산량과 데이터 규모를 활용하는 일반적인 학습 방법이 장기적으로 유리하다는 관점이다. Cartesia는 지능의 핵심을 원시 데이터에서 패턴과 추상화, 의미를 자율적으로 찾는 일로 해석한다. 언어 모델은 Transformer, 다음 토큰 예측, 강화학습, 추론 시점 계산을 확장해 성과를 냈지만, 토크나이저 같은 수작업 인코딩이 원시 데이터에서 종단 간 학습하는 데 제약을 준다는 것이 회사의 주장이다.
토큰화와 H-Net 구조
언어 모델은 고정된 어휘의 토큰열을 입력으로 받는다. UTF-8의 256개 바이트 값을 각각 토큰으로 쓸 수도 있지만, 바이트열은 길어 처리 비용이 크다. 널리 쓰이는 바이트 페어 인코딩(Byte Pair Encoding, BPE)은 학습 말뭉치에서 자주 붙어 나오는 토큰 쌍을 반복해서 합쳐 어휘를 만든다. 예를 들어 Llama-3.2 토크나이저의 어휘 크기는 128k다. Cartesia의 데이터 구성에서는 BPE 토큰 하나가 평균 4.57바이트를 나타냈다. 하지만 이 압축 규칙은 학습 전에 고정되며, 사람이 설계한 처리 단계로 남는다.
H-Net은 바이트 입력을 인코더가 읽고, 학습된 청킹 단계가 여러 바이트를 묶어 더 적은 단위로 압축한다. 주 네트워크는 이 단위들을 처리하고, 디청킹 단계가 입력 해상도로 되돌린 표현을 잔차와 합친 뒤 디코더가 마무리한다. 1단계 H-Net은 한 번 청킹하고, 주 네트워크 자체를 H-Net으로 구성하면 여러 단계의 청킹을 재귀적으로 쌓을 수 있다. 이 구조에서 바깥 네트워크는 인코더와 디코더, 안쪽 네트워크는 주 모델을 가리킨다. 기존 방식처럼 토큰화를 완전히 오프라인에서 수행하는 대신, 모델이 종단 간으로 청킹을 학습한다.
Cartesia는 2025년에 처음 H-Net을 소개한 뒤 구조와 학습 방식을 크게 개선했으며, 일부 구조를 향후 공개할 계획이라고 밝혔다. 초기 논문은 논문과 소개 글에서 확인할 수 있다. 청킹이라는 용어는 인지심리학의 청킹 개념에서 가져왔다.
BPE와 1단계 H-Net 비교
먼저 Cartesia는 표준적인 BPE Transformer의 계산 최적 확장 곡선을 만들고, 토크나이저 부분만 1단계 바이트 H-Net으로 바꿨다. 데이터는 영어 70%, 코드 20%, 수학 5%, 다국어 5%로 구성했으며, 비율은 바이트 수 기준이다. 바이트·BPE 데이터는 같은 문서를 같은 경계에서 나눠 텍스트와 문서 경계를 맞췄다. 서로 다른 토크나이저의 손실을 비교하기 위해 바이트당 비트(bits per byte, bpb)를 사용했다.
기준선에는 일반적인 외부 BPE 토크나이저만 쓰지 않고, 동일한 학습 말뭉치로 어휘 128k의 BPE 토크나이저도 다시 학습했다. 이 토크나이저는 평균 토큰 길이를 Llama-3.2의 4.45바이트에서 4.57바이트로 늘려 데이터 압축을 조금 더 했다. 자체 학습 BPE 기준선만으로도 외부 토크나이저 대비 검증 손실과 후속 평가에서 약 1.1배의 계산 이득이 있었다고 Cartesia는 설명했다. 토큰 기준 데이터 구성은 영어 64.7%, 코드 23.7%, 수학 6.1%, 다국어 5.5%였다.
BPE 확장 사다리는 층 수 L을 기준으로 모델군을 구성했다. 은닉 차원 D는 128의 배수로 정하고 D/L을 약 75로 맞췄다. 모든 모델은 층 수와 같은 수의 어텐션 헤드, 헤드 차원 128의 다중 헤드 어텐션을 사용했다. MLP는 SwiGLU를 쓰고 중간 차원은 3.6D로 정한 뒤 128의 배수로 반올림했다. 예시 모델은 다음과 같다.
| 층 수 | 전체 매개변수 | 백본 매개변수 | 은닉 차원 | 어텐션 헤드 | FFN 차원 |
|---|---|---|---|---|---|
| L08 | 221M | 56.4M | 640 | 8 | 2304 |
| L12 | 399M | 169M | 896 | 12 | 3200 |
| L16 | 673M | 378M | 1152 | 16 | 4096 |
| L20 | 1.22B | 822M | 1536 | 20 | 5504 |
| L24 | 1.81B | 1.35B | 1792 | 24 | 6400 |
| L28 | 2.62B | 2.10B | 2048 | 28 | 7424 |
백본 매개변수에는 토큰 임베딩과 출력 계층이 포함되지 않는다. 학습에는 Muon 옵티마이저와 고정 비율의 워밍업·감쇠를 둔 WSD 학습률 스케줄을 사용했다. 일부 모델에서 배치 크기와 학습률을 조정하고, 더 큰 모델로 외삽할 하이퍼파라미터 확장 법칙을 맞췄다. FLOPs 계산에는 시퀀스 혼합 계층과 언어 모델 헤드를 포함했다. 소프트맥스 어텐션은 인과적 연산만 계산했는데, 비인과적 FLOPs까지 세면 긴 바이트 시퀀스를 처리하는 모델에 불리해지기 때문이다. 확장법은 Kimi와 MAI 등의 방법을 따랐다.
각 BPE 모델을 바이트 입력의 1단계 H-Net으로 바꿀 때는 안쪽 Transformer 구조를 그대로 유지했다. H-Net의 인코더·디코더는 BPE의 임베딩·출력 투영 계층과 매개변수 수 및 FLOPs를 맞췄고, 보조 손실을 이용해 압축률도 BPE의 4.57에 맞췄다. 배치 크기와 학습률 역시 BPE 모델 설정을 그대로 옮겼다. 즉 이 비교는 H-Net의 여러 장점을 최대한 활용한 구성이 아니라, 토큰화를 대체하는 역할만 하도록 제한한 실험이다.
Cartesia의 확장 곡선 분석에서 H-Net은 같은 검증 손실에 도달하는 데 BPE Transformer보다 계산량이 1.28배 적었다. 여러 데이터셋과 과제를 포함하는 Paloma와 OLMES 평가에서는 계산 효율 차이가 약 2배까지 커졌다. 각 평가에서 정답에 부여한 bpb를 ‘소프트 정확도’로 삼아 손실-계산량 확장 곡선을 다시 맞췄다. 후속 평가의 수치는 원문 그래프에서 Paloma 평균 1.83배, OLMES 평균 2.06배로 제시됐다.
코드에서는 격차가 더 컸다. 학습에 포함된 15개 프로그래밍 언어에서 H-Net의 계산 효율 배수는 Markdown의 1.49배부터 Go의 2.40배까지였고 중앙값은 2.04배였다. 학습 데이터에 없던 Stack v2 언어 10개에서는 Haskell의 2.19배부터 Prolog의 5.37배까지, 중앙값 3.10배였다. 해당 언어들이 학습에 없었다는 조건에서 얻은 결과다. Cartesia는 H-Net이 코드를 더 잘 처리하면서도 BPE보다 코드를 더 압축해 주 네트워크에 보내므로, 성능 향상이 추가 계산량에서 비롯된 것은 아니라고 해석했다.
회사는 이 결과의 가능한 설명으로, 원시 데이터에서 의미 단위를 학습해 분포가 달라져도 일반화하기 쉽다는 점과 코드처럼 고정 토크나이저가 다루기 어려운 데이터에서 유연하게 청킹한다는 점을 들었다. 추론 중 반복되는 변수명이나 함수명을 한 단위로 학습하는 동작도 코드 성능에 기여할 수 있다고 가설을 제시했다. 이는 회사가 제시한 해석이며, 다음 편에서 분포 밖 전이를 더 분석할 계획이라고 밝혔다.
다만 BPE와 H-Net을 비교하는 방식에는 한계가 있다. H-Net은 여러 청킹 단계를 쓸 수 있고 압축률도 데이터의 정보량과 의미에 맞춰 학습할 수 있지만, 이 실험은 단계 수와 압축률을 BPE에 맞췄다. 각 네트워크의 하이퍼파라미터도 BPE와 같게 둔 설정이 최적은 아니며, 이러한 제한은 BPE 기준선에 유리할 수 있다.
2단계 H-Net과 SmolLM3 비교
다음 실험에서는 제약을 줄인 2단계 H-Net을 공개 모델 SmolLM3-3B와 비교했다. SmolLM3는 Hugging Face가 공개한 3B Transformer이며, 학습 절차와 데이터 구성, 학습 중 여러 체크포인트가 문서화돼 있어 Cartesia가 재현을 시도할 수 있었다. 기준선은 총 11.1T 토큰의 3단계 학습(8T/2T/1T)이었지만, H-Net 실험의 목표 학습량이 더 짧아 1단계 데이터 구성만 사용했다. 공개된 데이터 출처로 기준선을 최대한 재현했고, 바이트 기준 데이터 비율을 맞췄다. SmolLM3의 토큰 기준 영어 웹/다국어/코드/수학 비율은 73.2 / 12.1 / 12.0 / 2.7이고, H-Net 실험에 맞춘 바이트 기준 비율은 76.5 / 10.9 / 10.3 / 2.2였다.
H-Net에는 추가 조정 없이 기준선의 최적화 설정을 적용했다. AdamW의 계수는 0.9와 0.95, 가중치 감쇠는 0.1, 그래디언트 클리핑은 1.0, 최대 학습률은 2e-4였고, 워밍업은 토큰 환산 5B에 해당하는 같은 WSD 스케줄을 썼다. 학습 마지막 15%에는 냉각 단계를 뒀다. 기준선의 냉각은 10T 토큰 뒤 세 번째 사전학습 단계에 나타났으며, 그 단계는 데이터 구성도 달랐다.
2단계 H-Net의 가장 바깥 바이트 계층에는 인코더와 디코더 각각 Mamba-2 4개 층을 뒀다. 다음 단계에는 슬라이딩 윈도 어텐션 블록과 양쪽의 Mamba-2 4개 층씩을 추가했다. 주 네트워크는 SmolLM3와 층별 형태가 같은 40층 Transformer이며 모든 층에서 전역 어텐션을 썼다. 바깥 인코더의 목표 압축률은 기존 연구에 따라 4배와 2배로 설정했다.
계산량을 바이트당으로 맞추기 위해 주 네트워크가 약 8바이트마다 한 위치를 처리하도록 했으며, 학습된 모델의 실제 압축률은 약 7.6배였다. Llama-3.2의 토큰 하나가 약 4.5바이트인 것과 비교하면 같은 텍스트에서 SmolLM3보다 토큰 수가 약 40% 적다. 절약한 계산량의 일부는 바깥 인코더·디코더에 쓰였다. 이들이 H-Net FLOPs의 약 43%를 차지했으며, 토큰 기반 Transformer의 임베딩과 언어 모델 헤드는 8%를 차지했다. 두 모델의 계산량은 바이트당 FLOPs 기준 2% 이내로 맞췄다. H-Net의 매개변수는 3.67B, SmolLM3는 3.08B였다. 차이는 주로 인코더·디코더와 주 네트워크에 추가한 네 층에서 발생했다.
공식 SmolLM3 평가와 같은 평가 모음에서 추론·상식 및 지식·이해 과제를 측정했다. Cartesia의 결과 그래프에서는 H-Net이 약 1T 토큰 학습 후 SmolLM3의 최종 평균 점수에 도달했고, SmolLM3는 약 11T 토큰을 학습했다. 두 모델은 바이트당 계산량을 맞췄으므로, 회사는 이에 비례해 학습 FLOPs도 절약됐다고 설명했다.
Cartesia는 데이터와 계산량을 공정하게 통제하는 방법이 명확하지 않다고 인정했다. BPE는 자주 나타나는 영어를 코드보다 더 많이 압축하지만, H-Net은 코드가 본래 압축 가능하다고 학습해 반대로 코드를 더 압축할 수 있다. 따라서 같은 텍스트를 보게 하고 전체 계산량을 맞추더라도 데이터 종류별 계산량은 달라진다. 데이터 종류마다 계산량을 같게 해야 하는지 등은 열린 연구 문제라고 밝혔다.
학습된 청킹과 추론 중 토큰화
Cartesia는 학습 중 H-Net의 표현이 변하는 모습을 원래 H-Net 논문의 초록으로 시각화했다. 별도로 학습하지 않은 예시도 영어와 다국어, 코드에서 분석했다. 비교 대상으로 SmolLM3가 쓰는 Llama-3.2 토크나이저, SmolLM3 학습 말뭉치로 만든 BPE, 사전 분할을 하지 않고 말뭉치에서 학습한 BPE(Corpus (NP)), 그리고 초기 H-Net(LH-Net)을 제시했다. 시각화에서 바이트를 가리키면 해당 청크와 경계 확률 p, BPE 토큰을 확인할 수 있다.
자연어 예시에서는 라틴·게르만 계열 언어뿐 아니라 중국어·일본어·한국어(CJK), 힌디어처럼 여러 바이트로 문자가 표현되는 언어에서도 의미 있는 경계를 보였다고 회사는 설명했다. ‘a foot’, ‘quite a few’처럼 함께 묶이는 단어들을 하나의 청크로 만들기도 했다. 사전 분할 없는 BPE 역시 여러 단어를 합칠 때가 있지만 beat a bear를 be at a bear로 나누는 등 어색한 경계가 나타났다는 비교다. H-Net의 경계는 고정된 문자열 패턴보다 문맥에 좌우된다고 Cartesia는 설명했다. 예를 들어 영어의 a는 뒤의 명사와 자주 묶이지만, 뜻이 다른 이탈리아어에서는 다른 단어와 덜 묶인다. 회사는 모든 언어에서 H-Net이 BPE보다 더 높은 압축률을 보였고, 문자 하나에 많은 바이트가 필요한 힌디어에서 차이가 특히 컸다고 보고했다.
코드에서는 BPE가 줄바꿈을 경계로 삼는 반면 H-Net은 여러 공백·탭·줄바꿈을 함께 묶을 수 있었다. 예시는 __init__(\n self,다. 반복되는 새 변수명이나 함수명 같은 패턴을 문맥에서 파악해 압축하는 동작도 관찰했다. 학습에 없던 프로그래밍 언어의 시각화도 제시했다.
초기 모델을 LH-Net이라 부른 Cartesia는 이 모델이 다음 청크의 시작을 본 뒤 경계를 정하도록 설계됐다고 설명했다. 미래 문맥을 더 활용하지만, 다음 바이트 예측과 여러 계층 모델링에는 부정적인 영향을 줬다는 것이다. 새 내부 모델은 영어 단어 내부에서 더 의미 있는 형태소 경계를 보였다고 비교했다. 예를 들어 trackers를 track과 ers, wondered를 wonder와 ed로 나눈다. 반면 초기 모델은 rhino를 r과 hino, mass를 mas와 s로 나누는 사례가 있었다. CJK처럼 문자가 여러 바이트로 표현되는 문자 체계에서는 다단계 LH-Net이 두 단계 청킹 뒤에도 문자를 제대로 분절하지 못하는 사례를 들었다.
H-Net의 토큰화는 학습 중뿐 아니라 추론 중에도 바뀔 수 있다. Cartesia는 이를 문맥 내 토큰화(in-context tokenization)라고 부른다. 처음 보는 단어나 개념은 여러 청크로 나누다가 같은 단어를 반복해서 접하면서 더 적은 청크로 묶는 동작, 반복 형식의 문장을 더 큰 청크로 압축하는 동작, 반복되는 문자·숫자 묶음의 패턴을 찾아내는 동작을 제시했다. 예시에서는 문자 블록 LURD, WHYV, FYB와 숫자 블록 2526, 3987, 3526을 묶었다.
언어 이외의 적용
Cartesia는 H-Net이 언어 모델링을 넘어 원시 데이터를 상위 패턴으로 묶는 구조로 쓰일 수 있다고 주장한다. 바이트가 모든 영역의 보편적 입력 단위는 아니다. 이미지·영상에는 픽셀, 오디오에는 파형, 생물학에는 뉴클레오타이드 같은 기본 단위가 있으며, 회사는 이를 바탕 단위(atom)로 보는 모델을 연구하고 있다고 밝혔다.
생물학 실험에서는 원핵생물 유전체의 DNA 다음 염기 예측을 수행했다. Transformer와 H-Net 모두 뉴클레오타이드 해상도로 입력을 받았고 어휘 크기는 4개와 특수 토큰이었다. H-Net 주 네트워크의 목표 압축률은 6배였다. 계산 최적 확장 사다리에서 H-Net은 세 평가 집합 모두 Transformer보다 5.83~7.06배 계산 효율이 높았다고 보고했다. 정확히는 일반 검증 세트에서 5.95배, gtdb_valid_small에서 5.83배, gtdb_test에서 7.06배였다.
학습 데이터는 OpenGenome 1단계의 원핵생물 유전체 GTDB 세트 약 2740억 뉴클레오타이드였다. 각 콘티그를 8,192개 이하의 뉴클레오타이드 구간으로 자르고 섞었다. 검증 세트는 학습에서 제외한 8,192개 구간, 약 5,600만 뉴클레오타이드였다. gtdb_valid_small은 5개 콘티그, 2만6천 뉴클레오타이드, gtdb_test는 50개 콘티그, 37만4천 뉴클레오타이드로 구성됐다. 두 공식 보류 세트는 모두 하나의 유전체에서 나왔지만, 그 유전체의 다른 콘티그는 학습에 포함됐다.
사람 유전체에서 관찰한 청킹은 학습 데이터에 포함되지 않은 영역에서 나타난 결과다. H-Net은 단백질을 지정하는 유전자 내부에서는 코돈 경계에 맞춰 대체로 한두 개에서 세 개 코돈 길이의 청크를 만들고, 구조가 덜한 비암호화 영역에서는 더 길고 덜 규칙적인 청크를 만들었다고 Cartesia는 설명했다. 엑손과 인트론, 겹치며 읽는 틀이 어긋나는 암호화 구간에서도 경계가 달라졌고, 알라닌 전달 RNA 유전자에서는 단일 문자가 자연 단위가 됐다. 반복 DNA에서는 정보가 적은 반복 구간 전체를 큰 단위로 묶는 동작도 관찰했다. 이런 생물학적 정렬은 학습 후반부에 나타났다고 회사는 덧붙였다.
이미지·영상 같은 고차원 데이터로 H-Net을 확장하는 일은 기술적으로 어렵지만, 계층 구조를 활용할 여지가 있다고 Cartesia는 밝혔다. 진행 중인 연구에서는 픽셀 공간 흐름 매칭 기준선 JiT의 백본을 다차원 H-Net으로 교체했다. 모델은 청킹 위치와 압축률을 학습하고, 공간·노이즈 제거 시간·이미지 샘플의 복잡도에 따라 계산을 배분한다고 설명했다. 정보가 적거나 균일한 영역을 묶고 중요한 세부에 집중하며, 감독 없이 원시 데이터에서 이미지의 의미적 분할을 찾아냈다는 주장이다. 인접한 패치의 유사성에 의존하는 기존 토큰 병합 방식과 달리, 2차원 H-Net은 국소적으로 붙어 있는 영역만 묶도록 강제되지 않는다. 회사는 가려진 물체로 분리된 배경 영역을 하나의 청크로 묶는 등 평면 이미지에서 3차원 구조를 추론하는 듯한 사례를 제시했다. 결과는 깨끗한 이미지가 아닌 노이즈 이미지의 t=0.7에서 시각화했다(t=0은 순수 노이즈, t=1은 깨끗한 이미지). 청크는 공간적으로 연속되거나 픽셀 수준에서 균일할 필요가 없다.
이번 글의 더 자세한 손실-손실 확장 분석과 H-Net의 효율 향상이 바이트에서 종단 간 학습하는 능력에서 비롯되는지에 관한 논의는 2부에서 다룰 예정이다. 인용 정보는 다음과 같다.
Cartesia Research, "From Tokens to Bytes: Scaling Hierarchical Networks", Cartesia Blog, October 2026.
또는 다음 BibTeX를 사용할 수 있다.
@article{cartesia2026hnet,
 author = {{Cartesia Research}},
 title = {From Tokens to Bytes: Scaling Hierarchical Networks},
 journal = {Cartesia Blog},
 year = {2026},
 month = {October},
 note = {https://www.cartesia.ai/blog/from-tokens-to-bytes-part-1}
}
각주에 따르면 이 연구의 초점은 토큰화이며, 게이트 어텐션·전문가 혼합(MoE)·하이브리드 상태 공간 모델 및 선형 어텐션 계층은 별개의 개선 사항이다. Cartesia는 내부 실험에서 H-Net과 이런 방법이 함께 쓰일 수 있다고 밝혔다. 초기 LH-Net의 미래 문맥 활용 방식은 BPE와도 일부 유사하다고 덧붙였다.
댓글 (0)
로그인하면 이 기사에 내 생각을 남길 수 있어요