TL;DR
- Castrag는 대형 팟캐스트 또는 오디오 아카이브를 전사·구조화 요약·의미 검색·근거 기반 질의응답이 가능한 형태로 만드는 소형 재개 가능 파이프라인이며, 230개 에피소드·약 145시간 처리 비용이 약 33달러임
- 대규모 전사 전체를 대형 언어 모델(LLM)의 컨텍스트 창에 넣거나 직접 읽는 방식은 확장되지 않으므로, 에피소드별 요약·의미 검색·검색 증강 생성(RAG) 질의응답의 세 가지 사용 경로를 제공함
transcribe.py,build_index.py,summarize.py,ask.py,analyze_themes.py가 각 단계의 출력만 읽고 자체 출력만 작성해 중단 후 재실행·추가 파일 처리·배치별 모델 교체가 가능함- 전사는 기본적으로 gpt-4o-mini-transcribe를 사용하고, 검색 인덱스는 수만 개 청크를 크게 넘기기 전까지 별도 벡터 데이터베이스 없이 NumPy 배열과 JSON 메타데이터로 구성함
- 실제 프로그램 실행으로 생성된 전사·요약·임베딩은 저작권 문제로 저장소에 포함되지 않으며, 저장소는 특정 프로그램의 콘텐츠가 아닌 자체 오디오에 적용하는 워크플로임
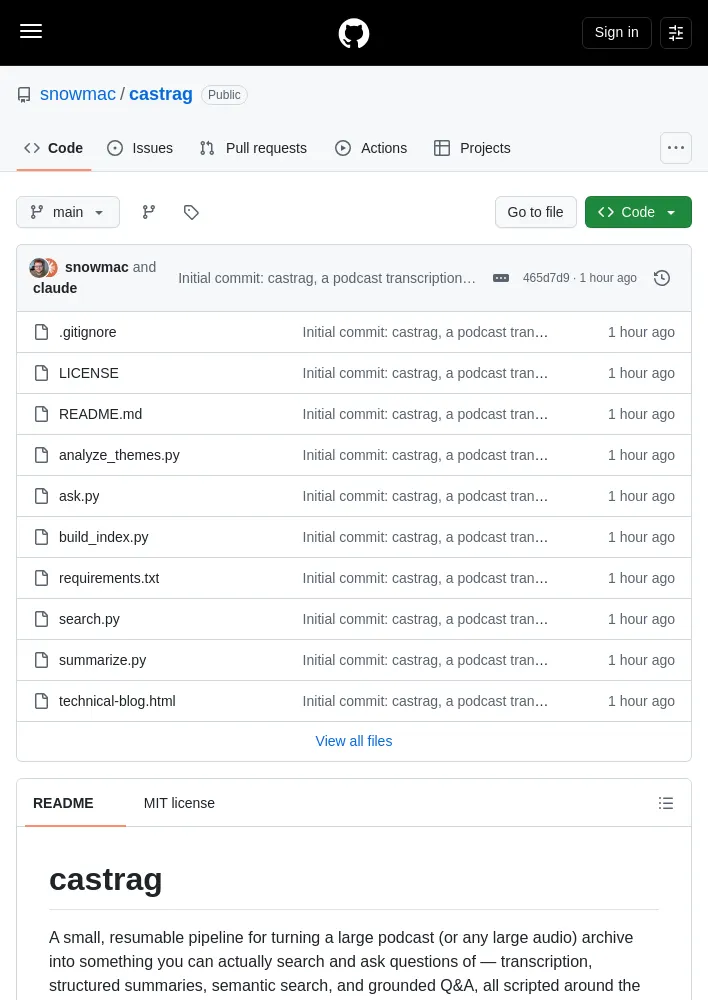
Castrag 개요
- 대형 팟캐스트 또는 오디오 아카이브를 실제로 검색하고 질문할 수 있도록 전사, 구조화 요약, 의미 검색, 근거 기반 질의응답으로 만드는 소형 재개 가능 파이프라인임
- 전체 과정은 OpenAI API를 중심으로 스크립트화됨
- 230개 에피소드, 약 145시간의 오디오를 처리하는 데 드는 총비용이 약 33달러임
- 작동 방식과 구현 과정에서 발생한 문제를 설명하는 전체 글은
technical-blog.html에서 확인 가능함 - 파일을 브라우저에서 직접 열거나 원하는 곳에 게시할 수 있음
존재 이유
- 대규모 전사 아카이브 전체를 대형 언어 모델(LLM)의 컨텍스트 창에 넣는 방식은 확장되지 않으며, 직접 읽는 방식도 마찬가지임
- 대형 오디오 아카이브를 활용하는 경로는 다음 세 가지임
- 구조화 요약: 에피소드별 주제, 인용구, 핵심 내용, 분위기를 빠르고 저렴하게 파악하는 개요임
- 의미 검색: 모든 내용을 한 번 임베딩한 뒤 질문과 관련된 정확한 구절을 밀리초 단위로 찾는 방식임
- 검색 증강 생성(RAG) 기반 질의응답: 자연어 질문을 입력하면 실제 원자료에 근거하고 원자료를 인용하는 답변을 생성하는 방식이며, 환각으로 만들어진 조언을 배제함
파이프라인
transcribe.py:mp3파일을 전사해transcripts/*.txt에 저장함build_index.py: 전사 파일을 읽어 임베딩과 메타데이터로 구성된index/를 생성함summarize.py: 전사 파일에서 에피소드별 구조화 요약을 생성해summaries/*.json에 저장함ask.py: 질문을 받아 인용된 답변을 표준 출력(stdout)으로 반환함analyze_themes.py: 요약 파일을 바탕으로 전체 코퍼스의 주제를 종합해themes.json에 저장함- 각 스크립트는 이전 단계의 출력 디렉터리만 읽고 자체 디렉터리에만 작성함
- 어떤 파일도 제자리에서 변경되지 않으며, 각 스크립트는 이미 완료된 작업을 건너뜀
- 이에 따라 어느 단계에서든 실행을 중단하거나 나중에 원본 파일을 추가하거나 배치 사이에 모델을 교체한 뒤 다시 실행할 수 있음
설정
python3 -m venv .venv로 가상 환경을 생성하고source .venv/bin/activate로 활성화함pip install -r requirements.txt로 의존성을 설치함brew install ffmpeg로ffmpeg를 설치하며, 다른 운영체제에서는 해당 플랫폼에 맞는 방식으로 설치함- 프로젝트 루트에
.env파일을 만들고OPENAI_API_KEY=sk-...형식으로 OpenAI API 키를 설정함
사용법
audio-files/에 오디오 파일을 넣은 뒤python transcribe.py를 실행해 전사함python summarize.py를 실행해 에피소드별 구조화 요약을 생성함python build_index.py를 실행해 의미 검색 인덱스를 구축함python ask.py "what did they say about X?"를 실행해 전사 내용에 근거한 질문을 수행함- 선택 사항으로
python analyze_themes.py를 실행해 전체 코퍼스의 주제를 종합함 summarize.py와analyze_themes.py상단에는SHOW_DESCRIPTION과FOCUS_THEMES라는 짧은 상수가 있으며, 자신의 프로그램과 추출하려는 내용에 맞게 수정해야 함- 두 상수에는 특정 팟캐스트의 콘텐츠가 아닌 일반적인 자리표시자가 기본값으로 포함됨
비용과 모델 관련 참고 사항
- 전사 기본 모델은
gpt-4o-mini-transcribe이며,whisper-1도 사용 가능함 whisper-1은 잡음이 많은 오디오에서 전사 품질이 조금 더 나을 수 있지만 분당 비용이 대략 두 배임- 업로드 전에 원본 파일을 약 15분 길이, 64kbps, 모노 세그먼트로 분할함
- 이 분할 방식은 API 파일 크기 제한을 충분히 피하면서 오디오 길이에 관계없이 작동함
- 동시성은 파일 단위와 파일별 청크 단위의 두 수준에서 제한됨
- 공급자의 요청률 제한을 지키면서 완전한 순차 처리로 전환하지 않기 위한 구성임
- 자체 요청률 등급에 맞춰
transcribe.py의FILE_WORKERS와CHUNK_WORKERS_PER_FILE을 조정할 수 있음 - 검색 인덱스는 단일
numpy배열과 JSON 메타데이터 파일로 구성됨 - 수만 개의 청크를 크게 넘어가기 전까지는 벡터 데이터베이스가 필요하지 않음
이 저장소에 포함되지 않는 것
- 실제 프로그램에 적용해 생성한 전사, 요약, 임베딩은 저장소에 포함되지 않음
- 해당 자료는 텍스트 형태라도 다른 주체의 저작권이 있는 오디오 콘텐츠이기 때문임
- 이 저장소는 특정 프로그램의 콘텐츠가 아닌 워크플로를 제공함
- 자체 오디오를 입력해 사용해야 함
라이선스
- MIT 라이선스이며, 자세한 내용은
LICENSE에서 확인 가능함
댓글 (0)
로그인하면 이 기사에 내 생각을 남길 수 있어요