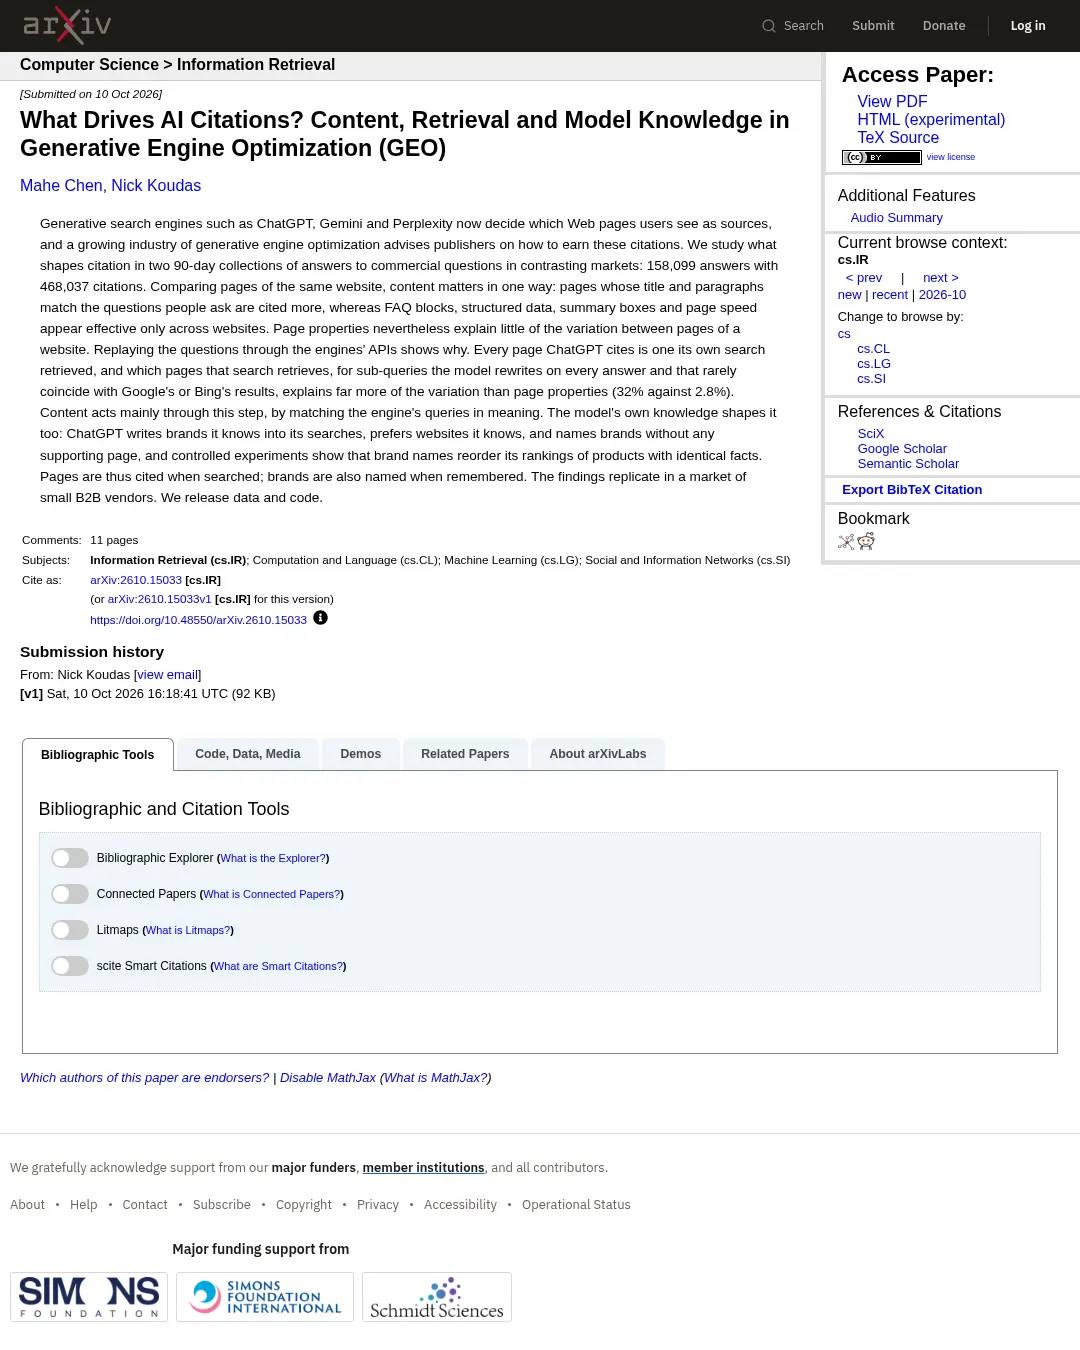
마헤 천(Mahe Chen)과 닉 쿠다스(Nick Koudas)는 생성형 검색의 출처 인용을 분석한 연구에서, ChatGPT가 어떤 페이지를 인용하는지는 페이지 구성 요소보다 검색 단계에서 어떤 페이지를 찾는지에 더 크게 좌우된다고 보고했다. 이 결과는 상업적 질문에 대한 답변 158,099건과 인용 468,037건을 90일간 모은 자료를 바탕으로 했다.
같은 웹사이트 안에서는 제목과 문단이 사람들이 묻는 질문과 잘 맞는 페이지가 더 많이 인용됐다. 반면 FAQ 블록, 구조화 데이터, 요약 상자, 페이지 속도는 서로 다른 웹사이트를 비교할 때만 효과가 나타났다. 연구진은 웹사이트 내부에서 페이지 특성만으로 인용 차이를 설명하는 비율은 작다고 밝혔다.
연구진이 질문을 검색 엔진 API로 다시 실행한 결과, ChatGPT가 인용한 페이지는 모두 자체 검색에서 찾아낸 페이지였다. 모델이 답변마다 다시 작성하는 하위 질문의 검색 결과는 구글이나 빙의 결과와 거의 일치하지 않았다. 자체 검색에서 어떤 페이지를 찾는지가 인용 차이의 32%를 설명한 반면, 페이지 특성은 2.8%를 설명했다. 콘텐츠는 주로 검색어와 의미상 잘 맞는 방식으로 이 단계에 영향을 미쳤다.
모델이 이미 알고 있는 브랜드도 영향을 줬다. ChatGPT는 알고 있는 브랜드를 검색어에 넣고 익숙한 웹사이트를 선호했으며, 뒷받침하는 페이지 없이 브랜드를 언급하기도 했다. 통제 실험에서는 사실이 같은 제품이라도 브랜드 이름에 따라 순위가 달라졌다. 연구진은 소규모 기업 간 거래(B2B) 업체 시장에서도 결과가 재현됐다고 밝혔으며, 데이터와 코드를 공개했다.
논문: arXiv:2610.15033 · PDF · HTML
댓글 (0)
로그인하면 이 기사에 내 생각을 남길 수 있어요