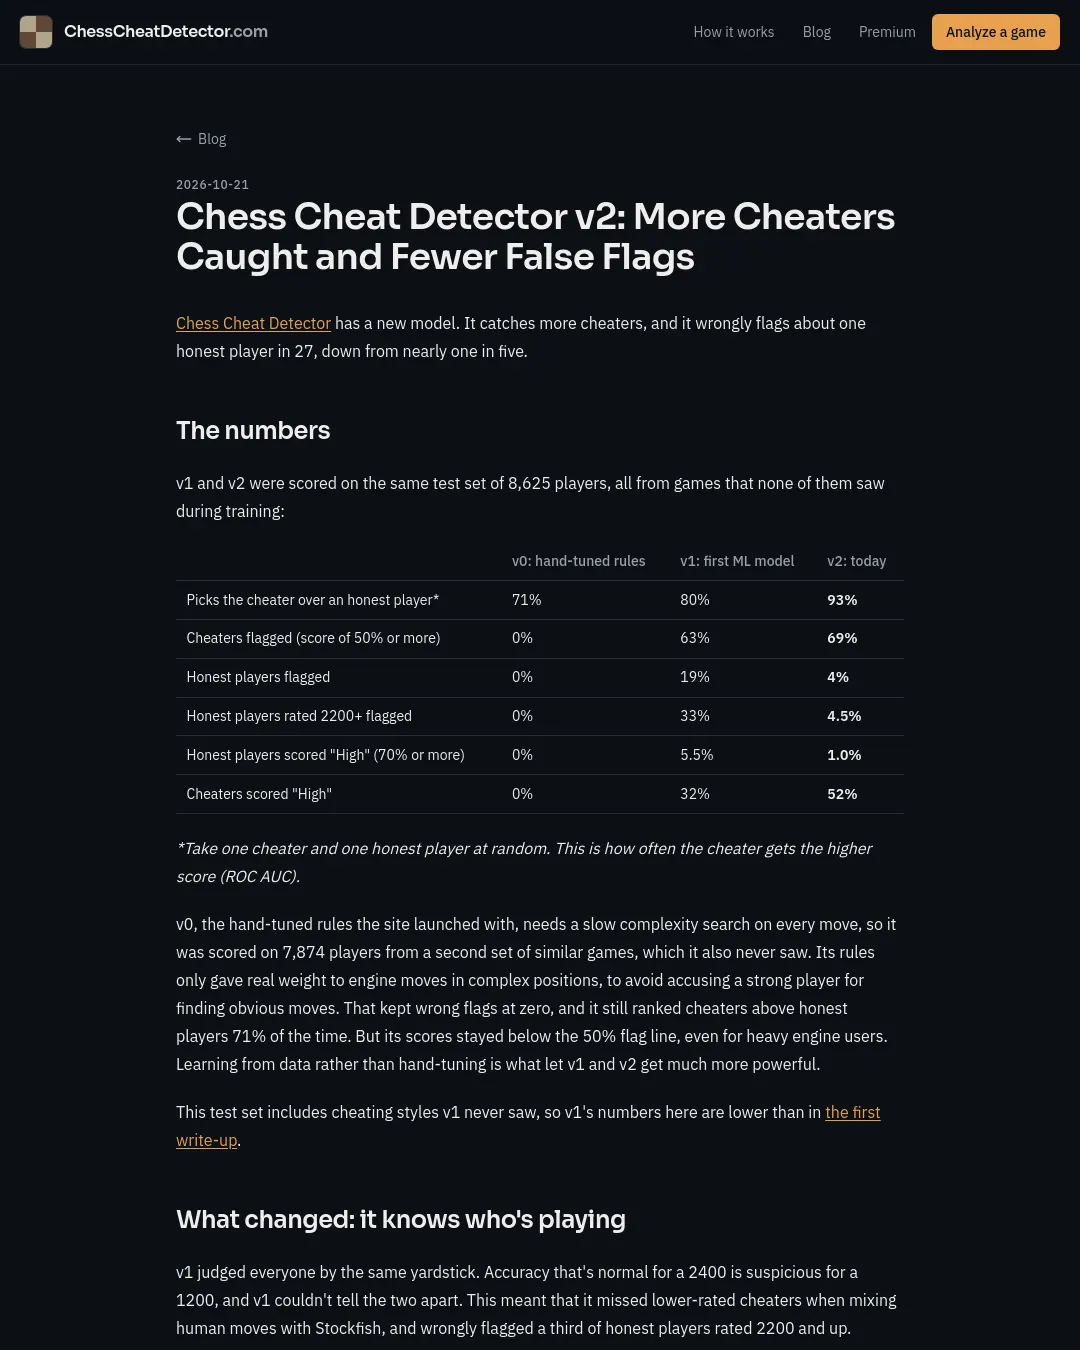
Chess Cheat Detector가 새 모델 v2를 공개했다. 제작자에 따르면 v2는 부정행위자를 더 많이 찾아내면서 정직한 플레이어를 잘못 지목하는 비율을 v1의 약 5명 중 1명에서 약 26명 중 1명으로 낮췄다.
테스트 결과와 달라진 점
세 버전은 학습에 사용하지 않은 게임에서 나온 플레이어 8,730명으로 구성된 같은 테스트 세트에서 평가했다. 다만 v0는 매 수마다 느린 복잡도 탐색을 해야 해 8,730명 중 7,874명만 평가했다.
| 측정 항목 | v0: 수작업 규칙 | v1: 첫 머신러닝 모델 | v2: 현재 모델 |
|---|---|---|---|
| 부정행위자와 정직한 플레이어를 한 명씩 무작위로 뽑았을 때 부정행위자의 점수가 더 높은 비율* | 71% | 79% | 93% |
| 부정행위자 중 50% 이상 점수를 받은 비율 | 0% | 60% | 67% |
| 정직한 플레이어 중 부정행위자로 지목된 비율 | 0% | 18% | 4% |
| 레이팅 2200 이상인 정직한 플레이어 중 부정행위자로 지목된 비율 | 0% | 32% | 5% |
| 정직한 플레이어 중 ‘높음’(70% 이상) 점수를 받은 비율 | 0% | 5.2% | 0.9% |
| 부정행위자 중 ‘높음’ 점수를 받은 비율 | 0% | 32% | 51% |
*수치가 높을수록 부정행위자와 정직한 플레이어의 점수를 잘 구분한다. 원문은 이 지표를 ROC AUC라고 설명한다.
v0는 복잡한 포지션에서 엔진이 제시한 수에만 실질적인 가중치를 줬다. 강한 플레이어가 쉬운 수를 찾았다는 이유만으로 의심받지 않도록 설계한 규칙이다. 그 결과 오탐은 없었지만, 엔진을 많이 쓴 플레이어도 부정행위 판정 기준인 50%에 미치지 못했다. 제작자는 수작업 규칙 대신 데이터에서 학습한 것이 v1과 v2의 탐지력을 높였다고 설명한다. 이번 테스트 세트에는 v1이 보지 못한 부정행위 방식도 포함돼 있어, v1의 수치는 첫 번째 설명 글에 실린 결과보다 낮다.
v1은 모든 플레이어를 같은 기준으로 평가했다. 레이팅 2400인 사람에게는 평범한 정확도가 레이팅 1200인 사람에게는 의심스러울 수 있지만, v1은 둘을 구분하지 못했다. 이에 따라 사람 수와 Stockfish 수를 섞어 두는 낮은 레이팅의 부정행위자를 놓쳤고, 레이팅 2200 이상인 정직한 플레이어의 3분의 1을 잘못 지목했다.
v2는 두 플레이어의 레이팅을 읽고 신경망(neural network)으로 각 수를 평가한다. 해당 레이팅의 사람이 그 수를 둘 가능성이 얼마나 되는지를 따진다. 레이팅 1200인 플레이어가 같은 레이팅의 사람이 거의 두지 않는 수를 계속 두면 두드러지지만, 레이팅 2400인 사람이 그 레이팅에 어울리는 방식으로 두면 그렇지 않다는 설명이다. 제작자는 이 변화가 성과 개선의 대부분을 이끌었으며, 오탐률이 레이팅 600부터 2600까지 3~5%로 비슷해졌다고 밝혔다. v1에서는 같은 범위에서 오탐률이 7%에서 32%로 증가했다.
레이팅이 없는 게임은 사이트에 제출된 게임의 약 15%다. 이 경우 v2는 레이팅을 무시하고 수만으로 평가한다. 제작자에 따르면 이 방식은 v1보다 플레이어 순위를 더 잘 매기고(82% 대 79%), 정직한 플레이어를 잘못 지목하는 비율도 낮춘다(10% 대 18%). 다만 더 신중하게 판정해 부정행위자를 찾아내는 비율은 60%에서 52%로 내려간다.
학습 데이터와 한계
v1은 시뮬레이션 게임 6,613개로 학습했고, 당시 부정행위자는 매 수마다 가중 동전을 던져 엔진을 사용할지 결정하는 한 가지 방식으로만 행동했다. 제작자는 실제 부정행위가 그렇게 일정하지 않다고 보고 데이터 세트를 3만 3,000개가 넘는 게임으로 늘리고, 세 가지 방식을 넣었다.
- 동전 던지기: 매 수마다 일정한 확률로 엔진에 도움을 요청한다.
- 연속 사용: 여러 수 동안 엔진을 켰다가 끈다.
- 실수 방지 확인: 자기 수를 두되 실수를 막기 위해 엔진을 사용한다. 이 방식의 부정행위자는 대개 한 게임에서 엔진을 몇 번만 써 가장 찾기 어렵다.
실수 방지 확인 방식의 부정행위자는 v1에서 47%가 지목됐고 v2에서는 64%가 지목됐다. 순위만 비교하면 v1은 이 부정행위자의 점수가 정직한 플레이어보다 높은 경우가 72%였으며, v2에서는 93%였다.
평가에 사용한 게임은 시뮬레이션 데이터다. 정직한 플레이어도 실제 사람이 아니라 Lichess 플레이어를 모방해 시뮬레이션한 것이다. 사이트에서 분석한 실제 게임을 대상으로 한 초기 점검에서는 거의 모든 레이팅대에서 실제 플레이어가 시뮬레이션된 정직한 플레이어와 비슷한 정도로 인간다운 수를 뒀다. 제작자는 이를 고무적인 결과라고 했지만, 결론을 내리기에는 충분하지 않다고 덧붙였다.
또한 사이트마다 레이팅 척도가 다르다. Chess.com 레이팅은 보통 Lichess보다 낮고, 새 Lichess 계정은 게임을 치르기 전 1500에서 시작한다. 제작자는 이 차이를 보정하는 일을 다음 과제로 꼽았다. 점수는 확률일 뿐 결론이 아니며, 정직한 플레이어도 이례적인 경기를 할 수 있다고 설명한다.
의심스러운 게임이 있다면 게임을 붙여 넣어 v2의 분석을 확인할 수 있다.
댓글 (0)
로그인하면 이 기사에 내 생각을 남길 수 있어요