TL;DR
- Anthropic의 Claude Code용
claude-api플러그인은build_eval과hill-climb명령으로 평가를 만들고 평가 판정기를 확인하며 애플리케이션을 개선하도록 돕지만, 데이터 검토와 평가기 제작 순서에 문제가 있음. - 플러그인은 대화 데이터를 먼저 살펴보지 않은 채 잠재적 실패 사례를 제시하고 평가 대상을 선택하도록 유도함.
- 긴 대화 파일을 편집기에서 읽고 채팅으로 수정 의견을 전하도록 요청하며, 데이터 검토 인터페이스도 충분히 제공하지 않음.
- 통화 전환 평가기가 네 가지 실패 유형을 한꺼번에 검사하고 설명도 불명확해, 평가 범위를 좁히고 코드나 판정 프롬프트를 확인하는 편이 바람직함.
- 자동 평가 도구 중에서는 문제 발견 성능이 인상적이지만, 데이터 탐색과 검토 인터페이스가 개선되기 전까지 사용을 보류하는 입장임.
문제점
- 평가 도구 리뷰는 소프트웨어 변화가 잦아 유효 기간이 짧기 때문에 보통 작성하지 않지만, Anthropic의 자체 도구는 평가에 접근하는 방식에 영향을 줄 가능성이 있어 직접 사용해 봄.
- Isaac Flath와 아파트 임대 보조원의 대화 기록을 대상으로 도구를 사용하며 다음과 같은 점을 확인함.
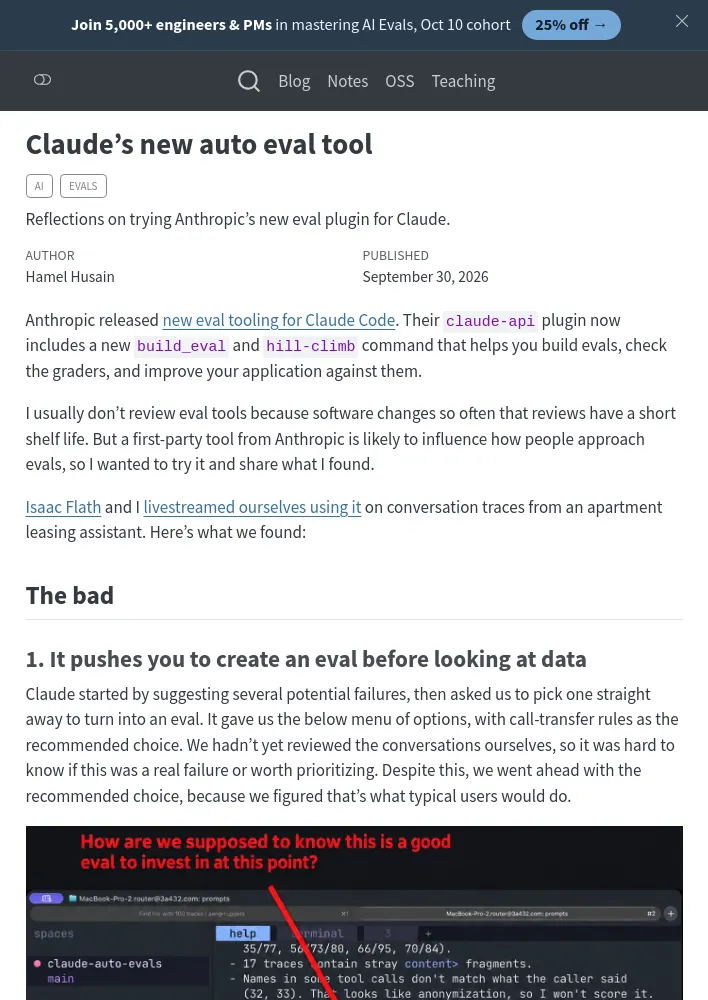
- 데이터를 보기 전에 평가부터 만들도록 유도함. Claude는 잠재적 실패 사례를 몇 가지 제안한 뒤, 곧바로 하나를 골라 평가로 만들도록 요청함. 통화 전환 규칙을 추천했지만, 대화를 직접 검토하기 전이라 실제 실패인지 우선순위가 높은 문제인지 판단하기 어려웠음. 일반적인 사용자가 따를 만한 추천이라고 보고 해당 항목을 선택함.
- 먼저 데이터를 살펴 문제를 이해하고 어떤 평가를 작성할지 우선순위를 정하는 편이 바람직함. 에이전트가 문제를 찾는 데 도움을 줄 수 있지만, 진행하기 전에 오류 분석을 통해 주의를 기울일 실패 유형을 결정해야 함.
- 충분한 맥락 없이 판단을 검증하도록 요청함. Claude는 통화 전환 실패와 관련된 데이터를 검토할 마크다운 파일을 생성하고,
inputs.md를 훑어본 뒤 잘못된 라벨을 알려 달라고 요청함. 긴 대화를 편집기에서 읽고 수정 사항을 별도 채팅으로 전달해야 하는 방식임. - 코딩 에이전트라면 대화를 쉽게 읽고 그 자리에서 의견을 남길 수 있는 주석 인터페이스를 만들었어야 한다고 판단함. 이후 웹 앱을 만들어 달라고 요청해 그 앱을 사용함.
- 작업 흐름 후반에는 통화 전환 실패 평가기를 처음 구성한 뒤, 라벨별 전체 건수를 보여주고 “다르게 점수를 매길 사례가 있느냐”고 물었지만 라벨의 정확성을 판단할 정보가 부족했음. 데이터 이해를 돕기 전에 결과물을 만들거나 승인을 요청하는 경향이 반복됨.
- 평가기 범위가 지나치게 넓음. 도구가 만든 통화 전환 평가기는 다음 네 가지 실패 유형을 한꺼번에 검사함.
- 확인을 두 번 이상 요청하거나 확인 없이 전환함. — 대형 언어 모델(LLM) 판정 방식
- 발신자의 동의와 전환 사이에 발화를 함. — 코드 기반 평가
- 전환 중 또는 전환 후에 발화를 함. — 코드 기반 평가
- 전환을 “트리거한다”는 말처럼 도구 작동 방식을 소리 내어 말함. — 코드 기반 평가
- 한 평가기에 너무 많은 항목이 묶여 있음. 한 번에 오류 하나에 집중하도록 범위를 좁히거나, 적어도 코드 기반 평가와 대형 언어 모델 판정이 필요한 항목을 분리하는 편을 선호함.
- Claude가 제시한 평가기 설명도 혼란스러움.
protocol_ok가 핵심 지표임. 네 가지 검사가 모두 통과해야 사례가 통과함. “전환하면 안 되는” 통화에서는 전환이 발생하지 않으면protocol_ok가 1임.
- 이 설명은 읽기 어렵고, 어떤 평가기가 만들어지는지 이해하려면 코드나 판정 프롬프트를 직접 확인하는 편이 나음. 평가는 특히 중요한 작업이므로 프롬프트를 읽는 것이 유익함.
좋은 점
- 이 플러그인은 다른 자동 평가 접근법에서 발견하지 못한 문제를 기본 설정만으로 찾아내는 능력이 인상적임.
- 인계 처리, 형식, 음성 에이전트 등의 문제를 발견함. 에이전트와 함께 데이터를 반복적으로 살펴보는 편이 여전히 낫지만, 한 번의 실행으로 문제를 찾는 접근법 중에서는 가장 뛰어난 성능을 확인함.
- 도구 소개 글에서 데이터 검토, 지능적인 표본 추출, 자체 평가 데이터의 포화 방지 등을 강조하는 방향에 동의함. 더 많은 사람이 이런 방식으로 평가를 고민하는 점을 긍정적으로 봄.
사용할 것인가?
- 현재로서는 사용을 보류하는 편임. 평가기를 확정하기 전에 데이터를 탐색하도록 돕고, 처음부터 더 나은 검토 인터페이스를 제공하는 작업 흐름이 필요함.
- Shreya와 함께 만든 평가 기술을 사용하면 코딩 에이전트로도 만족스러운 결과를 얻을 수 있음. 이 방식은 의견이 덜 개입된 대신 더 유연함.
- Claude 평가 플러그인 제작자와 이후 대화를 나눴으며, 제작자는 의견을 긍정적으로 받아들이고 플러그인을 이에 맞춰 업데이트하겠다고 밝힘. 따라서 가까운 시일 안에 변화가 있을 것으로 예상함.
- 이 사용 경험이 다른 평가 도구를 살펴볼 때도 참고가 되기를 바람. 평가를 선택하기 전에 도구가 데이터 이해를 돕는지 확인하고, 평가 판정 결과를 꼼꼼히 살펴야 함.
- 데이터 탐색과 주석 작업의 마찰을 줄이려면 평가 작업 흐름의 상당 부분이 채팅보다 웹 애플리케이션에서 이뤄져야 한다고 봄.
평가 도구가 작업 흐름의 중심에 데이터 검토를 두지 않는다면 사용할 가치가 없음.
댓글 (0)
로그인하면 이 기사에 내 생각을 남길 수 있어요