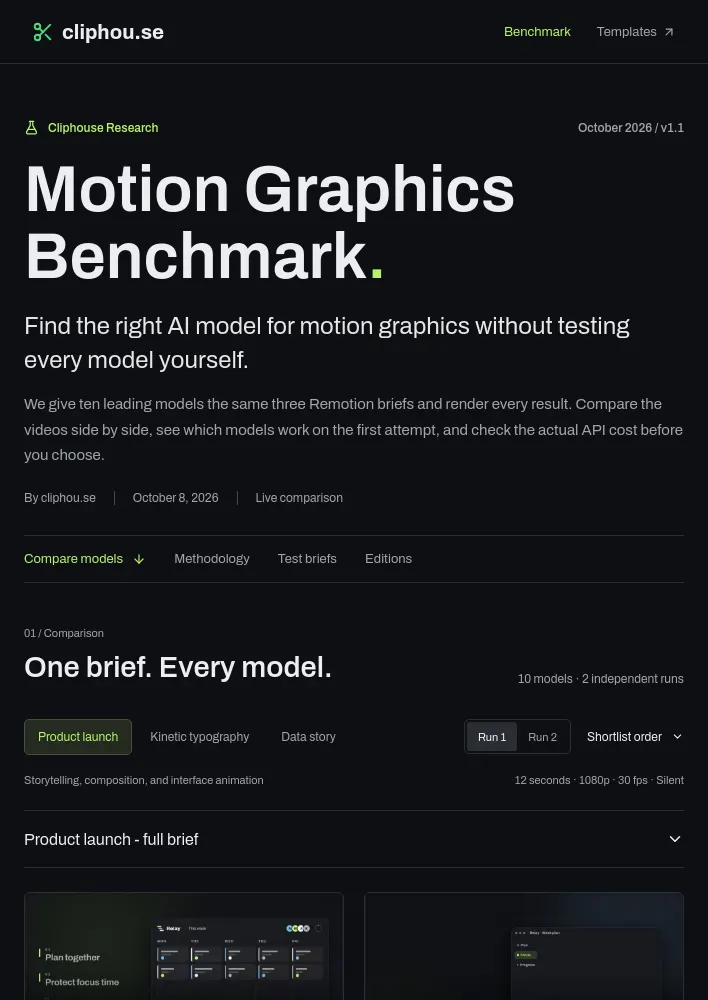
Cliphouse가 10개 언어 모델에 같은 모션 그래픽 과제를 제시한 벤치마크를 공개했다. 첫 번째 과제의 60회 실행은 모두 렌더링을 마쳤지만, 영상 검토 점수는 아직 공개되지 않았다. 이 비교는 텍스트로 영상을 만드는 모델이 아니라 모션 그래픽 코드를 작성하는 언어 모델을 대상으로 한다.
- 3개 고정 브리프마다 2회씩 독립 실행해 총 60개 영상을 만들었다. 미완료·실패 제출은 0건이며, 60개 실행이 모두 끝났다.
- 모델은 가격대별로 선정한 표본이며 인기 순위가 아니다. 두 차례의 블라인드 검토가 끝나기 전에는 점수를 공개하지 않는다.
- 첫 번째 브리프는 Remotion으로 12초, 1080p, 초당 30프레임의 무음 제품 출시 영상을 만드는 과제다.
첫 번째 브리프와 실행 결과
과제는 가상의 팀 계획 앱 ‘Relay’를 소개하는 제품 출시 영상이다. 0~3초에는 ‘Relay’와 ‘Make room for focused work’를, 3~9초에는 애니메이션 제품 인터페이스로 ‘Plan together’, ‘Protect focus time’, ‘See progress’를 보여줘야 한다. 9~12초에는 ‘Start your next week with Relay’를 표시하고 마지막 문구를 최소 2초 동안 읽을 수 있게 해야 한다. 제공된 글꼴과 색상 팔레트를 사용하고, 레이아웃·시각 스타일·전환은 모델이 선택한다. 추가 주장, 외부 에셋, 오디오는 허용하지 않는다. 컴포넌트 계약과 전체 프로토콜이 공개돼 있다.
공개된 실행 항목은 Anthropic의 Claude Opus 5.5, Claude Sonnet 5.5, Claude Haiku 5.5, OpenAI의 GPT-6.1 Sol과 GPT-6 Luna, Google의 Gemini 3.8 Flash, DeepSeek V4.1 Flash, GLM 5.3 FlashX, Qwen3.8 2.4T A95B, Kimi K3다. 시각 점수는 전 항목에서 검토 대기 상태다. API 비용과 생성 시간은 모델별로 공개되며, 예를 들어 Claude Opus 5.5는 0.374달러와 211.0초, GPT-6 Luna는 0.0066달러와 130.0초로 기록됐다. 이는 각 실행의 기록이지 품질 순위는 아니다.
DeepSeek V4.1 Flash와 GLM 5.3 FlashX는 첫 시도에서 각각 완료 토큰 제한 초과와 JSON 오류로 실패한 뒤 자동 복구 절차에서 렌더링에 성공했다. 복구 비용과 추가 시도는 전체 비용·시간에 포함해 기록하고 별도로 항목화한다. 복구 성공은 코드가 컴파일되고 렌더링됐다는 뜻일 뿐, 시각 품질이나 브리프 준수 여부가 승인됐다는 의미는 아니다. 따라서 첫 시도 성공으로 집계하지 않는다. 복구 결과, 복구 프로토콜, 원래 결과를 확인할 수 있다.
각 실행에는 생성 코드와 요청 정보, 모델 ID, 제공업체, 추론 설정, 생성 시간, 렌더 시간, API 비용이 공개된다. 아래 링크에서 개별 소스 코드, 요청, OpenRouter 모델 페이지를 볼 수 있다.
- Claude Opus 5.5: 소스, 요청, OpenRouter
- Claude Sonnet 5.5: 소스, 요청, OpenRouter
- Claude Haiku 5.5: 소스, 요청, OpenRouter
- GPT-6.1 Sol: 소스, 요청, OpenRouter
- GPT-6 Luna: 소스, 요청, OpenRouter
- Gemini 3.8 Flash: 소스, 요청, OpenRouter
- DeepSeek V4.1 Flash: 소스, 요청, OpenRouter
- GLM 5.3 FlashX: 소스, 요청, OpenRouter
- Qwen3.8 2.4T A95B: 소스, 요청, OpenRouter
- Kimi K3: 소스, 요청, OpenRouter
평가 방식과 한계
모든 요청은 OpenRouter를 거치며, 생성 코드는 같은 Remotion 환경에서 렌더링한다. 세 가지 고정 브리프와 두 번의 독립 실행, 단일 컴포넌트 계약, 같은 로컬 글꼴·색상 팔레트, 추론 토큰을 포함한 32,000토큰 완료 한도를 적용한다. 웹 검색, 외부 에셋, 기존 Cliphouse 구성은 허용하지 않는다.
컴파일이나 렌더링에 실패한 경우에만 오류 로그를 제공해 한 번 더 요청한다. 성공한 영상에는 창작 수정을 요청하지 않는다. 원래 결과와 복구 비용은 별도로 보존하며, 전송 오류도 따로 기록한다. 자동 복구는 원래 실패한 항목에 한해 최대 세 차례 추가 요청을 허용한다. 모델, 고정 제공업체, 추론 설정, 브리프, 글꼴, 팔레트, 렌더러를 그대로 유지하고, 이전 응답과 전체 진단 정보를 전달한다. 첫 렌더 성공 시 중단하며 사람이 코드를 고치거나 창작 피드백을 제공하지 않는다. 복구 요청은 64,000토큰 한도를 쓰며, 원래의 JSON 전용 형식 대신 TSX를 직접 출력하도록 한다. 단일 코드 펜스나 유효한 소스 JSON 래퍼도 코드 편집 없이 허용한다.
두 명의 검토자가 모델명과 비용을 가린 채 각 기준을 1점(낮음)부터 5점(높음)까지 평가하고, 가중 점수를 평균한다. 시각 디자인은 30%, 동작은 25%, 가독성은 25%, 브리프 준수는 20%를 차지한다. 디자인에는 위계·구성·색상·시각적 일관성을, 동작에는 타이밍·연속성·의도 있는 애니메이션·전환을 반영한다. 가독성은 문구의 가독성, 안전 여백, 장면을 이해할 충분한 시간으로 평가한다. 브리프 준수는 문구·수치·순서·요청된 길이가 맞는지 본다. 시각 품질 점수에는 비용과 신뢰성을 포함하지 않는다. 두 번의 실행은 탐색적 근거이며 통계적으로 확정적인 순위가 아니므로, 비교 범위가 모델마다 갖춰지기 전에는 종합 우승 모델을 선정하지 않는다.
프로토콜 1.1은 이전 Haiku 설정 시험에서 추론 토큰 13,309개를 사용한 뒤 기존 16,000토큰 한도에 걸려 출력이 잘린 일을 반영해, 비교 대상 60회 실행 모두의 한도를 32,000토큰으로 정했다. 시험 비용 0.008달러는 지출 기록에는 남지만 모델 비교에서는 제외했다. 해당 파일럿의 컴파일 실패 복구에는 상세 TypeScript 진단 대신 스택 추적만 제공됐다. 따라서 복구 결과는 잠정적으로 봐야 하며 첫 시도 결과에는 영향이 없다.
버전 기록
새 모델 버전은 진행 중인 비교에 추가한다. 월간 보고서는 테스트한 버전, 프로토콜, 결과를 보존하며 테스트 변경에는 새 프로토콜 버전을 부여한다. 2026년 10월판은 10월 8일 기준 모델을 선정했으며, 모델 이용 가능 여부와 가격은 바뀔 수 있다. 2026년 10월판: 01호, 60회 실행 공개. 모델 선정 참고 자료로 OpenRouter 모델 목록, 사용량 순위, 제공업체 라우팅 안내를 제시한다.
댓글 (0)
로그인하면 이 기사에 내 생각을 남길 수 있어요