TL;DR
- Codex의 gpt-6-astra에 같은 SVG 펠리컨 그리기를 요청한 비공식 조사에서 계정에 따라 출력 품질과 속도가 달랐으며, 일부 계정은 gpt-5.6-luna와 유사한 양상을 보임.
- 차이는 프롬프트, 설정, 클라이언트 버전, 시간대로 설명되지 않았고, 조사 데이터에서는 2026년 9월 20일 09:00 UTC경 갑자기 나타남.
- 영향 계정은 응답당 출력량이 약 25% 적고, 사용자에 의해 응답이 중단되는 빈도가 약 20배 높음.
- 서버 측을 확인할 수 없어 원인이나 실제 제공 모델을 확정할 수 없으며, 계정별 실험·라우팅·정책·용량 라우팅 가능성을 구별할 수 없음.
- 계정 소유자는 로컬 Codex 세션 로그를 분석하는 Python 검사 스크립트로 응답 스트리밍 속도를 확인할 수 있지만, 이상 없음 결과가 영향을 완전히 배제하지는 않음.
펠리컨 그림
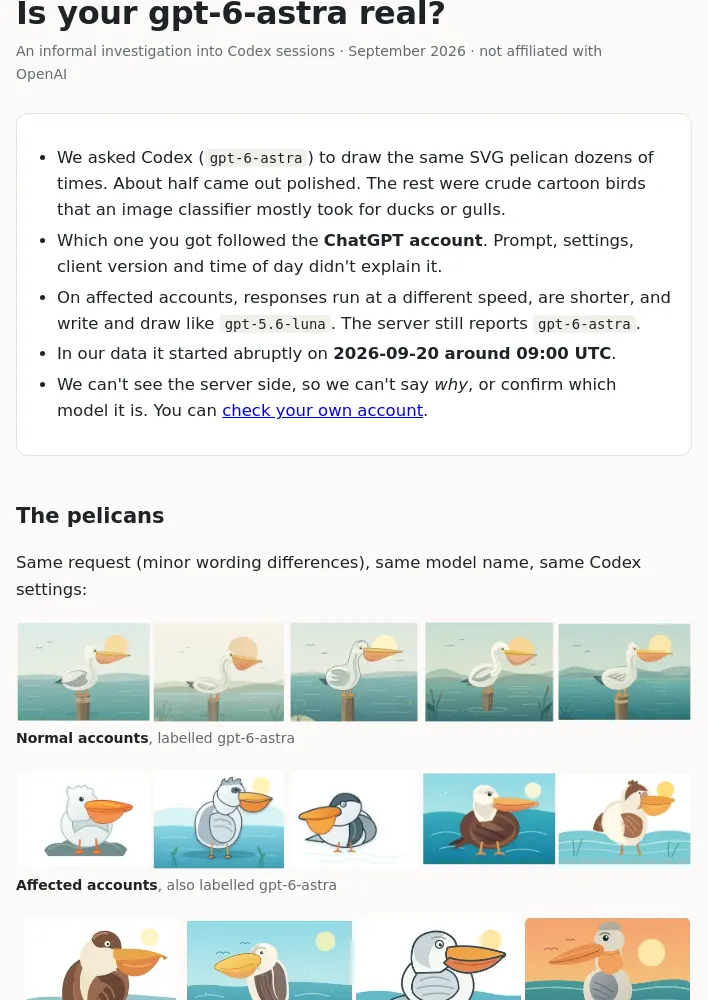
- Codex에서 같은 요청을 약간씩 표현만 바꾸어 수십 차례 실행했으며, 모델 이름은 동일한 gpt-6-astra, Codex 설정도 동일하게 유지함.
- 일반 계정의 gpt-6-astra 결과, 영향을 받은 계정의 gpt-6-astra 결과, 명시적으로 요청한 gpt-5.6-luna 결과, 일반 계정에서 명시적으로 요청한 gpt-6-astra 결과를 비교함.
- 결과 중 약 절반은 완성도 높은 그림이었고 나머지는 거친 만화풍 새 그림이었으며, 이미지 분류기는 대부분을 오리나 갈매기로 판정함.
- 어떤 결과를 받는지는 ChatGPT 계정과 연관됐으며, 프롬프트·설정·클라이언트 버전·시간대는 차이를 설명하지 못함.
- 영향을 받은 계정은 응답 속도가 다르고 출력이 더 짧으며, 글쓰기와 그림 양식이 gpt-5.6-luna와 비슷함. 서버 응답의 모델 표시는 여전히 gpt-6-astra임.
- 조사 데이터에서 차이는 2026년 9월 20일 09:00 UTC경 갑자기 시작됨.
- 서버 측을 볼 수 없으므로 원인이나 실제 제공 모델을 단정할 수 없음.
조사 결과
- 9월 20일의 변화 — 강한 근거: 그 전에는 영향을 받은 계정이 없었고, 이후 사용된 계정 중 절반 이상이 영향을 받음(Fisher p = 2·10⁻¹²).
- 계정별이며 대체로 지속됨 — 강한 근거: 계정의 첫 절반 데이터가 후반을 예측함(ρ = 0.79). 같은 시간대에도 계정별 결과가 다를 수 있음.
- 실제 작업에도 영향 — 강한 근거: 계정별 응답 출력량이 약 25% 감소(p = 3·10⁻⁵)했고, 사용자가 응답을 중단하는 빈도가 약 20배 증가(p = 0.009)함.
- 요청에 따라 재현 가능 — 유의미한 근거: 기기 설정·프롬프트·설정은 그대로 두고 계정만 바꾼 시험에서 한 계정은 매번 정상 결과, 다른 계정은 대부분 이상 결과를 냄. 계정은 각 한 개씩 사용함.
- 출력이 gpt-6-astra와 다름 — 강한 근거: 12개 질문으로 구성한 텍스트 벤치마크에서 영향을 받은 계정의 답변은 12개 모두 gpt-6-astra와 덜 유사함(Wilcoxon p = 0.0005).
- gpt-5.6-luna일 가능성 — 시사적 근거: 그림 양식·문장 표현·속도가 가장 가까운 모델임. 미리보기 이후 luna 비교를 선택했으며(p = 0.016), 식별은 확정이 아닌 통계적 추정임.
- 정상 gpt-6-astra 제공 속도는 초당 약 34토큰에서 최고치를 보임. 9월 20일 전 2주 동안 이를 넘는 경우는 사실상 없었지만 이후에는 매일 그런 계정이 일부 존재함.
- 반복 검사에서 정상 계정의 응답 스트리밍 속도는 매우 일정함. 영향을 받은 계정은 간헐적인 양상을 보이며, 3회 실행 중 한 번은 정상처럼 보이기도 함.
확인할 수 없는 사항
- 원인: 데이터는 계정별 실험이나 라우팅 집단, 계정 수준 정책, 용량에 따른 라우팅과 모두 부합함. 클라이언트 측 데이터만으로는 구별할 수 없음.
- 정확한 모델: 속도·그림 양식·문장 표현에 기반한 통계적 식별이며, 실제 모델을 확정할 수 없음.
- 일반 사용자에 대한 영향: 데이터는 많은 ChatGPT Pro 계정을 차례로 사용한 한 팀의 일일 집중 사용에서 나옴. 일반적인 단일 계정 사용자가 영향을 받는지는 알 수 없음. 이것이 검사 스크립트를 공유하는 주된 이유임.
계정 확인 방법
is_my_astra_fake.py스크립트를 내려받아python3 is_my_astra_fake.py로 실행함.- Codex CLI에 로그인돼 있어야 하며 Python 3.8 이상이 필요함. 표준 라이브러리만 사용함.
- 스크립트는 Codex를 통해 짧은 gpt-6-astra 요청을 3~9회 보내므로 소량의 사용량 한도를 소비함.
- Codex의 로컬 세션 로그에서 타이밍을 읽어 응답 스트리밍 속도를 실제 gpt-6-astra의 속도와 비교함. 느린 네트워크 연결은 측정에 영향을 주지 않음.
- 데이터를 다른 곳으로 전송하지 않음. 계정 정보는 로컬 로그인 파일에서 가져오며 터미널에만 출력함.
- 예시 실행에서는 계정 유형과 함께 최대 3회차의 병렬 gpt-6-astra 실행을 안내하며, 소요 시간은 1~4분임. 각 실행의 토큰/초, 정상 기준 범위, 추론 토큰 수, 이상 여부를 출력함.
- YES(종료 코드 1): 한 회차의 3회 실행 중 최소 2회에서 실제 gpt-6-astra보다 명확히 빠르거나 느린 스트리밍이 측정됨.
- NO(종료 코드 0): 3회차가 모두 정상으로 보임. 영향을 받은 계정도 간헐적일 수 있으므로 가능성만 낮출 뿐 확증은 아니며, 이상이 느껴지면 나중에 다시 실행할 수 있음.
- UNKNOWN(종료 코드 2): Codex 실행이 실패했거나 명확한 측정 결과가 너무 적음.
- 결과를 공유할 경우 YES/NO, 날짜, 단일 계정 사용 여부면 충분하며 이메일 주소나 세션 로그는 공유하지 말 것을 요청함.
방법 세부 사항
- 펠리컨: 기성 이미지 모델인 CLIP으로 그림을 평가함. 점수는 ‘펠리컨인가’와 ‘좋은 삽화인가’를 곱해 산출했으며, 점수는 뚜렷한 간격을 두고 두 집단으로 나뉨.
- 속도: 기록 분석에서는 긴 응답별 초당 토큰 수를 응답 길이에 따른 예상 속도와 비교함. 검사 스크립트는 추론이 끝난 뒤 답변 텍스트가 스트리밍되는 시간만 측정하므로 네트워크 지연·대기열·시작 지연은 포함하지 않음.
- 실제 gpt-6-astra는 모든 실행에서 초당 32.5~33.8토큰으로 스트리밍됨. 이상 속도는 초당 30.5~36.5토큰 범위를 벗어나는 경우로 정의함.
- 계정 분류: 긴 응답 중 이상 속도가 30% 이상인 계정을 영향을 받은 계정으로 분류함. 계정은 어느 한쪽 집단에 뚜렷하게 속함.
- 배제한 요인: 추론 강도, 사용량 한도, 계정을 처음 사용한 뒤 경과 시간, Codex 버전과 설정, 프롬프트, 문맥임.
- 비교 실행: 사용 가능한 각 모델을 명시적으로 요청해 같은 프롬프트를 실행하고, 그림 양식·문장 표현·12개 질문 텍스트 벤치마크를 비교함.
- 주의 사항: 실제 동시 비교 시험에서는 영향을 받은 계정은 컨테이너에서, 정상 계정은 호스트에서 실행함.
댓글 (0)
로그인하면 이 기사에 내 생각을 남길 수 있어요