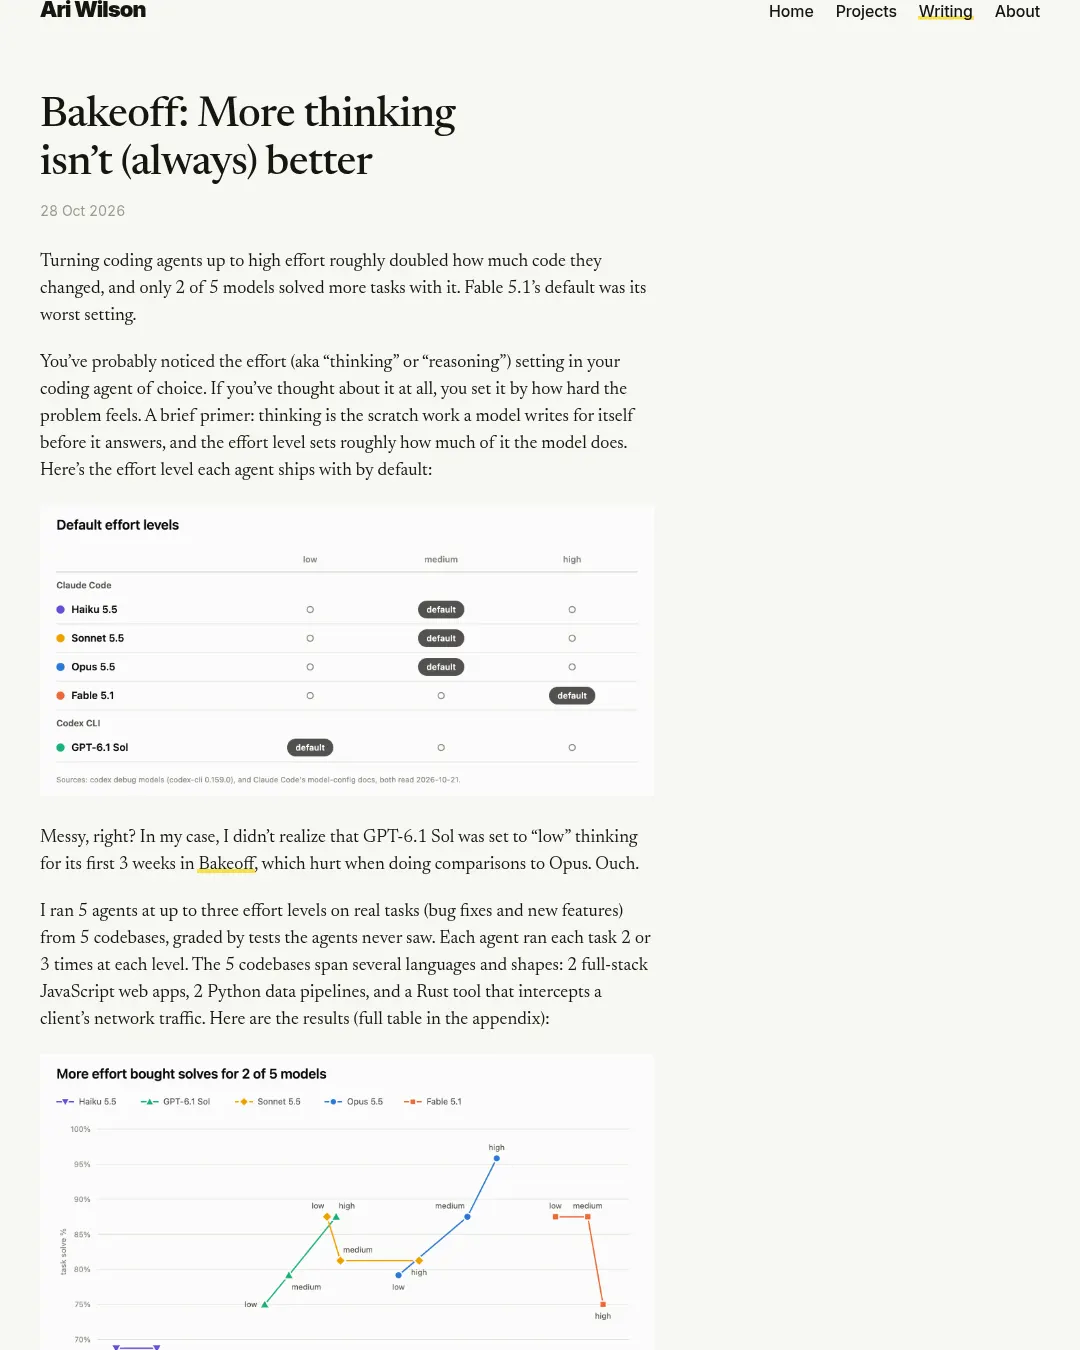
코딩 에이전트의 추론 강도를 높이면 수정하는 코드가 늘지만, 5개 모델 가운데 더 많은 작업을 해결한 모델은 2개뿐이었다. 5개 코드베이스의 버그 수정·기능 추가 과제를 시험한 결과로, Fable 5.1은 기본 설정인 높음보다 낮음에서 더 많은 작업을 해결했다.
실험에서는 5개 에이전트를 최대 세 가지 추론 강도로 실행하고, 에이전트가 보지 못한 테스트로 결과를 평가했다. 각 에이전트는 강도별로 과제를 2~3회 수행했다. 대상 코드베이스는 자바스크립트 풀스택 웹 앱 2개, 파이썬 데이터 파이프라인 2개, 클라이언트 네트워크 트래픽을 가로채는 러스트 도구 1개였다.
Opus 5.5와 GPT-6.1 Sol은 강도를 높일수록 결과가 나아졌다. Opus 5.5는 가장 어려운 버그를 높음에서 세 번 모두 해결했지만, 중간에서는 3회 중 1회, 최대에서는 0회 해결했다. 다른 모델은 모두 해결하지 못했다. GPT-6.1 Sol은 낮음에서 매번 놓친 다중 사용자 기능을 높음에서 구현했다. 반면 Sonnet 5.5와 Fable 5.1은 높음에서 낮음보다 적은 과제를 해결했고, Haiku 5.5는 중간에서 높음으로 올려도 결과가 같았다.
Claude Code의 모델별 기본 설정을 비교하면 Opus 5.5의 중간 설정은 성공률 88%, 실행당 1.07달러, 중앙값 3분 10초였다. Fable 5.1의 높음 설정은 성공률 75%, 실행당 3.56달러, 중앙값 6분 28초였다. 실험 결과는 8개 과제의 평균 성공률과 비용, 과제별 중앙값 시간으로 집계됐다.
| 모델 | 실행 횟수(강도별) | 낮음 | 중간 | 높음 |
|---|---|---|---|---|
| Haiku 5.5 | 21 | 해당 없음 | 69% · 2분 49초 · 0.047달러 | 69% · 3분 45초 · 0.068달러 |
| GPT-6.1 Sol | 21 | 75% · 2분 38초 · 0.18달러 | 79% · 3분 58초 · 0.22달러 | 88% · 5분 44초 · 0.33달러 |
| Sonnet 5.5 | 21 | 88% · 1분 33초 · 0.31달러 | 81% · 1분 29초 · 0.35달러 | 81% · 2분 50초 · 0.70달러 |
| Opus 5.5 | 21 | 79% · 1분 49초 · 0.58달러 | 88% · 3분 10초 · 1.07달러 | 96% · 4분 18초 · 1.39달러 |
| Fable 5.1 | 16 | 88% · 4분 7초 · 2.33달러 | 88% · 5분 45초 · 3.11달러 | 75% · 6분 28초 · 3.56달러 |
추론 강도를 높이면 검토해야 할 코드도 길어졌다. 작동하는 해법을 낸 실행의 평균 diff는 낮음에서 126줄, 높음에서 281줄로 2.2배가 됐다. 엔지니어가 시간당 300줄을 검토하고 에이전트가 만든 PR 10개를 매주 살핀다고 가정하면, 늘어난 코드 검토에만 주당 5시간이 더 든다는 계산이다.
가장 어려운 버그에서 Opus 5.5를 최대 강도로 세 번 더 실행한 추가 실험에서는 높음보다 결과가 나빴다. 최대 강도 실행의 수정량 중앙값은 664줄로, 높음의 140줄보다 많았다. Claude Code 문서도 최대 강도에서 지나친 고민이 생길 수 있다고 경고한다. Anthropic의 추론 강도 설명은 잘못된 접근을 고른 모델을 추론 강도를 높이는 것만으로는 구제할 수 없다고 설명한다. 실험에서는 Fable 5.1이 가장 어려운 버그의 원인을 매번 놓쳤다.
실험 자료는 작업 종류와 코드베이스가 다르면 결과도 달라질 수 있다고 밝힌다. 팀에 적용할 설정으로는 모델별 기본값을 따로 두고 최대 강도를 기본으로 삼지 않는 방안을 제안한다. Fable 5.1은 사용한다면 낮음, Sonnet 5.5는 낮음, Opus 5.5와 GPT-6.1 Sol은 일상적인 작업에는 낮음, 어려운 작업에는 높음을 권한다. Sonnet 5.5는 낮음에서 성공률 88%, 실행당 0.31달러를 기록했다. 두 도구 모두 조직 전체의 기본값을 설정할 수 있다.
실험 및 비교 도구는 Bakeoff에서 확인할 수 있다.
댓글 (0)
로그인하면 이 기사에 내 생각을 남길 수 있어요