TL;DR
- Cognition의 에이전트 코딩 모델 SWE-2가 2.8T 총 매개변수, 토큰당 104B 활성 매개변수 규모에서 강화학습을 확장해 Terminal-Bench 2.1 92.8점을 기록함.
- Kimi K3 기반 모델에 Cognition의 추가 사후 학습을 적용했으며, 대부분의 벤치마크에서 5~6점을 추가로 끌어올림.
- 중간 노력 수준에서 SWE-1.7보다 58% 적은 턴, 81% 낮은 평균 비용으로 더 높은 FrontierCode 점수를 기록함.
- FrontierCode 1.1 Main 50.0은 Claude Fable 5.1보다 1점 낮고 GPT-6 Astra보다 3.3점 낮지만, 각각보다 64% 낮은 비용과 4분의 1 수준의 비용을 주장함.
- 가중치는 공개되지 않았고 로컬 실행은 불가능하며, 현재 Devin Desktop·CLI에서 제공되고 Devin Web·Fusion으로 확대 중임.
모델 개요
- SWE-2는 Cognition이 개발한 에이전트 코딩 모델이며, 2.8T 총 매개변수와 토큰당 104B 활성 매개변수를 사용하는 혼합 전문가(Mixture of Experts, MoE) 구조임.
- Kimi K3 기반 모델 위에 Cognition의 사후 학습(post-training)을 적용한 구성임.
- Cognition이 강화학습(Reinforcement Learning, RL)을 수조 개 매개변수 규모로 확장한 첫 사례임.
- 기반 모델은 이미 에이전트 코딩을 위해 강화학습 비중이 높은 상태였으며, Cognition의 추가 학습으로 대부분의 벤치마크에서 5~6점이 더해짐.
서빙 스택
NVFP4및FP8커널을 사용하는 MoE 추론과 양자화 인식 학습(quantization-aware training)으로 구성됨.- MLA 레이어에서 키(K), 쿼리(Q), 밸류(V) 및 스코어 계산에 FP8이 적용됨.
SpecForge로 재학습한 초안 모델(draft model)이 수용 길이(accept length)를 15% 늘림.- 프리필 지연기(prefill delayer)가 GPU당 초당 토큰 수(TPM)와 요청당 초당 토큰 수를 10~20% 높이지만, 첫 토큰까지 시간(TTFT)은 증가함.
노력 수준과 실행 효율
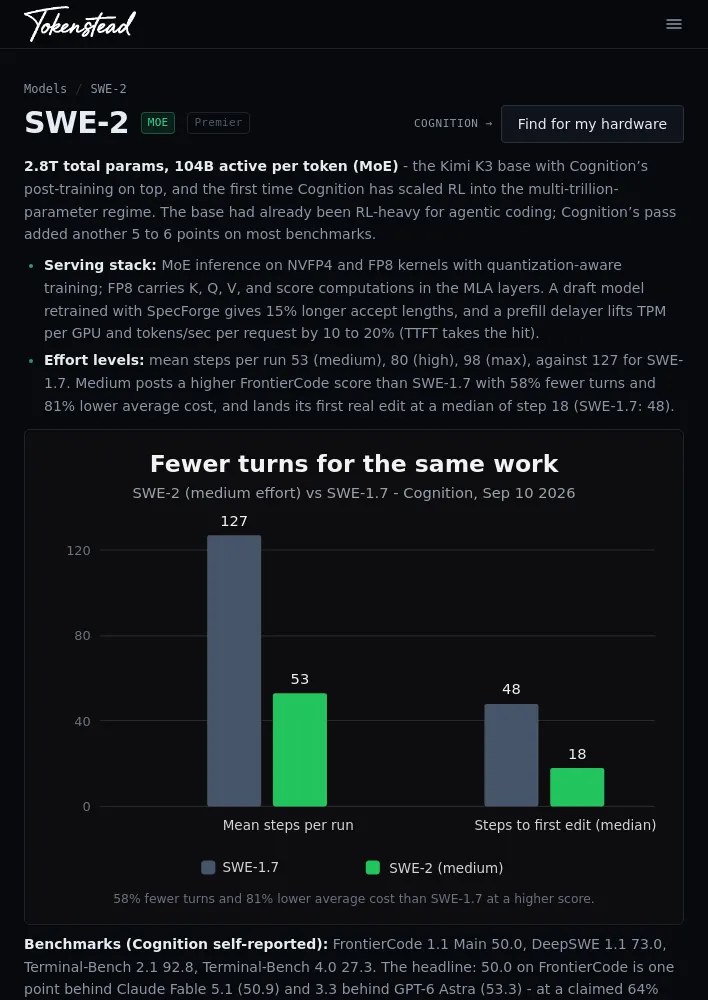
- 실행당 평균 단계 수는 중간 수준 53단계, 높음 수준 80단계, 최대 수준 98단계이며, SWE-1.7은 127단계임.
- 중간 수준은 SWE-1.7보다 높은 FrontierCode 점수를 기록하면서 58% 적은 턴과 81% 낮은 평균 비용을 보임.
- 첫 번째 실제 편집은 중간값 기준 18단계에서 발생하며, SWE-1.7은 48단계임.
벤치마크 결과
- 아래 수치는 Cognition이 자체 보고한 결과임.
- FrontierCode 1.1 Main: 50.0
- DeepSWE 1.1: 73.0
- Terminal-Bench 2.1: 92.8
- Terminal-Bench 4.0: 27.3
- FrontierCode 1.1 Main의 50.0점은 Claude Fable 5.1의 50.9점보다 1점 낮고, GPT-6 Astra의 53.3점보다 3.3점 낮음.
- Cognition은 해당 성능 수준에서 Fable 5.1보다 64% 낮은 비용, Astra의 4분의 1 비용을 주장함.
- Terminal-Bench 2.1의 92.8점은 공개된 표에서 가장 높은 수치임.
- 약점은 Terminal-Bench 4.0으로, SWE-2의 27.3점은 Fable 5.1의 55.8점과 GPT-6 Astra의 57.9점에 크게 못 미침.
- 장기 지평 에이전트 작업에서 최첨단 모델과의 격차가 여전히 남아 있음.
제공 방식과 비용
- 가중치는 독점 상태이며 공개되지 않아 다운로드할 파일이나 양자화 단계(quantization ladder)가 없음.
- 현재 Devin Desktop과 CLI에서 제공되며, Devin Web과 Fusion으로 배포가 확대되는 중임.
- Cognition은 SWE-2의 토큰당 API 가격을 공개하지 않음.
- 따라서 FrontierCode에서 동등한 성능을 기준으로 Fable 5.1보다 64% 저렴하다는 비용 비교가 가격 정보의 핵심이며, 100만 토큰당 달러 가격표는 제공되지 않음.
- 이 문서의 모든 수치는 Cognition 자체 수치이며, 독립적인 재현을 기다리는 상태임.
모델 메타데이터
- 유형: 코딩 및 에이전트형(agentic) 모델
- 매개변수: 2800.0B
- 라이선스: 독점 라이선스
- 개발사: Cognition
- 기원: 🇺🇸 미국
- 출시: Sep 2026
SWE-2로 구축하는 사례
- X에 게시된 실제 데모가 제공됨.
- 출시 게시물의 핵심 수치는 Kimi K3 사후 학습, FrontierCode 1.1 Main 50.0, Terminal-Bench 2.1 92.8임.
벤치마크 점수
- 개발사의 모델 카드 또는 기술 보고서에 기반한 공급자 보고 수치임.
- DeepSWE: 73.0
- FrontierCode 1.1 Main: 50.0
- Terminal-Bench 2.1: 92.8
- Terminal-Bench 4.0: 27.3
클라우드 실행과 가격 이력
- SWE-2에 대해 추적되는 토큰당 API 제공업체 가격이 아직 없음.
- 대표 모델의 정가 목록은 별도 계산기에서 확인하는 방식임.
- 추론 비용 데이터는 최초 일일 동기화 시점부터 누적되며, 시간이 지나면서 더 긴 기간이 채워짐.
- 가격은 과거 API가 아니라 OpenRouter 스냅샷에서 수집됨.
- 가격 이력은 현재 로딩 중인 상태임.
댓글 (0)
로그인하면 이 기사에 내 생각을 남길 수 있어요