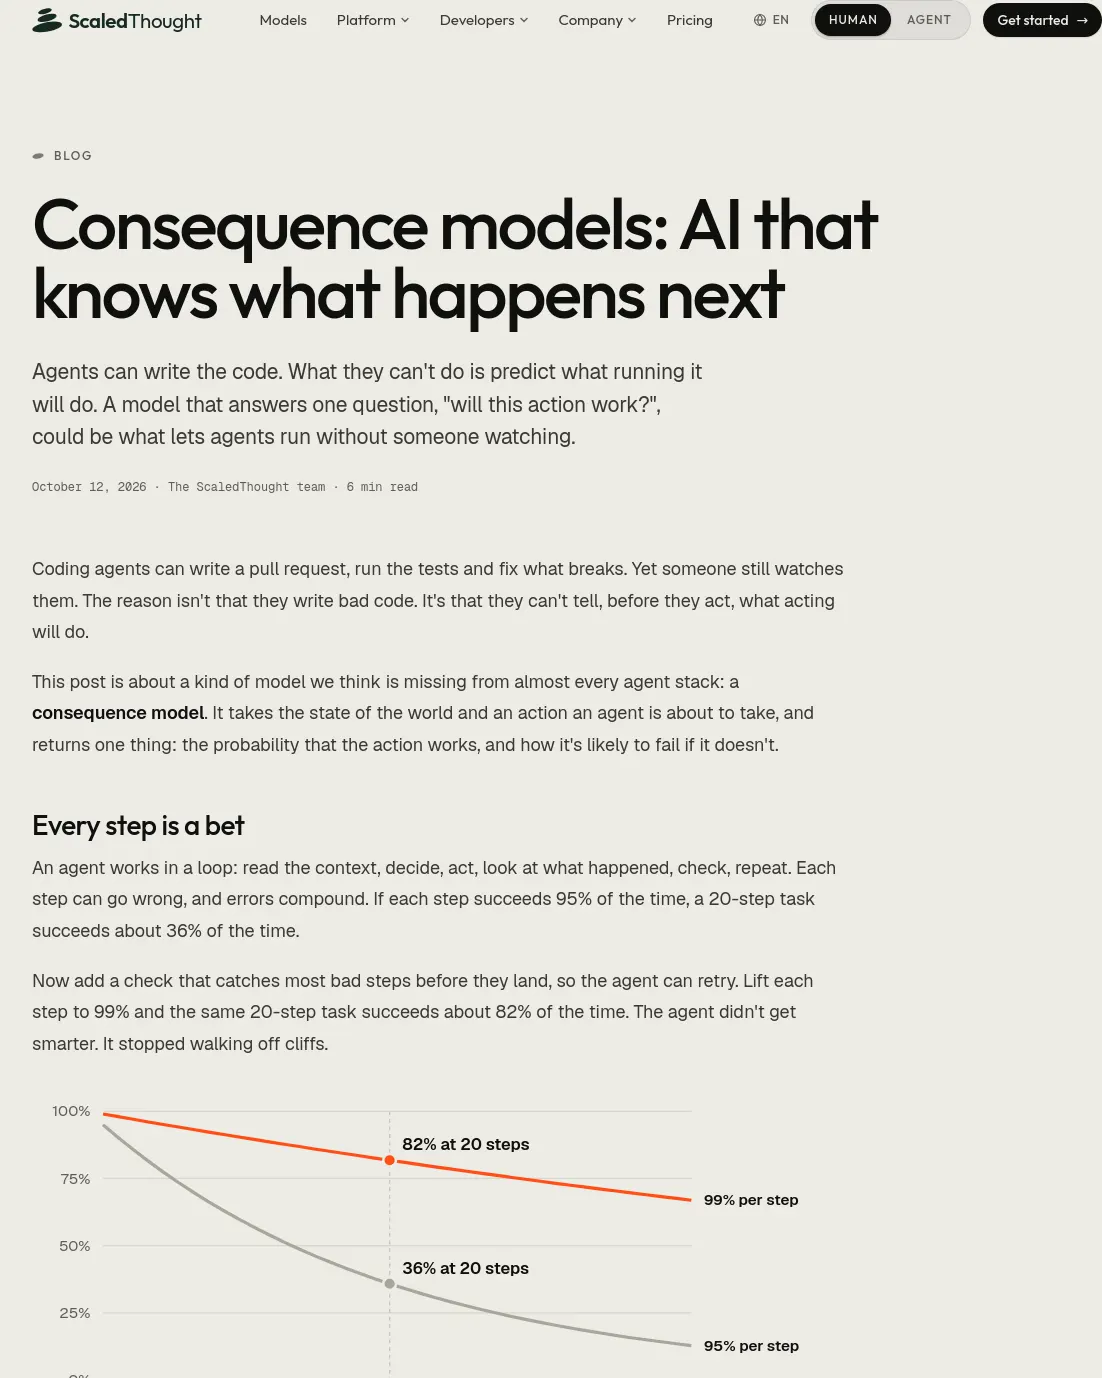
한 단계가 95% 확률로 성공해도 20단계 작업 전체가 성공할 확률은 약 36%다. 단계마다 실패를 미리 잡아 성공률을 99%로 높이면 전체 성공률은 약 82%가 된다. 이는 벤치마크 결과가 아니라 단순 계산이다.
ScaledThought 팀은 에이전트가 행동에 나서기 전에 그 결과를 예측하는 ‘결과 예측 모델(consequence model)’이 필요하다고 주장한다. 에이전트가 작업을 잘 수행하는지 사람이 계속 지켜보는 대신, 위험한 단계만 사람에게 넘기는 데 쓸 수 있다는 구상이다.
결과 예측 모델은 무엇을 내놓나?
결과 예측 모델은 에이전트가 처한 상황과 하려는 행동을 입력받아, 그 행동이 성공할 확률과 실패할 경우의 짧은 설명을 내놓는 모델이다. 뜨거운 난로에 손을 댄 사람을 많이 본 친구가 손을 뻗기 전에 얼마나, 어떻게 데일지 알려주는 상황을 떠올리면 쉽다. 모델은 실제로는 행동과 맥락을 받아 보정된 확률과 실패 유형을 반환한다.
예를 들어 저장소의 기본 브랜치에서 git push --force를 하려는 상황을 입력하면, 성공 가능성과 실패 방식으로 동료의 커밋을 덮어쓸 위험을 제시할 수 있다. 이 예시에서 제시한 결과는 성공 확률 7%와 동료의 커밋을 덮어쓸 수 있다는 설명이다.
이 모델이 쓸모 있으려면 세 가지 특성이 필요하다. 첫째, 읽기만 하고 쓰지 않는다. 긴 설명문 대신 확률과 짧은 꼬리표를 반환하므로 각 단계에서 호출해도 빠르고 저렴해야 한다. 둘째, 확률이 보정돼야 한다. 80%라고 예측한 행동이 실제로도 대략 80% 성공해야 프로그램이 기준을 정할 수 있다. 글은 0.9 초과면 실행하고, 0.5~0.9면 사람에게 묻고, 0.5 미만이면 차단하는 예를 든다. 셋째, 설명이 아니라 실제 결과를 바탕으로 학습해야 한다.
왜 더 큰 언어 모델로 해결되지 않나?
언어 모델은 사람들이 세상에 대해 쓴 글을 학습한다. 이는 사람들이 어떤 일이 일어난다고 말하는 기록이지, 특정 행동을 했을 때 실제로 무슨 일이 벌어지는지에 대한 기록은 아니다.
인과 추론의 사다리는 관찰한 것과 개입했을 때 일어나는 일을 구분한다. 인과 계층 정리는 관찰 데이터만으로는 개입의 결과를 정할 수 없는 경우가 거의 항상 있음을 보인다. 글은 개입에 대한 간접적인 설명을 제공하므로 이는 절대적인 한계는 아니지만 구조적인 제약이다. 그래서 언어 모델에 “이 행동이 성공할까?”라고 물으면 실제 결과보다 그럴듯한 행동인지에 대한 답을 얻기 쉽다.
확신도에도 문제가 있다. 모델이 밝히는 확률을 믿기 어렵기 때문이다. 오픈AI의 GPT-4 기술 보고서는 사전 학습 모델의 확률은 잘 보정됐지만, 후속 학습 모델의 확률은 훨씬 덜 보정됐다고 보고했다. 에이전트는 신뢰할 수 없는 숫자를 기준으로 행동을 나눌 수 없다.
에이전트가 만드는 결과는 어떻게 학습 자료가 되나?
새로운 학습 신호를 저렴하게 얻을 수 있게 되면 새로운 종류의 모델이 등장하곤 한다. 이미지 모델은 라벨이 붙은 사진 수백만 장을, 언어 모델은 웹 자료를, 대화 모델은 사람의 선호 평가를 학습했다. 추론 모델은 수학과 코드처럼 자동으로 정답을 확인할 수 있는 결과를 학습 자료로 삼았다.
에이전트는 또 다른 학습 자료를 만든다. 테스트 실행, 지속적 통합 작업, 셸 명령, API 호출, 다시 열린 고객 지원 티켓은 모두 결과가 기록된 행동이다. 별도로 라벨을 붙이지 않아도 결과 자체가 라벨이 된다. 실패한 테스트를 다시 실행하면 테스트가 불안정했는지 알 수 있고, 패치를 병합하면 지속적 통합이 통과했는지 알 수 있다.
ScaledThought가 그리는 흐름은 다음과 같다.
- 제안: 에이전트가 다음 행동을 고른다.
- 예측: 결과 예측 모델이 성공 확률과 예상 실패를 반환한다.
- 통제: 0.9 초과면 실행하고, 0.5~0.9면 사람에게 묻고, 0.5 미만이면 차단한다.
- 학습: 실제로 일어난 일이 다음 학습 사례가 된다.
이 기준값은 예시이며, 각 팀이 자체 기준을 정한다.
어디에 먼저 쓸 수 있나?
사람이 모든 단계를 지켜보는 대신, 에이전트가 자신 없는 몇 단계에서만 멈추면 한 사람이 여러 에이전트의 예외 상황을 처리할 수 있다. 위험한 단계는 사람을 기다리고 나머지는 계속 진행하므로 야간 작업도 가능해진다는 구상이다.
작업 결과에 따라 요금을 받는 방식도 가능해질 수 있다. 인터컴은 지원 에이전트 Fin의 가격을 결과당 0.99달러로 책정했다(가격 페이지, 2026년 10월 11일 확인). 게시물은 공급자가 어떤 일을 완료할지 예측할 수 있어야 이런 위험을 감당할 수 있다고 설명한다. 결과 예측 모델이 있으면 병합될 가능성이 높은 풀 리퀘스트당 가격을 제시하는 등 다른 작업에도 결과 기반 요금을 적용할 수 있다는 주장이다.
검색을 통해 행동 계획을 고르는 방법도 제시한다. 게임 시스템 MuZero는 자체적으로 학습한 게임 모델 안에서 여러 수를 탐색하며 계획을 세운다. 결과 예측 모델이 있으면 에이전트도 배포, 데이터베이스 이전, 코드 리팩터링에서 여러 계획을 비교한 뒤 성공 가능성이 가장 높은 것을 실행할 수 있다는 구상이다.
환불, 설정 변경, 배포, 데이터베이스 변경은 에이전트가 유용하게 쓰일 수 있지만 신뢰를 얻기 어려운 작업이다. 각 행동에 대해 보정된 진행 여부 판단을 제공하면 사람이 모든 단계를 승인하지 않고 위험이 큰 작업만 검토할 수 있다.
더 좁은 용도도 있다. 코딩 에이전트의 변경으로 테스트가 실패했는지, 불안정한 테스트 탓인지 판단할 수 있다. 지금은 여러 분 걸리는 테스트 실행을 다시 하거나, 건드리지 않은 테스트를 고치는 일이 생길 수 있다. 재실행 결과가 답을 학습할 자료가 된다. 에이전트가 만든 후보 패치 다섯 개 중 통과 가능성이 높은 하나에만 전체 테스트를 실행하고, 실패할 가능성이 큰 부분부터 시험할 수도 있다. AI가 작성한 고객 지원 답변을 보낸 뒤 고객이 다시 문의하거나 문제를 상급 담당자에게 넘길지 예측해, 확신이 높은 답변은 자동 발송하고 나머지는 사람에게 맡기는 방식도 가능하다. 요청이 얼마나 어려워 보이는지 추측하는 대신, 예상 성공 건당 비용이 가장 낮은 모델로 요청을 보내는 방법도 있다.
이미 나온 연구와 도구는 어디까지인가?
게시물은 관련 연구와 오픈소스 프로젝트로 네 가지를 든다. Qwen-AgentWorld는 도구 호출, 터미널, 웹 페이지, 운영체제를 모의 실행하는 언어 세계 모델이며, 특정 크기의 모델 가중치를 공개했다. WebDreamer는 에이전트가 웹에서 행동하기 전에 각 행동의 결과를 모델이 상상하게 한다. R2E-Gym은 테스트 실행 여부에 따라 코딩 에이전트의 패치를 평가하는 검증기를 학습하며, 두 방식을 함께 쓰는 것이 가장 효과적이라고 보고한다. SWE-RM은 테스트를 실행하지 않고 패치를 평가하는 검증기를 연구하며, 정확도만큼 확률 보정도 중요하다고 주장한다.
ScaledThought는 아직 찾지 못한 부분이 있다고 말한다. 실제 결과를 바탕으로 학습하고, 확률을 보정하며, 매 단계 호출할 만큼 저렴한 소형 모델을 API로 제공하는 구성 요소다.
도입하려면 무엇을 확인해야 하나?
결과는 특정 시스템에 좌우될 수 있다. 다른 사람의 저장소에서 학습한 모델은 해당 팀의 저장소를 잘 모를 수 있다. 환경을 입력에 반영하고 팀별로 적응시키는 일도 별도의 연구 과제다.
확률 보정은 벤치마크에서만이 아니라 실제 작업에서도 유지돼야 한다. 자신 있게 틀리는 모델은 사람이 확인을 멈출 수 있어, 모델이 없는 것보다 위험하다. 의사결정 모델이 잘못된 단서에 매달릴 가능성도 있다. 최근 연구는 선택지를 제한한 의사결정 모델이 평가 기준 대신 선택지 이름을 따르는 사례를 발견했다. 결과 예측 모델도 같은 방식으로 면밀히 살펴야 한다.
ScaledThought는 에이전트 추론을 제공하는 회사다. 이 회사는 앞으로 유용한 모델 가운데 상당수가 더 큰 언어 모델이 아니라, 결정하거나 출처를 찾거나 수치를 추정하거나 결과를 예측하는 작은 전문 모델일 것이라고 본다. 결과 예측 모델이 중요하다는 것도 회사의 견해다. 이런 모델이 에이전트를 사람이 조작하는 도구에서 맡겨 둘 수 있는 작업자로 바꿀 수 있다는 주장이다.
ScaledThought는 프롬프트와 완성 내용을 저장하지 않으며, 이 글은 고객 트래픽으로 모델을 학습했다는 뜻이 아니라고 덧붙였다. 이런 모델은 에이전트를 운영하는 사람들이 공유하기로 선택한 결과를 바탕으로 학습할 수 있다는 설명이다. 실제 작업에서의 보정 성능, 팀별 적응 방식, API 제공 여부와 비용은 원문에 구체적으로 제시되지 않았다.
댓글 (0)
로그인하면 이 기사에 내 생각을 남길 수 있어요