TL;DR
- 데이터 웨어하우스가 빅데이터 시대의 기대를 충족하지 못했지만, 대형 언어 모델(LLM)의 코드 생성과 긴 컨텍스트 처리 능력으로 컨텍스트 기반 모니터링이 장애 조사와 근본 원인 분석에 실질적인 도움이 됨.
- Databricks와 Snowflake는 빅데이터 열풍이 한창이던 2012~2013년에 설립됐으며, 당시 기업 데이터가 데이터 사일로에 갇힌 막대한 미활용 가치라는 관점이 널리 퍼져 있었음.
- 프런티어 모델은 최대 100만 토큰, 약 75만 단어의 컨텍스트 창을 처리하며, 일회성 SQL 쿼리에 필요한 코드를 작성하고 맥락을 다루는 데 강점을 보임.
- 데이터를 원격 저장소에 중앙화하면 접근 권한 문제를 줄이고 운영 환경 자체가 아닌 운영 환경의 기록을 조회할 수 있으며, 과거 값과 현재 값을 비교할 수 있음.
- 컨텍스트 기반 모니터링은 알림마다 조사할 가치가 있는지를 넘어, 모든 알림을 조사할 수 있도록 데이터와 맥락을 갖추는 접근임.
컨텍스트 기반 모니터링
- Databricks(2013년)와 Snowflake(2012년)는 빅데이터 열풍이 한창이던 비슷한 시기에 설립됨.
- 당시 널리 퍼진 관점은 기업 운영에서 생성되는 데이터가 막대한 미활용 가치의 원천이지만, 다양한 사일로와 형식에 흩어져 있다는 것이었음.
- 데이터 웨어하우스는 데이터를 하나의 저장소로 모으고, 데이터 과학자는 머신러닝(ML)을 결합해 강력한 통찰을 찾아낼 것으로 기대됐음. 그러나 대다수 기업에서는 기대한 성과가 실현되지 않음.
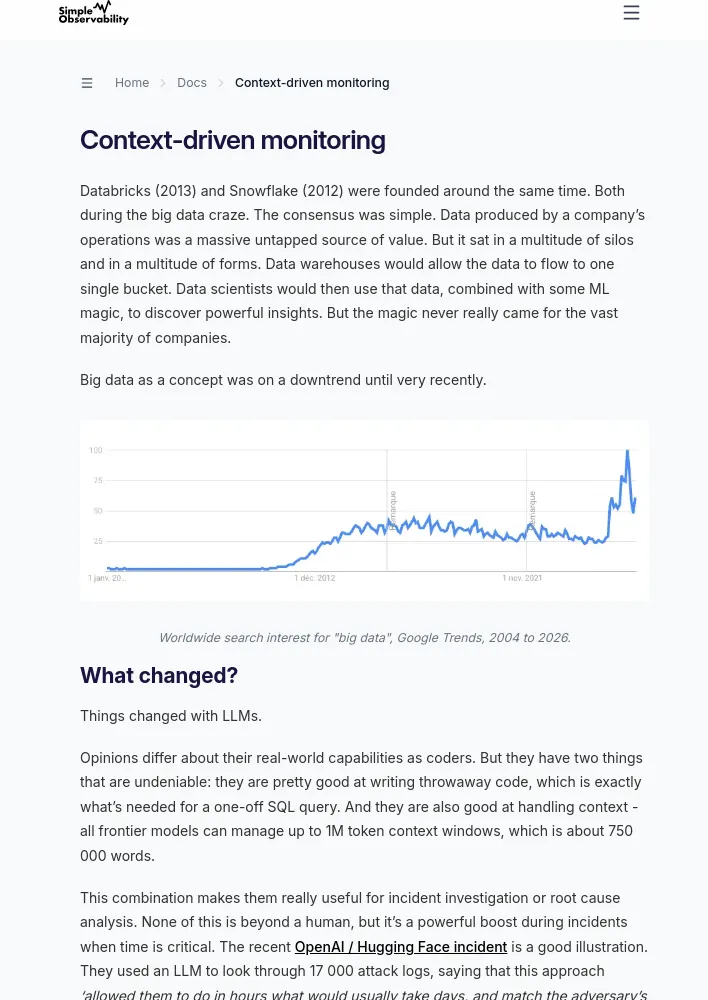
- 빅데이터라는 개념에 대한 관심은 아주 최근까지 하락세였음.
- Google Trends의 2004~2026년 전 세계 검색 관심도 그래프에서 ‘빅데이터’ 검색 추이를 확인할 수 있음.
무엇이 바뀌었나?
- 대형 언어 모델(LLM)의 등장으로 상황이 바뀜.
- 코딩 능력의 실제 수준에 대해서는 의견이 갈리지만, LLM에는 두 가지 분명한 강점이 있음.
- 일회성 SQL 쿼리에 필요한 임시 코드를 꽤 잘 작성함.
- 맥락을 잘 다루며, 모든 프런티어 모델이 최대 100만 토큰, 약 75만 단어의 컨텍스트 창을 처리할 수 있음.
- 이 두 가지 능력의 결합은 장애 조사나 근본 원인 분석에 유용함. 사람도 할 수 있는 일이지만, 시간이 중요한 장애 상황에서 강력한 지원이 됨.
- 최근 OpenAI와 Hugging Face의 사고가 사례임. 두 조직은 LLM으로 공격 로그 1만 7,000건을 살펴봤으며, 이 접근 방식으로 “보통 며칠 걸릴 일을 몇 시간 만에 처리하고 공격자의 속도에 맞출 수 있었다”고 밝힘.
- 모니터링은 더 이상 “서비스를 계속 가동하려면 어떤 핵심 알림이 필요한가?”만의 문제가 아님. “사람과 LLM이 인프라를 쉽게 조회할 수 있게 하려면 어떻게 해야 하는가?”, 즉 LLM 용어를 빌리면 “인프라의 컨텍스트를 어디에 저장할 것인가?”도 함께 고려해야 함.
컨텍스트는 어디에 저장할까?
- 장애가 발생했을 때 팀원이나 LLM이 직접 데이터를 가져오게 하면 된다고 생각할 수 있음. 서버에 SSH로 접속하고,
journalctl로 로그를 찾거나, NGINX 로그 파일을 실시간으로 확인하는 방식임. - 하지만 이 방식은 빠르게 한계에 부딪힘. 전용 사용자나 인증 정보를 통해 접근 권한을 마련해야 하며, LLM에 프로덕션 서버 전체 접근 권한을 넘기게 됨. 게다가 기록하지 않은 과거 메트릭은 영원히 사라져 맥락이 부족해짐.
- 모든 서버의 데이터를 수집하는 원격 저장소에 컨텍스트를 중앙화하면, 하나의 조회 가능한 인터페이스로 접근 문제를 해결할 수 있음.
- 이 방식에서는 LLM이 프로덕션 환경 자체가 아니라 프로덕션 환경의 기록에만 접근함. 검색 범위가 제한돼 LLM이 쓸모없는 영역으로 벗어나지 않으며, 과거 기록을 통해 현재 값을 과거 평균과 비교할 수 있음.
- 중앙 저장소는 조사자가 데이터에 어떻게 접근하는지에는 답하지만, 접근할 수 있는 데이터가 무엇인지는 별개의 문제이며 더 중요함.
컨텍스트가 중요한 이유
- 간단한 사례로 시간별 또는 일별 데이터베이스(DB) 복원 테스트를 가정할 수 있음.
- 일반적으로 모니터링을 설정하면 테스트 실패 시 알림을 받음. 이는 유용하지만 실패 원인은 알려주지 않음.
- 복원 가상 머신(VM)의 디스크 공간이 부족했거나 네트워크가 잠시 끊긴 경우라면 치명적이지 않을 수 있음.
- 반면 DB에서 손상 오류가 발생했다면 상황은 치명적임.
- 따라서 간단한 크론 작업이라도 작업 자체와 호스트 머신에 관한 컨텍스트를 갖추면 큰 개선이 됨.
- NGINX 서버 뒤에서 웹사이트를 운영하는 경우, 분산 서비스 거부(DDoS) 공격이나 대규모 스크래핑을 감지하기 위해 요청률 메트릭을 관찰하고 알림을 설정할 수 있음. 알림이 발생하면 무언가 일어나고 있다는 점은 알 수 있지만, 그것만으로는 충분하지 않음.
- NGINX 로그도 수집하면 공격 유형과 공격 대상 엔드포인트를 파악할 수 있음.
- CPU, 네트워크, 디스크 사용량 등 호스트 서버 메트릭을 수집하면 공격자가 캐시에서 정적 자산만 가져가는지, 서버가 실제로 과부하에 시달려 위험에 처했는지 파악할 수 있음.
- NGINX 뒤쪽의 응답 시간까지 수집하면 공격이 사용자에게 실제 피해를 주는지, 아니면 서버에 거의 영향을 주지 않는지 확인할 수 있음.
- 따라서 팀은 모니터링 아키텍처를 설계할 때 가능한 한 많은 컨텍스트를 확보해야 함.
- 알림 중심 모니터링은 모든 알림이 조사할 가치가 있도록 하는 접근이며, 컨텍스트 기반 모니터링은 모든 알림을 조사할 수 있도록 하는 접근임.
댓글 (0)
로그인하면 이 기사에 내 생각을 남길 수 있어요