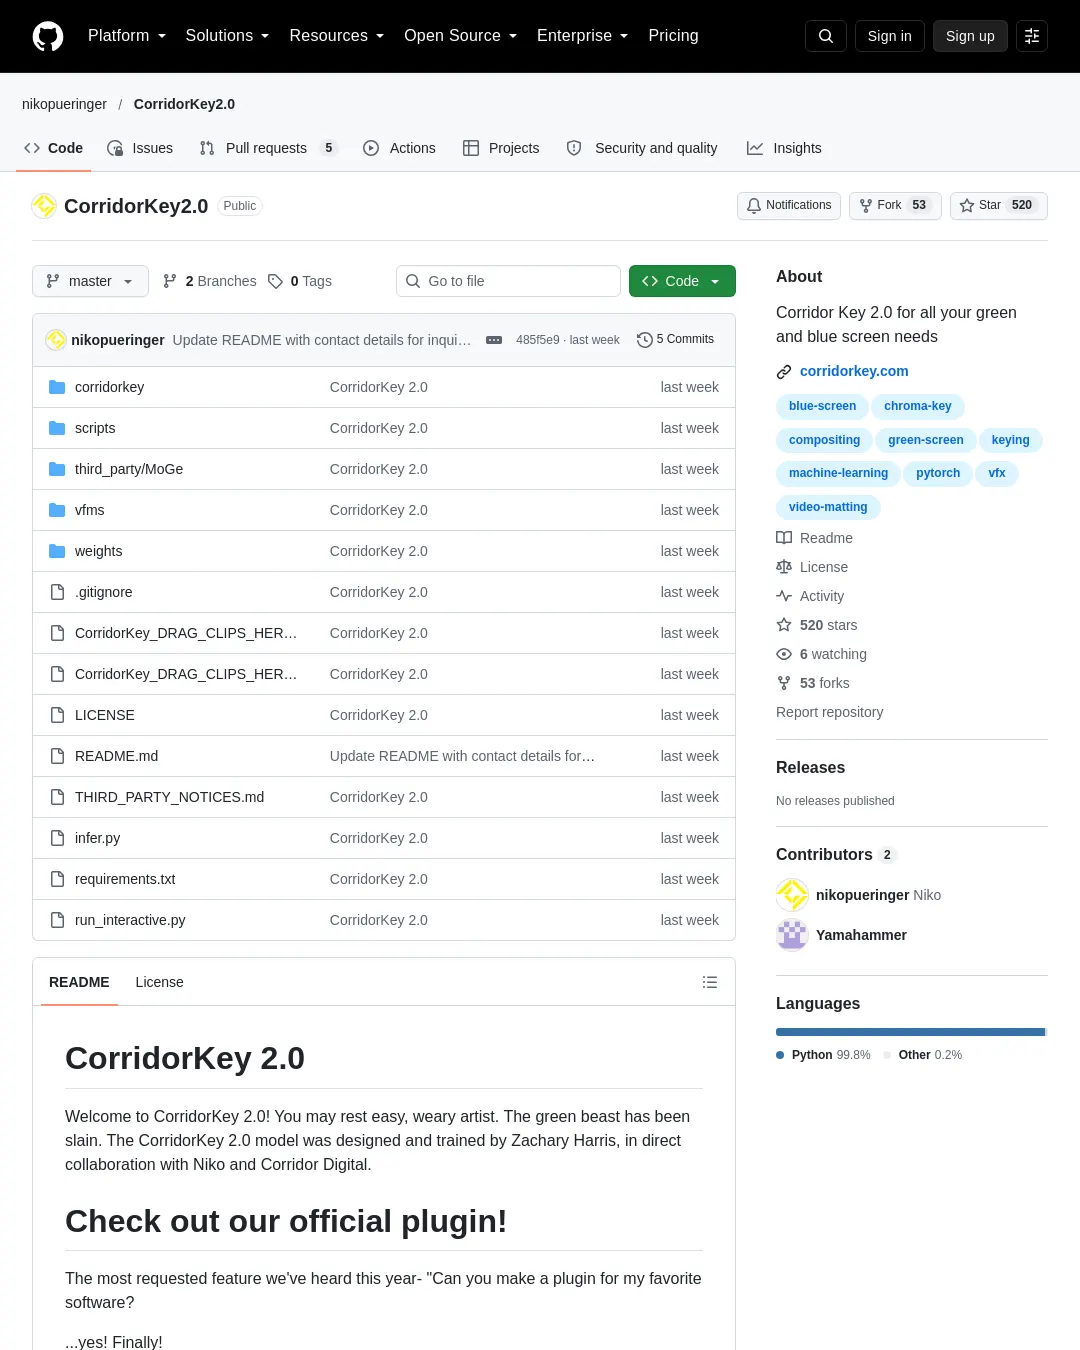
CorridorKey 2.0은 영상에서 피사체와 배경을 분리하는 오픈소스 키잉 도구다. NVIDIA GPU에서 실행하며, 힌트 없이 처리하거나 첫 프레임의 매트 또는 전체 영상의 힌트를 제공해 결과를 조정할 수 있다.
모델은 재커리 해리스(Zachary Harris)가 설계하고 학습했으며 Niko 및 Corridor Digital과 협력해 개발됐다. 저장소에서는 상업적·개인적 작업에 도구와 모델을 사용할 수 있지만, 연 매출 2,000만 달러를 넘는 조직은 사용자별 플러그인 좌석을 구매해야 한다. 도구나 모델을 판매하거나 유료 API·추론 서비스로 제공할 수 없고, 허가 없이 유료 접근을 제공해서도 안 된다. 전체 조건은 LICENSE에 있다.
사용하려면 RTX 30 시리즈 이상 NVIDIA GPU와 최소 4GB VRAM이 필요하다(최대 1440p 기준). 4K 처리에는 6GB가 필요하며, ffmpeg와 CUDA 지원 PyTorch 환경도 갖춰야 한다. 가상 환경을 만든 뒤 의존성과 약 5GB 분량의 모델 가중치를 내려받아 설치한다. 모델은 C-RADIOv4-SO400M, MoGe-2 ViT-B, RVM small을 기반 모델로 사용한다.
입력 영상 옆에 첫 프레임 힌트나 전체 힌트 영상을 두면 실행기가 이를 자동으로 찾는다. 힌트가 없으면 모델이 피사체를 선택하므로 여러 피사체가 있는 장면에서는 의도와 다른 대상을 고를 수 있다. 첫 프레임 힌트는 시작 시 피사체를 지정하고 이후 프레임으로 이어갈 수 있지만, 긴 장면이나 가림이 많은 장면에서는 결과가 드리프트할 수 있다. 전체 힌트 영상은 더 직접적으로 결과를 제어하지만, 힌트 자체의 편향도 결과에 반영될 수 있다.
기본 출력은 알파 매트 미리보기와 전경 영상이다. EXR 이미지 시퀀스로 출력하면 장면 선형 HDR 값을 보존할 수 있다. 일반 동영상 출력은 표시용으로 값이 0~1 범위로 제한되므로 1을 넘는 HDR 값은 보존되지 않는다. 또한 런타임은 ACEScg, Log, PQ·HLG 등 색 공간을 자동 변환하거나 영상의 색상 메타데이터를 활용하지 않는다. 선형 EXR 입력에는 --frame_dir_linear 옵션이 필요하며, 다른 색 공간의 소스는 입력 전에 변환해야 한다.
부록: 원문 예시
python -m venv venv source venv/bin/activate pip install torch==2.9.1 torchvision==0.24.1 --index-url https://download.pytorch.org/whl/cu128 pip install -r requirements.txt python scripts/download_weights.py
댓글 (0)
로그인하면 이 기사에 내 생각을 남길 수 있어요